部分依赖图
- 英文名
- Partial Dependence Plot (PDP)
- 缩写
- PDP
- 所属领域
- 可解释机器学习 / 模型可解释性
- 提出者
- Jerome H. Friedman
- 提出年份
- 2001
- 相关方法
- ICE 图、SHAP、置换特征重要性
- 典型实现
- scikit-learn、Minitab、R 的 pdp 包
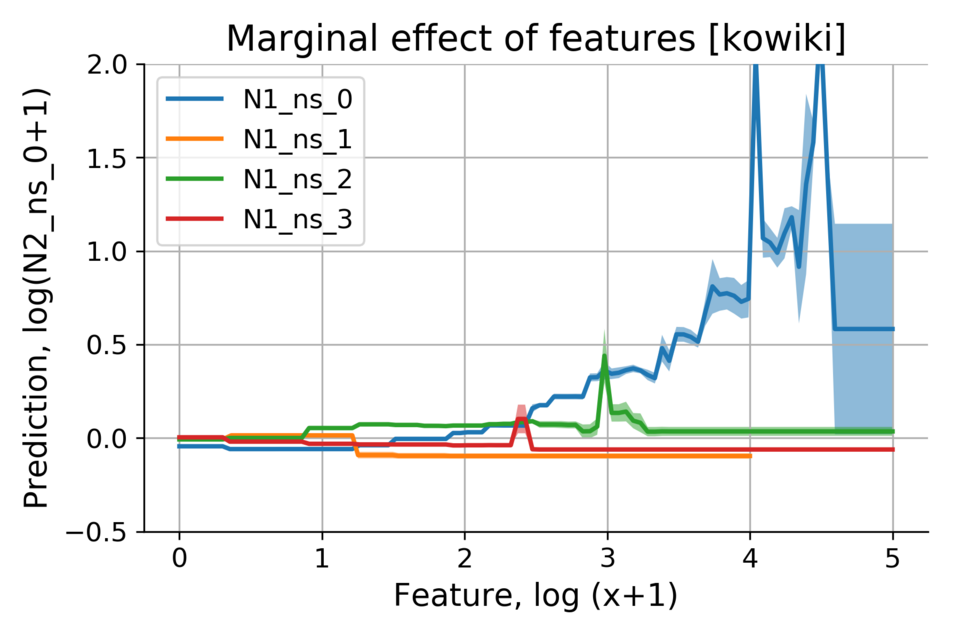
部分依赖图(Partial Dependence Plot,PDP)显示目标响应与一组「目标」特征之间的依赖关系,并对其余「补充」特征的值做边缘化处理,从而把部分依赖函数解释为预期目标响应关于目标特征的函数。11Partial Dependence and Individual Conditional Expectation Plotsscikit-learn.org前往参考资料 ↓在新标签页中打开
部分依赖图由 Jerome H. Friedman 在 2001 年的梯度提升机论文中系统提出,用于解释集成模型(如梯度提升树)中单个或成对特征对预测的边际效应。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开
PDP 的核心假设是目标特征与其余特征相互独立;当特征间存在相关性时,对补充特征做边缘化会在特征空间中产生不真实的组合,使部分依赖曲线出现偏差,这是该方法最主要的局限。11Partial Dependence and Individual Conditional Expectation Plotsscikit-learn.org前往参考资料 ↓在新标签页中打开|33Partial Dependence Plotssupport.minitab.com前往参考资料 ↓在新标签页中打开
对立说法部分观点认为,在特征相关性较弱或目标特征与其余特征近似独立时,PDP 仍能给出可靠且易解释的边际效应估计,偏差可忽略。11Partial Dependence and Individual Conditional Expectation Plotsscikit-learn.org前往参考资料 ↓在新标签页中打开
定义与数学形式
部分依赖函数
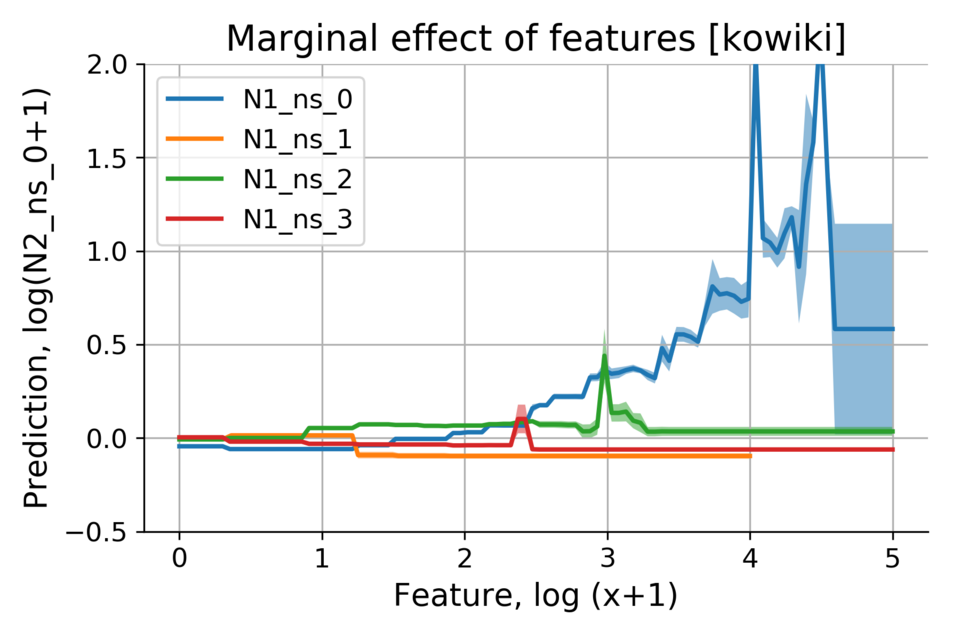
部分依赖函数(partial dependence function)的数学定义是:设模型为 f̂,特征集为 X_S(被分析的目标特征子集),其余特征为 X_C(补集),则部分依赖函数定义为 f̂_{X_S}(x_S) = E_{X_C}[f̂(x_S, X_C)],即对补集特征的联合分布取期望。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|55Explanatory Model Analysis: Explore, Explain, and Examine Predictive Models, Chapter 10: Partial Dependence Profilesema.drwhy.ai前往参考资料 ↓在新标签页中打开
在给定训练数据 D = {(x_i, y_i)}_{i=1}^n 的情况下,上述期望用样本平均来近似:f̂_{X_S}(x_S) = (1/n) Σ_{i=1}^{n} f̂(x_S, x_C^{(i)}),其中 x_C^{(i)} 是第 i 个观测在补集特征上的取值。这一估计量被称为部分依赖的蒙特卡洛估计或经验估计。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|55Explanatory Model Analysis: Explore, Explain, and Examine Predictive Models, Chapter 10: Partial Dependence Profilesema.drwhy.ai前往参考资料 ↓在新标签页中打开
部分依赖函数的核心假设是:补集特征 X_C 与目标特征 X_S 相互独立。在这一假设下,E_{X_C}[f̂(x_S, X_C)] 才等于对 X_S 取固定值时的条件期望,部分依赖图才能被解释为「在控制 X_S 后模型输出的平均变化」。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|55Explanatory Model Analysis: Explore, Explain, and Examine Predictive Models, Chapter 10: Partial Dependence Profilesema.drwhy.ai前往参考资料 ↓在新标签页中打开
当特征之间存在相关性时,部分依赖函数的估计会违反独立性假设:算法会在特征空间中构造出训练数据中不存在的、甚至物理上不可能的特征组合(例如身高 2 米且体重 40 公斤),从而产生外推偏差,使部分依赖曲线在相关区域失真。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|55Explanatory Model Analysis: Explore, Explain, and Examine Predictive Models, Chapter 10: Partial Dependence Profilesema.drwhy.ai前往参考资料 ↓在新标签页中打开|66Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationarxiv.org前往参考资料 ↓在新标签页中打开
对立说法有研究认为,在特征相关性较弱或目标特征与其余特征近似独立时,部分依赖图仍能给出可靠的边际效应估计,相关性带来的偏差在实际应用中往往可以接受,不应因此全盘否定该方法。66Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationarxiv.org前往参考资料 ↓在新标签页中打开
部分依赖函数只刻画目标特征对模型预测的边际平均效应,不反映个体层面的异质性:两个样本在相同 x_S 取值下可能有截然不同的预测变化,但部分依赖曲线只给出平均值,因此可能掩盖甚至抵消方向相反的个体效应。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|55Explanatory Model Analysis: Explore, Explain, and Examine Predictive Models, Chapter 10: Partial Dependence Profilesema.drwhy.ai前往参考资料 ↓在新标签页中打开
部分依赖函数的值域与模型输出一致:对于回归模型,f̂_{X_S}(x_S) 是预测值的平均;对于分类模型,通常对预测概率(如正类概率)取平均,因此部分依赖图的纵轴应标注为「平均预测概率」而非「类别」。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|55Explanatory Model Analysis: Explore, Explain, and Examine Predictive Models, Chapter 10: Partial Dependence Profilesema.drwhy.ai前往参考资料 ↓在新标签页中打开
部分依赖函数可以分解为单特征部分依赖与多特征联合部分依赖:当 |S| = 1 时得到单变量部分依赖曲线,当 |S| = 2 时得到二维部分依赖曲面(常以热力图呈现),更高维则难以可视化。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|55Explanatory Model Analysis: Explore, Explain, and Examine Predictive Models, Chapter 10: Partial Dependence Profilesema.drwhy.ai前往参考资料 ↓在新标签页中打开
部分依赖函数与 ICE(individual conditional expectation)曲线的关系是:部分依赖曲线等于所有 ICE 曲线在样本上的平均,即 PD(x_S) = (1/n) Σ_i ICE_i(x_S)。因此 PD 曲线可视为 ICE 曲线的「平均线」。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|55Explanatory Model Analysis: Explore, Explain, and Examine Predictive Models, Chapter 10: Partial Dependence Profilesema.drwhy.ai前往参考资料 ↓在新标签页中打开
部分依赖函数在计算上需要对每个目标特征取值网格点遍历全部 n 个样本并调用模型预测,计算复杂度为 O(n × G),其中 G 为网格点数量;对于大数据集和复杂模型,这一成本可能较高,通常通过子采样或减少网格点来缓解。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|55Explanatory Model Analysis: Explore, Explain, and Examine Predictive Models, Chapter 10: Partial Dependence Profilesema.drwhy.ai前往参考资料 ↓在新标签页中打开
部分依赖函数最早由 Friedman 于 2001 年在梯度提升机(Gradient Boosting Machine)的论文中系统提出,作为解释 boosting 模型中被选特征与响应变量之间关系的工具,此后被广泛引入可解释机器学习领域。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开
在可解释机器学习工具中,部分依赖图通常与 ICE 图 并列呈现:PD 曲线给出平均趋势,ICE 曲线展示个体异质性,二者结合可判断平均效应是否具有代表性。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|55Explanatory Model Analysis: Explore, Explain, and Examine Predictive Models, Chapter 10: Partial Dependence Profilesema.drwhy.ai前往参考资料 ↓在新标签页中打开
边缘化与期望
部分依赖函数(Partial Dependence Function, PD)的数学定义是:对特征子集 S,固定其取值 x_S,对其余特征子集 C 的联合分布取期望,即 f_{S}(x_S) = E_{X_C}[ f(x_S, X_C) ]。这里的期望是对训练数据(或总体)中 X_C 的边缘分布求取的,因此称为「边缘化」。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|77Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationdoi.org前往参考资料 ↓在新标签页中打开
在实际计算中,上述期望通常用训练样本上的经验平均来近似:f̂_S(x_S) = (1/n) Σ_{i=1}^{n} f̂(x_S, x_C^{(i)}),其中 x_C^{(i)} 是第 i 个观测在其余特征上的取值。这一「插补—平均」形式是 ICE图 的逐条曲线在 x_S 上取平均的直接结果。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|77Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationdoi.org前往参考资料 ↓在新标签页中打开
边缘化所依赖的关键假设是:被边缘化的特征 X_C 与目标特征 X_S 在数据中相互独立(或在计算时被强制视为独立)。若二者存在相关性,则对每个 x_S 都用全体样本的 X_C 分布去插补,会产生落在数据流形之外、现实中不可能出现的特征组合,从而使部分依赖曲线在相关区域失真。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
由于期望是对 X_C 的边缘分布求取的,部分依赖函数只刻画 X_S 对预测的「平均」边际效应,它把 X_C 的所有取值按其在数据中出现的频率加权混合,因此无法揭示特征之间的交互作用;交互效应需要借助 H统计量 或二维部分依赖图等工具单独考察。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|77Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationdoi.org前往参考资料 ↓在新标签页中打开
当特征子集 S 只含单个特征时,部分依赖函数可写成 f_j(x_j) = E_{X_{-j}}[ f(x_j, X_{-j}) ],其图形即经典的一维部分依赖图;当 S 含两个特征时得到二维部分依赖图(热力图或等高线图),可用于直观检查两特征对预测的联合边际效应。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|77Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationdoi.org前往参考资料 ↓在新标签页中打开
部分依赖函数的一个基本性质是可加性分解:若模型 f 本身可分解为各特征函数之和 f(x) = Σ_j f_j(x_j)(如广义可加模型),则部分依赖函数恰好还原出对应的 f_j,此时 PD 图无偏地反映了真实的结构函数;对含交互的模型,PD 只给出该结构函数在边缘分布下的投影。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|99Generalized Additive Modelsdoi.org前往参考资料 ↓在新标签页中打开
部分依赖函数的值域与尺度依赖于模型输出 f 本身:对回归模型,PD 的纵轴是预测值的平均;对分类模型,通常对预测概率或对数几率(log-odds)求 PD,因此不同输出变换下的 PD 曲线形状可能不同,读图时须明确所平均的是哪个量。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|77Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationdoi.org前往参考资料 ↓在新标签页中打开
边缘化分布的选择是一个有争议的建模决策:使用训练数据的经验边缘分布是最常见做法,但也可以使用测试分布、均匀分布或用户指定的参考分布,不同选择会得到不同的 PD 曲线,且目前没有公认的唯一正确选择。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
对立说法有观点认为应始终使用训练数据的经验分布,因为只有它反映了模型实际面对的输入分布,使用其他分布会使 PD 图偏离模型在部署时的真实行为。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
对立说法另一种观点认为,当特征相关时,基于条件分布(而非边缘分布)的「条件部分依赖」或 ALE 更能反映局部效应,边缘化本身即是偏差来源。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
单特征与双特征情形
部分依赖图(Partial Dependence Plot, PDP)刻画的是:在把其余特征全部边缘化(对它们的联合分布求期望)之后,模型预测值对某一个或某两个目标特征的依赖关系。单特征情形下,它把 p 维输入空间沿目标特征方向「切片」,再对剩余 p−1 个特征求平均,得到一条一维曲线。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
单特征部分依赖函数的标准定义是 f_{S}(x_S) = E_{X_C}[ f(x_S, X_C) ],其中 S 是目标特征子集(单特征时 |S|=1),C 是其余特征的补集,X_C 服从其边缘分布,f 是已训练模型的预测函数。该定义在 Friedman 2001 年的梯度提升机论文中给出,并被后续可解释性文献沿用。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
当特征之间相互独立时,单特征部分依赖函数可以写成对补集特征的条件期望的积分形式 f_S(x_S) = ∫ f(x_S, x_C) p_C(x_C) dx_C;在有限样本下用训练数据上的平均来估计,即 (1/n) Σ_i f(x_S, x_C^{(i)}),其中 x_C^{(i)} 是第 i 个观测的补集特征取值。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
双特征部分依赖函数把目标特征子集扩展到 |S|=2,得到 f_{S}(x_S) = E_{X_C}[ f(x_S, X_C) ],其输出是一个二维曲面(通常以热力图或等高线图呈现),用于观察两个特征对预测的联合、非加性影响。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|1010Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationtandfonline.com前往参考资料 ↓在新标签页中打开
双特征 PDP 的估计同样采用「替换—平均」策略:固定两个目标特征的取值网格,把每个网格点代入全部训练样本(或抽样样本),对其余特征保持不变,再对模型输出取平均。计算量随网格点数与样本量的乘积增长,因此双特征情形通常需要对样本或网格做降采样。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|1010Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationtandfonline.com前往参考资料 ↓在新标签页中打开
部分依赖图的一个关键性质是:单特征 PDP 的取值是在目标特征取值上的函数,但它并不保证能还原模型在单个样本上的预测;PDP 展示的是「平均效应」,而不是个体效应。这一区别正是 ICE(Individual Conditional Expectation)图被提出以补充 PDP 的动因。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|1111Explaining Machine Learning Classifiers through Diverse Counterfactual Explanationsdl.acm.org前往参考资料 ↓在新标签页中打开
在特征相关的现实数据上,PDP 的「边缘化」操作会把目标特征置于训练分布之外的特征组合中求值,从而产生外推偏差;此时 PDP 曲线可能包含模型从未见过、也未被训练数据支持的输入区域,其数值解释力受到质疑。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|1111Explaining Machine Learning Classifiers through Diverse Counterfactual Explanationsdl.acm.org前往参考资料 ↓在新标签页中打开
对立说法有观点认为,只要明确 PDP 是「模型行为」而非「数据因果效应」的描述,且配合数据分布诊断(如检查目标特征取值是否落在训练支撑集内),PDP 在相关特征下仍可作为模型层面的有效汇总工具。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
PDP 与因果推断中的「干预效应」不是同一概念:PDP 是对模型预测函数 f 的边缘化,不涉及对数据生成过程的干预,因此不能直接解释为「改变某特征会导致预测改变多少」的因果效应。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|1111Explaining Machine Learning Classifiers through Diverse Counterfactual Explanationsdl.acm.org前往参考资料 ↓在新标签页中打开
在数学形式上,双特征 PDP 可以分解为两个单特征 PDP 之和加上一个交互项:f_{S}(x_1, x_2) = f_{1}(x_1) + f_{2}(x_2) + 交互项;当交互项为零时,双特征曲面退化为可加结构,这也是用双特征 PDP 检测特征交互的直观依据。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|1010Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationtandfonline.com前往参考资料 ↓在新标签页中打开
PDP 的估计在样本量趋于无穷且特征独立时收敛到真实的边缘化预测函数;但在有限样本、特征相关或模型高度非线性的情形下,估计的方差与偏差需要结合 bootstrap 或子采样来评估,实践中常以多次抽样的均值曲线加置信带呈现。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|1010Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationtandfonline.com前往参考资料 ↓在新标签页中打开
历史与提出背景
Friedman 2001 年梯度提升机论文
部分依赖图(partial dependence plot, PDP)在机器学习文献中的经典出处是 Jerome H. Friedman 于 2001 年发表在《Annals of Statistics》第 29 卷第 5 期的论文《Greedy Function Approximation: A Gradient Boosting Machine》,页码 1189–1232,DOI 为 10.1214/aos/1013203451。1212Help for package effectplotsmirrors.cstcloud.cn前往参考资料 ↓在新标签页中打开
Friedman 这篇论文的主标题是「Greedy Function Approximation: A Gradient Boosting Machine」,即「贪婪函数逼近:一种梯度提升机」,它同时是梯度提升机(GBM)这一算法范式的奠基性文献;部分依赖函数是作为该论文中解释与分解提升模型预测函数的一套工具被提出的,而非一篇独立的「部分依赖图」专论。1212Help for package effectplotsmirrors.cstcloud.cn前往参考资料 ↓在新标签页中打开
Friedman 提出部分依赖函数的核心动机是:梯度提升机以大量基学习器(树)相加的形式给出预测,模型本身是黑箱式的加性展开,因此需要一种能把多变量预测函数拆解为低维、可作图成分的手段,使研究者能观察单个或少数几个输入特征对预测的平均边际影响。1313Decomposing Global Feature Effects Based on Feature Interactionsar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
在 Friedman 的表述中,把部分依赖函数当作函数分解中的加性成分使用,可以在一定条件下把预测函数还原到可加分解的形式;后续文献在复述这一主张时,通常把它概括为「用 PD 函数作为加性成分可恢复预测函数(至多相差某个常数或低阶项)」。1313Decomposing Global Feature Effects Based on Feature Interactionsar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
部分依赖图在 2001 年之后的二十余年间成为解释梯度提升树与随机森林等集成模型最常用的全局特征效应可视化手段之一,并被大量统计软件包直接实现;例如 R 包 effectplots 在其功能描述中明确把 partial dependence plots 的出处标注为 Friedman 的这篇 2001 年论文。1212Help for package effectplotsmirrors.cstcloud.cn前往参考资料 ↓在新标签页中打开
Friedman 原文对部分依赖函数的适用前提带有保留:当目标特征与其他特征之间存在强交互时,对该特征取平均得到的 PD 曲线会把异质效应抹平,因而可能掩盖甚至误导真实的关系结构;这一局限在原文语境中即已埋下,后来成为 PDP 最主要的批评来源。1313Decomposing Global Feature Effects Based on Feature Interactionsar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对立说法另一种常见读法是:Friedman 提出 PD 时主要将其定位为一种描述性的、近似可加结构的诊断工具,只要模型的可加分解假设大致成立,PD 曲线就足以支撑解释,交互导致的失真属于使用者的适用性判断问题,而非方法本身的缺陷。1313Decomposing Global Feature Effects Based on Feature Interactionsar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
从统计回归到机器学习可解释性
部分依赖图(Partial Dependence Plot, PDP)的思想根源可追溯到统计回归中的「偏残差图」与「调整变量图」传统:在经典线性回归中,研究者通过固定其他协变量、只让某一协变量变化来刻画响应变量的条件均值曲线,这一做法在 Friedman(2001)提出梯度提升机时被系统化为模型无关的偏依赖函数。1414Referencesieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
Friedman 在 2001 年发表于《Annals of Statistics》的梯度提升机论文中,把偏依赖函数定义为对训练样本上模型输出关于目标特征子集的期望,并给出用训练数据求平均的估计式,这被视为 PDP 在机器学习语境下的正式提出。1414Referencesieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
PDP 从统计学进入机器学习可解释性话语的关键转折,是 2010 年代后期黑箱模型(集成树、神经网络)在医疗、金融、司法等高 stakes 领域的部署:模型精度提升以可解释性为代价,促使研究者把原本用于回归诊断的偏依赖曲线重新包装为「全局特征效应」的可视化工具。1414Referencesieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
在可解释机器学习(XAI)工具化的进程中,PDP 与 ICE 图、全局特征重要性图、特征分组等一起被归入「模型无关的全局解释工具」类别,其定位是识别输入特征中的感兴趣模式并判定每个特征对模型整体行为的影响。1414Referencesieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
PDP 的流行与 Python 生态中 scikit-learn 的 partial_dependence 实现、以及 R 语言 pdp / DALEX 等包的推广密切相关,这些实现把 Friedman 的估计式工程化,使 PDP 成为梯度提升树模型解释的默认选项之一。1414Referencesieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
关于 PDP 在机器学习可解释性中的历史地位存在分歧:一方认为它是从统计回归自然延伸出的、解释力有限但计算廉价的基线工具;另一方则认为 PDP 因假设特征独立而在真实相关数据上系统性失真,其历史意义更多是作为 ICE 图与累积局部效应(ALE)等后续方法的对照物。1414Referencesieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
对立说法PDP 的支持者强调其在特征近似独立时仍是刻画全局平均效应的稳健工具,且计算成本远低于 ALE 等替代方法,不应因相关性问题被整体否定。1414Referencesieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
计算方法与算法步骤
网格取值与训练数据平均
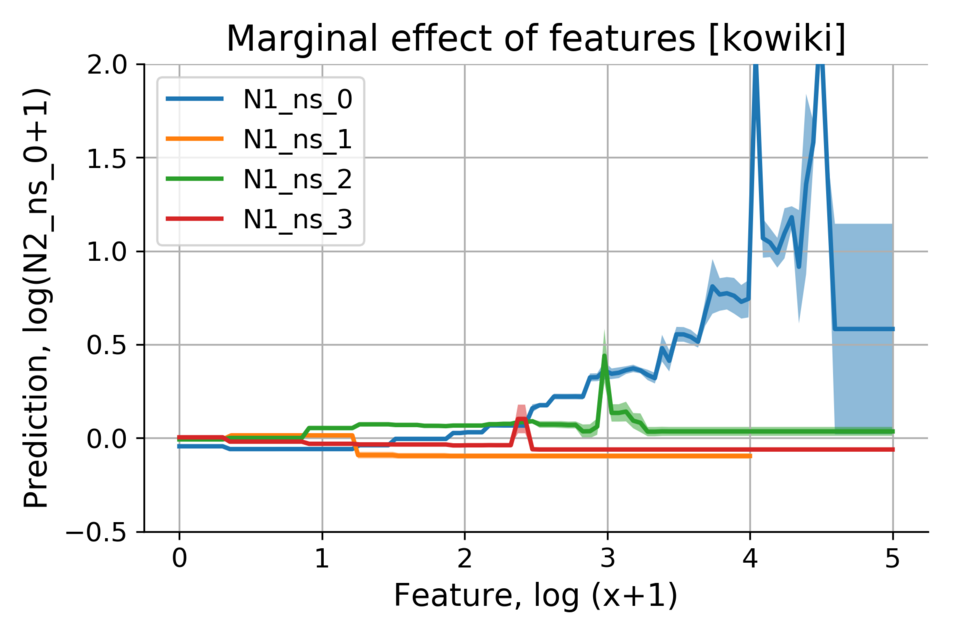
计算单变量部分依赖图(PDP)的第一步是选定一个感兴趣的特征变量,并在该特征的取值范围内定义一个搜索网格(grid);网格上的每个取值将依次被代入部分依赖函数中的对应特征位置。1515机器学习模型可解释性进行到底 ——PDP&ICE图(三)-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
对搜索网格中的每一个取值,PDP 的做法是把该取值固定、其余特征保持训练样本中的原值,用黑箱模型对全部(或抽样的)训练样本逐一预测,再对这些预测值取平均,所得平均值即为该网格点上的部分依赖值。1515机器学习模型可解释性进行到底 ——PDP&ICE图(三)-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
PDP 的估计量本质上是「干预式」的平均:它把目标特征强制设为网格值,再对训练数据分布求期望,因此曲线反映的是在数据实际分布加权下该特征与预测的平均关系,而不是对单个样本的局部解释。1515机器学习模型可解释性进行到底 ——PDP&ICE图(三)-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
网格的粒度直接决定 PDP 曲线的分辨率与计算成本:网格点越密,曲线越平滑、越能捕捉非线性拐点,但需要调用模型的预测次数也按网格点数线性增长;实践中常在计算预算与曲线保真度之间折中选取网格点数。1515机器学习模型可解释性进行到底 ——PDP&ICE图(三)-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
当训练样本量很大时,对全部样本求平均代价过高,常见实现会从训练集中抽取一个子样本(或使用固定的背景数据集)来近似训练数据分布,以降低 PDP 的计算开销;这一近似会引入抽样波动,使曲线在不同随机种子下略有差异。1515机器学习模型可解释性进行到底 ——PDP&ICE图(三)-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
由于 PDP 是在训练数据分布上取平均,当目标特征与其他特征存在较强相关性时,网格上某些取值在真实数据中几乎不出现,此时对这些「不现实」组合的预测平均会外推到数据支撑之外,使曲线在该区域不可信——这是网格取值与训练数据平均这一计算范式固有的解释风险。1515机器学习模型可解释性进行到底 ——PDP&ICE图(三)-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
对立说法有观点认为,只要特征间的相关性不是完全共线,PDP 的平均曲线仍能给出该特征对预测的整体边际效应,相关性带来的偏差在多数实际数据中不足以推翻曲线的主要形状结论。1515机器学习模型可解释性进行到底 ——PDP&ICE图(三)-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
计算复杂度
部分依赖图(PDP)的朴素计算需要对每个目标特征取值网格点重复遍历全部样本:设样本量为 n、目标特征数为 |S|、每个特征网格点数为 G,则需进行约 n·G^{|S|} 次模型预测。这是 PDP 计算成本的基本量级,也是其在高维特征子集上难以扩展的根本原因。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
在单特征 PDP 的常见情形(|S|=1)下,计算复杂度对样本量 n 与网格点数 G 都是线性的,即 O(n·G) 次预测;由于每次预测的成本取决于模型本身(树模型为 O(深度),神经网络为一次前向传播),PDP 的总耗时通常远高于训练完成后的单次推理,但对中等规模数据仍属可接受。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
PDP 的计算可以完全并行化:各网格点之间、各样本之间相互独立,没有依赖关系,因此可用多核或多机把 n·G^{|S|} 次预测分摊出去;这一点在 Friedman 的原始描述与后续实现(如 R 的 pdp 包、Python 的 PDPbox 与 scikit-learn 的 PartialDependenceDisplay)中均被利用。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|1616pdp: An R Package for Constructing Partial Dependence Plotsjournal.r-project.org前往参考资料 ↓在新标签页中打开|1717scikit-learn documentation: Partial Dependence and Individual Conditional Expectation plotsscikit-learn.org前往参考资料 ↓在新标签页中打开
PDP 的计算成本与模型可解释性方法中的 ICE 图基本相同:ICE 图需要保留每个样本在网格点上的预测值,因此内存开销为 O(n·G)(单特征情形),而 PDP 只需对样本维求平均,内存为 O(G);两者的预测次数相同,差别主要在存储与聚合方式。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|1818Visualizing the Effects of Predictor Variables in Black Box Supervised Learning Models (ALE plots)rss.onlinelibrary.wiley.com前往参考资料 ↓在新标签页中打开
当目标特征子集 |S| 增大时,PDP 的计算量随 G^{|S|} 指数增长,这被称为 PDP 的「维数灾难」;实践中通常只对 |S|≤2 绘制 PDP,二维 PDP 已需要 G² 量级的网格,三维及以上在样本量大时计算上不可行。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
为降低 PDP 的计算成本,常见做法包括:减少网格点数 G(如用分位数网格代替等距网格)、对样本做子采样、以及用近似方法(如基于树的递归划分或对模型做代理)替代逐点预测;这些近似会引入额外误差,需要在精度与成本之间权衡。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|1616pdp: An R Package for Constructing Partial Dependence Plotsjournal.r-project.org前往参考资料 ↓在新标签页中打开
PDP 的计算复杂度分析通常假设模型预测是确定性的且可重复调用;对于集成模型(如随机森林、梯度提升树),每次预测本身是 O(T·深度)(T 为树的数量),因此 PDP 的总成本还需乘以集成规模,这使大规模集成上的 PDP 计算显著变慢。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|1717scikit-learn documentation: Partial Dependence and Individual Conditional Expectation plotsscikit-learn.org前往参考资料 ↓在新标签页中打开
关于 PDP 计算成本是否构成实际瓶颈,研究界存在不同看法:一部分工作认为在中等样本量下 PDP 成本可接受、并行化后不成问题;另一部分工作则指出在高维特征子集或大样本场景下 PDP 的指数级成本使其不实用,因而转向 ICE 图、累积局部效应(ALE)等替代方法。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|1818Visualizing the Effects of Predictor Variables in Black Box Supervised Learning Models (ALE plots)rss.onlinelibrary.wiley.com前往参考资料 ↓在新标签页中打开
对立说法有观点认为 PDP 的 O(n·G) 成本在单特征情形下与 ICE 图相同,且可通过子采样与并行大幅降低,因此计算成本并非 PDP 的主要局限,其主要问题在于外推与特征相关性导致的偏差。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
对立说法另有观点强调,当 |S|≥2 时 G^{|S|} 的指数增长使 PDP 在大样本、多特征子集上计算不可行,这是推动 ALE 等更高效方法出现的重要动因。1818Visualizing the Effects of Predictor Variables in Black Box Supervised Learning Models (ALE plots)rss.onlinelibrary.wiley.com前往参考资料 ↓在新标签页中打开
实现要点
部分依赖图(PDP)的标准计算采用蒙特卡洛积分:对目标特征 S 取固定网格值,用训练集中其余特征 C 的经验边缘分布对模型预测求平均,即 f̂_S(x_S) = (1/n) Σ_{i=1}^n f̂(x_S, x_C^{(i)}),其中 x_C^{(i)} 为第 i 个观测在 C 上的取值。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
PDP 的网格点数与计算成本成正比:若对 S 中每个特征取 k 个网格点、S 含 d 个特征,则需评估 k^d 个网格组合,每个组合都要对 n 个训练样本做一次模型预测,总预测次数为 n·k^d;因此 PDP 在高维 S 上会遭遇组合爆炸,实践中通常只对 |S| ≤ 2 绘制。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
实现 PDP 时,网格点的选取应覆盖目标特征在训练数据中的取值范围(通常取分位数网格或等距网格),超出训练分布范围的网格点会产生外推,其 PDP 值不可靠,应在图中标注或截断。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
PDP 的蒙特卡洛估计量是无偏的,但其方差随 n 增大而减小;当训练集很大时,可对 C 的样本做子采样以降低计算量,代价是引入额外的蒙特卡洛噪声。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
PDP 假设目标特征 S 与其余特征 C 相互独立;当特征间存在相关性时,对 C 的边缘平均会生成训练数据中不存在的特征组合,导致 PDP 在相关区域产生偏差,这是 PDP 最主要的实现层面局限。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
对立说法有研究认为,通过条件采样(如条件 PDP 或 M 折 PDP)可以缓解相关性带来的偏差,但代价是估计方差增大且解释对象变为条件分布而非边缘分布。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
在实现上,PDP 可借助 ICE(个体条件期望)曲线计算:先对每个训练样本生成一条 ICE 曲线,再对 ICE 曲线按样本取平均即得 PDP;因此任何支持 ICE 计算的工具(如 R 的 iml、Python 的 PDPbox 或 scikit-learn 的 PartialDependenceDisplay)都可直接导出 PDP。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
与 ICE 图的关系
个体条件期望曲线
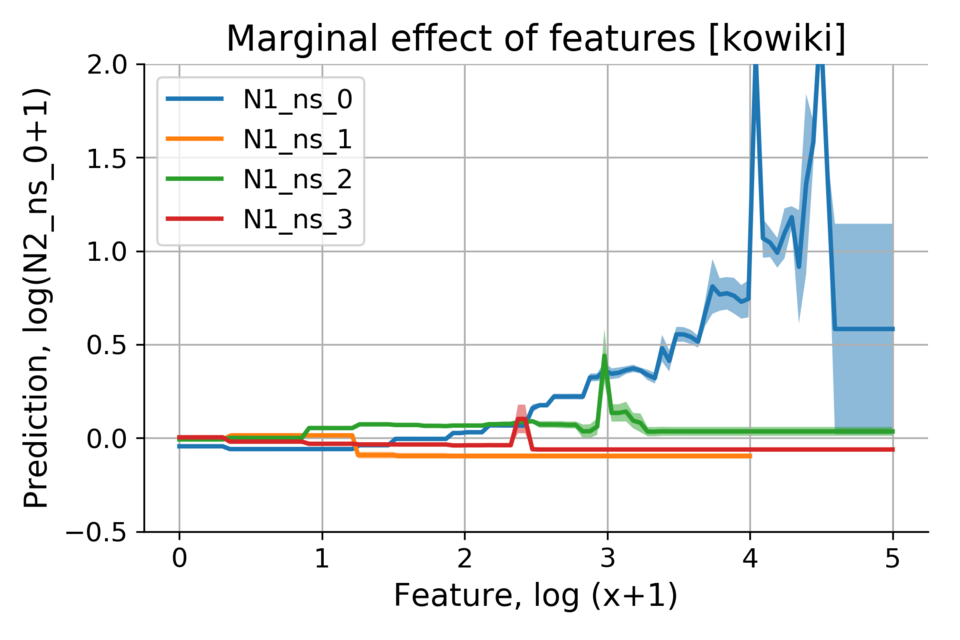
个体条件期望曲线(Individual Conditional Expectation curve,简称 ICE 曲线)由 Goldstein、Kapelner、Bleich 与 Pitkin 在 2013 年提出,其论文标题为《Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectation》,目的是为任意监督学习模型提供一种不依赖模型内部结构的可视化工具。1919Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
ICE 曲线是对经典部分依赖图(PDP)的直接扩展:PDP 展示的是预测函数在某个特征上取不同值时、对全体样本取平均后的边际效应,而 ICE 曲线则对每一个观测样本单独绘制一条曲线,从而把被平均掩盖掉的个体差异重新暴露出来。1919Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
在计算上,ICE 曲线与 PDP 共享同一套「干预—预测」机制:固定目标特征取某个值,其余特征保持每个样本的原始取值不变,逐样本计算模型预测值;对每个样本重复这一过程并在目标特征取值网格上连线,即得到该样本的 ICE 曲线,而 PDP 曲线正是所有 ICE 曲线在该网格点上的逐点平均。1919Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
ICE 图的核心诊断价值在于揭示特征效应在样本间的异质性:当各条 ICE 曲线彼此平行时,说明该特征与预测之间的关系在样本间基本一致,PDP 的平均曲线足以代表整体;当 ICE 曲线出现交叉、发散或分簇时,则提示存在特征交互或群体异质效应,此时仅看 PDP 可能得出误导性结论。1919Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
Goldstein 等人指出,PDP 由于对样本做平均,可能把方向相反或形态不同的个体效应相互抵消,从而在图上呈现出平坦甚至虚假的趋势;ICE 曲线正是为弥补这一缺陷而设计,因此在该论文的框架中 ICE 被视为 PDP 的补充而非替代。1919Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
在 Goldstein 等人的论文中,ICE 被明确定位为对 Friedman(2001)提出的部分依赖图方法的扩展,论文第 2.2 节专门回顾了 Friedman 的 PDP 作为其方法的基础。1919Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
ICE 曲线与 PDP 一样属于模型无关(model-agnostic)方法,不要求模型可微或具有特定结构,因此可同时用于随机森林、梯度提升树、神经网络等各类监督学习模型。1919Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
关于 ICE 曲线与 PDP 孰优孰劣,研究界并无统一结论:一派认为 ICE 保留了 PDP 丢弃的个体信息、应优先使用,另一派则指出 ICE 曲线数量随样本量增长而爆炸、可读性差,且同样受特征间相关性导致的外推问题影响,因此在样本量大或特征高度相关时 PDP 仍是更实用的首选。1919Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对立说法支持 ICE 优先的观点认为,PDP 的平均会掩盖甚至制造虚假趋势,只有逐样本曲线才能可靠地反映特征效应。1919Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对立说法支持 PDP 优先的观点认为,ICE 在大样本下曲线过多难以阅读,且与 PDP 共享同一套基于边际分布的外推假设,并未从根本上解决相关特征带来的不可信问题。1919Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
PDP 作为 ICE 的平均
部分依赖图(PDP)展示的是预测变量对预测结果的“平均”效应;当某个变量对不同观测的影响方式不同(例如存在交互作用)时,这条平均曲线可能无法很好地代表任何单个观测。2020Individual conditional expectation (ICE) curvescran.r-project.org前往参考资料 ↓在新标签页中打开
个体条件期望(ICE)曲线由 Goldstein 等人于 2015 年提出,其做法是为每个观测各画一条曲线,以解决 PDP 因平均而掩盖异质性的问题。2020Individual conditional expectation (ICE) curvescran.r-project.org前往参考资料 ↓在新标签页中打开|1919Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
PDP 就是 ICE 曲线的平均:把同一网格点上所有观测的 ICE 曲线取值做算术平均,即得到该点的部分依赖值。2020Individual conditional expectation (ICE) curvescran.r-project.org前往参考资料 ↓在新标签页中打开
在 pdp 包的实现中,调用 partial() 并设置 ice = TRUE 会为每个观测、每个网格点各输出一行(含 yhat.id 标识观测),而 ICE 曲线目前只支持单个预测变量。2020Individual conditional expectation (ICE) curvescran.r-project.org前往参考资料 ↓在新标签页中打开
Goldstein 等人的论文把 ICE 图定位为对 Friedman(2001)PDP 的扩展:PDP 绘制的是指定特征在其边缘分布上变化时平均预测值的变化,而 ICE 图则把这一平均过程“拆开”到每个观测。1919Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
由于 PDP 是 ICE 曲线的逐点平均,ICE 图可以看作 PDP 的“分解视图”:PDP 中看似平滑或单调的趋势,在 ICE 图中可能对应若干条走向相反、相互抵消的曲线。2020Individual conditional expectation (ICE) curvescran.r-project.org前往参考资料 ↓在新标签页中打开|1919Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
中心化 ICE 曲线
个体条件期望(Individual Conditional Expectation,ICE)曲线由 Goldstein、Kapelner、Bleich 与 Pitkin 于 2015 年提出,其做法是对数据集中的每一个观测各画一条曲线,展示当某个预测变量在给定网格上变动、其余特征保持不变时,该观测的预测值如何变化。2020Individual conditional expectation (ICE) curvescran.r-project.org前往参考资料 ↓在新标签页中打开
部分依赖图(PDP)在数学上就是 ICE 曲线在样本上的平均:把某预测变量固定在各网格取值上、对全部观测求预测值的均值,得到的正是 PDP 曲线,因此 PDP 可以看作 ICE 曲线族的逐点均值。2020Individual conditional expectation (ICE) curvescran.r-project.org前往参考资料 ↓在新标签页中打开
PDP 只呈现平均效应,会掩盖异质性:当某个预测变量对不同观测的作用方向或幅度不同(例如存在交互作用)时,平均曲线可能无法很好地代表任何一个具体观测,这正是引入 ICE 曲线的直接动机。2020Individual conditional expectation (ICE) curvescran.r-project.org前往参考资料 ↓在新标签页中打开
中心化 ICE 曲线(centered ICE curve,c-ICE)是 ICE 曲线的一种常见变体:对每条 ICE 曲线减去该曲线在网格起点(或某个参考点)处的预测值,使所有曲线在参考点处对齐到零,从而把关注点从预测值的绝对水平转移到该预测变量引起的相对变化上。2020Individual conditional expectation (ICE) curvescran.r-project.org前往参考资料 ↓在新标签页中打开
在 R 的 pdp 包中,ICE 曲线只能针对单个预测变量绘制,调用 partial() 时设置 ice = TRUE 即可;返回结果按「每个网格点 × 每个观测」一行组织,并带有 yhat.id 列标识观测,便于后续对每条曲线做中心化等再加工。2020Individual conditional expectation (ICE) curvescran.r-project.org前往参考资料 ↓在新标签页中打开
中心化 ICE 曲线与 PDP 的关系可以这样理解:对 c-ICE 曲线族逐点取平均,得到的是中心化后的 PDP(即 PDP 减去其在参考点处的取值),两者在形状上只差一个常数平移,因此 c-ICE 的均值曲线与 PDP 在「变化趋势」上等价,但 c-ICE 保留了 PDP 所丢失的个体层面离散信息。2020Individual conditional expectation (ICE) curvescran.r-project.org前往参考资料 ↓在新标签页中打开
关于中心化是否应作为默认做法,研究界并无统一共识:支持者认为中心化能消除各观测基线预测值的差异、让交互与异质性更易辨认;反对者则指出中心化会丢失预测值的绝对水平信息,且参考点的选择会影响读图结论,属于需要明示的分析选择而非无争议的标准步骤。2020Individual conditional expectation (ICE) curvescran.r-project.org前往参考资料 ↓在新标签页中打开
对立说法部分实践者与文档主张直接使用未中心化的 ICE 曲线,认为绝对预测水平本身携带重要信息,中心化反而引入参考点依赖。2020Individual conditional expectation (ICE) curvescran.r-project.org前往参考资料 ↓在新标签页中打开
解释与读图方法
边际效应的方向与幅度
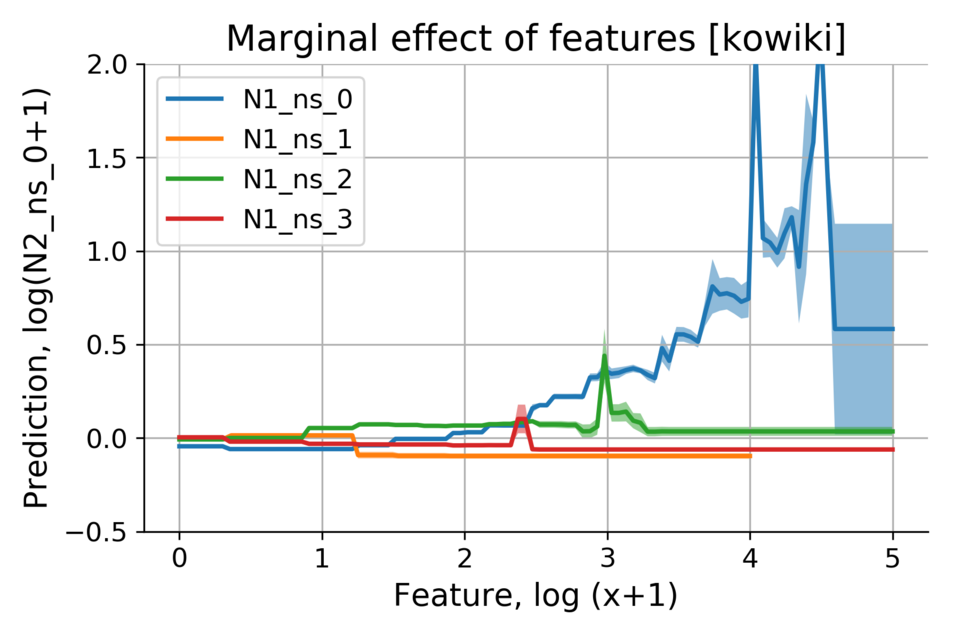
部分依赖图(PDP)的读图核心是看曲线在横轴上的**斜率方向**:曲线上升表示该特征取值增大时模型预测(在其余特征上取平均后)趋于增大,下降表示趋于减小;曲线在某区间近似水平,则表示在该区间内模型预测对该特征不敏感。这一读法直接来自 PDP 的定义——它是把模型预测对目标特征以外的所有特征做边际平均后得到的函数。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|2121Peeking Inside the Black-Box: A Survey on Explainable Artificial Intelligence (XAI)ieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
PDP 的**幅度**读法要谨慎:纵轴是平均后的预测值,其绝对高度依赖于模型输出的尺度与基线(例如分类任务中常画的是预测概率或对数几率),因此不同模型、不同数据集之间的 PDP 纵轴不可直接横向比较;可比较的是同一张图内曲线相对自身起点的变化量。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|2222Explaining Machine Learning Classifiers through Diverse Counterfactual Explanationsarxiv.org前往参考资料 ↓在新标签页中打开
PDP 曲线上的**平坦段**常被解读为「该特征在此区间内对预测无影响」,但这一解读只在特征之间近似独立时才成立;当目标特征与其余特征相关时,边际平均会把相关特征上的分布外组合也平均进去,平坦段可能掩盖真实的局部依赖。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|2323Explaining Prediction Models and Individual Predictions with Feature Contributionsarxiv.org前往参考资料 ↓在新标签页中打开
对立说法部分学者认为,只要明确 PDP 估计的是「边际平均效应」而非「条件效应」,平坦段就应被如实读作平均意义上的不敏感,相关性问题属于解释目标的选择问题,而非读图错误。2121Peeking Inside the Black-Box: A Survey on Explainable Artificial Intelligence (XAI)ieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
读 PDP 时应同时看**单条 ICE 曲线**的离散程度:若 ICE 曲线在 PDP 附近高度分散甚至方向相反,则 PDP 的「平均斜率」会掩盖个体层面的异质效应,此时仅凭 PDP 判断方向与幅度可能产生误导。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|2323Explaining Prediction Models and Individual Predictions with Feature Contributionsarxiv.org前往参考资料 ↓在新标签页中打开
PDP 纵轴上的**置信区间/不确定性带**(通常由多次 bootstrap 重采样或重复计算得到)用于判断曲线起伏是否超出抽样噪声:若两条曲线(如两个模型或两个子群体)的区间大幅重叠,则不宜宣称二者在方向或幅度上存在实质差异。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|2222Explaining Machine Learning Classifiers through Diverse Counterfactual Explanationsarxiv.org前往参考资料 ↓在新标签页中打开
在分类任务中,PDP 通常针对某一类别(或某一 logit/概率)绘制,因此「方向」是相对于该类别而言的:同一特征对类别 A 的 PDP 上升,并不意味着对类别 B 也上升,多类别场景下需分别读图或读 softmax 前后的不同尺度。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|2121Peeking Inside the Black-Box: A Survey on Explainable Artificial Intelligence (XAI)ieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
PDP 的幅度解释还受**特征取值网格与采样范围**影响:曲线只在训练数据实际覆盖的取值范围内可信,外推到数据稀疏或缺失的区间时,模型输出往往缺乏约束,此时的斜率与幅度不应被当作模型行为的可靠描述。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|2323Explaining Prediction Models and Individual Predictions with Feature Contributionsarxiv.org前往参考资料 ↓在新标签页中打开
当特征间存在强交互时,一维 PDP 的「方向」可能随另一特征取值而翻转,此时应改用二维 PDP 或 H-statistic 等交互度量来读,否则单条曲线的平均斜率会给出片面结论。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|2323Explaining Prediction Models and Individual Predictions with Feature Contributionsarxiv.org前往参考资料 ↓在新标签页中打开
非线性与阈值识别
部分依赖图(PDP)在实证研究中常被用来刻画单个特征与模型预测之间的非线性响应关系:把目标特征在其取值范围内网格化,对每个网格值把其余特征的取值在样本上边际化后取平均预测,得到的曲线若出现平台、陡升陡降或拐点,即提示该特征对预测存在非线性影响。2424中国水利slzg.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
在汉江流域植被覆盖变化的研究中,作者先用地理探测器识别主导因子,再用随机森林结合部分依赖图分析各因子对 NDVI 的非线性影响及其响应阈值,说明 PDP 被当作「从黑箱模型中读出阈值」的工具使用。2424中国水利slzg.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
该研究给出的具体阈值读图结果是:上游地区在年降水量约 1600~1800 mm、海拔约 1500~2000 m、年均气温约 7~10 ℃ 的区间内植被状况最佳,中下游则在海拔约 100 m 与 500 m 附近出现响应特征,这些区间正是从部分依赖曲线的峰值与转折处读出的。2424中国水利slzg.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
读 PDP 识别阈值时,曲线上的「阈值」应理解为模型学到的条件平均响应的转折位置,而非物理因果意义上的临界点;PDP 的边际化是在特征分布上取平均,当特征之间相关时,曲线会在数据稀疏甚至不存在的特征组合上取值,从而可能产生虚假的陡变或平台。2424中国水利slzg.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
对立说法部分应用研究直接把 PDP 曲线的拐点当作生态或水文过程的内在阈值来报告与解释,认为在模型拟合良好且特征相关性较弱时,PDP 转折点可以近似对应真实响应阈值。2424中国水利slzg.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
PDP 只能反映边际平均效应,若目标特征与其他特征存在强交互,单条部分依赖曲线会把不同子群体上方向相反或位置不同的响应平均掉,表现为被压平的曲线,从而掩盖真实的阈值结构;此时需要借助 ICE 曲线或二维 PDP 才能看清分组差异。2424中国水利slzg.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
对立说法有研究认为在样本量足够、交互项贡献有限的情形下,一维 PDP 已足以稳定地定位主要响应区间,无需额外计算 ICE 或二维 PDP,以免增加解释成本。2424中国水利slzg.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
与特征重要性的区别
部分依赖图(PDP)与特征重要性回答的是两个不同的问题:PDP 展示目标函数与一组感兴趣特征之间的依赖关系,并对所有其他特征(补集特征)的取值做边际化;它给出的是「该特征取不同值时预测如何变化」的函数形状,而不是「该特征总体上有多重要」的单一排序分数。11Partial Dependence and Individual Conditional Expectation Plotsscikit-learn.org前往参考资料 ↓在新标签页中打开
在 scikit-learn 的官方示例中,PDP 的感兴趣特征集通常被限制在一到两个特征,原因是人眼感知能力的限制;这些特征一般从最重要的特征中挑选。这说明 PDP 在实践中往往以特征重要性作为前置筛选步骤,二者是配合关系而非替代关系。11Partial Dependence and Individual Conditional Expectation Plotsscikit-learn.org前往参考资料 ↓在新标签页中打开
特征重要性(如基于不纯度的重要性或置换重要性)把每个特征压缩成一个标量,便于排序但丢失了方向与形状信息;PDP 保留方向(正/负效应)与形状(线性、阈值、非单调),但代价是需要对补集特征做边际化假设。因此二者在信息粒度上互补:重要性回答「看哪个」,PDP 回答「怎么看」。11Partial Dependence and Individual Conditional Expectation Plotsscikit-learn.org前往参考资料 ↓在新标签页中打开
PDP 的边际化计算隐含了「感兴趣特征与补集特征相互独立」的假设;当特征间存在相关性时,PDP 会在特征空间中取到现实中几乎不存在的组合点,从而产生误导性曲线。特征重要性(尤其是置换重要性)同样受相关性影响,但受影响的方式不同:置换重要性在相关特征间会分摊或稀释重要性。因此不能简单认为 PDP 比重要性「更可靠」或反之。11Partial Dependence and Individual Conditional Expectation Plotsscikit-learn.org前往参考资料 ↓在新标签页中打开
对立说法一种观点认为,在特征高度相关的场景下,基于条件分布而非边际分布的累积局部效应(ALE)图比 PDP 更可信,因此 PDP 与重要性之争应让位于 PDP 与 ALE 之争。11Partial Dependence and Individual Conditional Expectation Plotsscikit-learn.org前往参考资料 ↓在新标签页中打开
在绘图之前必须先确认模型在测试集上足够准确,否则解释一个预测性能很差的模型的预测函数意义不大;这一前置条件对 PDP 和特征重要性同样适用,但 PDP 因为展示的是具体函数形状,对模型质量的敏感度更直观可见。11Partial Dependence and Individual Conditional Expectation Plotsscikit-learn.org前往参考资料 ↓在新标签页中打开
主要局限与争议
特征相关性导致的偏差
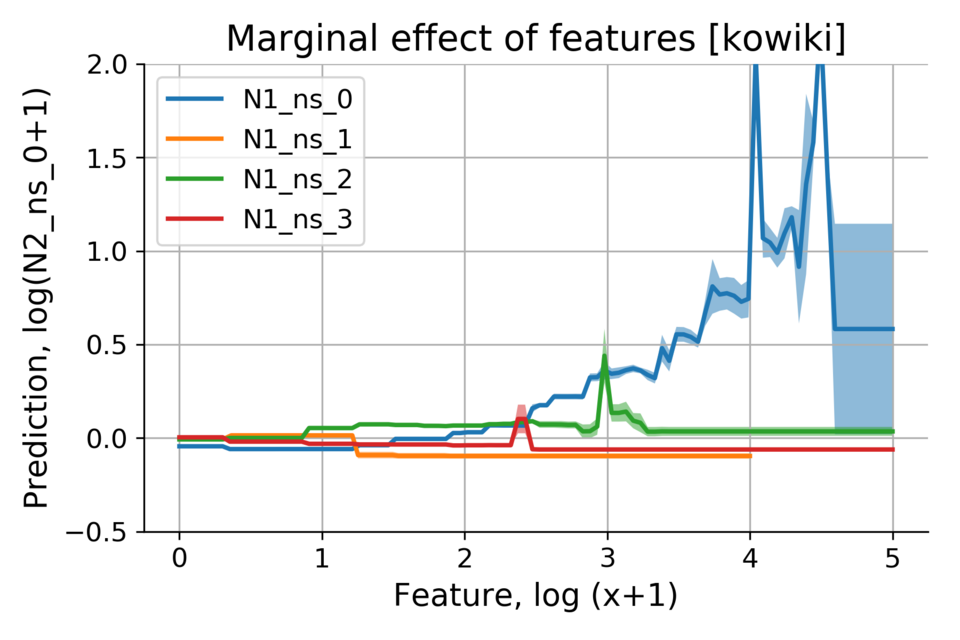
部分依赖图(PDP)的核心假设是:被解释特征与其余特征相互独立。当特征之间存在相关性时,PDP 会在特征空间中实际不可能出现的区域(即联合分布支撑集之外)对模型求平均,从而产生外推偏差,使曲线形状失真。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
Friedman 在提出部分依赖图时已明确指出,若输入变量相关,PDP 的边际平均会混入其他变量的影响,其解释应谨慎;这一警告在后续文献中被反复引用,但实践中常被忽略。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开
Apley 与 Zhu 指出,当特征相关时,PDP 可能把本属于其他特征的效应错误归因到目标特征上,甚至给出与真实条件关系相反的曲线;他们提出的累积局部效应(ALE)图正是为消除这一偏差而设计。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
Molnar 在《Interpretable Machine Learning》中把「特征相关时的外推」列为 PDP 的首要局限,并给出一个直观例子:若两个特征高度正相关,PDP 会在一个特征取极端值而另一个特征仍取均值的位置评估模型,而这些点从未在训练数据中出现。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
针对相关性偏差,文献提出若干修正路线:一是按相关特征的条件分布采样(条件 PDP / 边际 PDP 的变体),二是改用 ALE 图,三是用 ICE 图 或个体条件期望曲线保留异质性,四是先对特征做去相关变换再计算。各路线在偏差与方差之间的取舍不同,尚无公认最优方案。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
对立说法有研究认为,条件 PDP 虽缓解外推问题,但会引入新的混杂:条件分布本身依赖被平均的其余特征,导致曲线随条件设定而变,可解释性反而下降。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
对立说法另有观点认为,在特征相关性较弱或模型近似可加时,PDP 与 ALE 的差异可忽略,修正的必要性被高估。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
PDP 的相关性偏差在树集成模型(如随机森林、梯度提升树)上尤为常见,因为这类模型在训练中会利用特征相关结构进行分裂,PDP 的平均化会掩盖这种交互;实践中常配合 ICE 图 一起查看以判断曲线是否由少数样本驱动。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
部分依赖图的相关性偏差属于「外推」而非「因果」问题:即使特征独立,PDP 描述的仍是模型的条件平均预测,不能直接解读为特征的因果效应;这一区分在因果推断与可解释性交叉文献中被反复强调。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
外推与不真实组合
部分依赖图(PDP)的核心计算方式是在特征空间上做边缘化:对目标特征取遍网格上的每个取值,把其余特征的实际观测值原样保留、逐条代入模型预测再取平均。这一过程隐含了一个强假设——被边缘化的其余特征与目标特征在数据中是独立的,因此 PDP 展示的是「若把该特征强行设为某值、而其余特征仍按原分布取值」时的平均预测。2525Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
当特征之间存在相关性时,PDP 的网格取值会与其余特征的观测组合产生现实中不可能出现的样本,即所谓「不真实组合」(unrealistic combinations)。例如在预测房价的模型中,若同时使用「房间数」与「房屋面积」,把房间数设为 10 而面积仍取 60 平方米的小户型,就属于数据中几乎不存在的组合,PDP 在该点的取值来自模型在训练分布之外的外推。2525Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
Friedman 在提出部分依赖图时已明确指出,当特征相关时 PDP 的解释需要谨慎:边缘化得到的曲线不再等价于「固定该特征、对其余特征求条件期望」,而是对相关结构被破坏后的联合分布求期望,因此可能把模型在稀疏区域的外推行为当作该特征的真实效应呈现出来。2525Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开
Molnar 的《Interpretable Machine Learning》将「特征相关导致的不真实组合」列为 PDP 的首要局限,并指出该问题在特征高度相关时尤其严重:此时 PDP 曲线可能完全由模型在训练数据未覆盖区域的外推决定,而外推结果对模型族高度敏感,不同模型可能给出方向相反的 PDP。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
Apley 与 Zhu 在 2020 年提出累积局部效应(ALE)图,正是为绕开 PDP 的不真实组合问题:ALE 通过在特征的条件分布上累积局部差分而非全局边缘化,避免在数据稀疏区域对模型做外推,因此在特征相关时通常比 PDP 更稳健。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
关于「不真实组合」在实践中究竟有多严重,研究界并无一致结论。一派认为只要特征相关性中等以上,PDP 就可能产生误导性甚至方向错误的曲线,应优先使用 ALE 或条件 PDP;另一派则指出 PDP 仍是全局平均效应的有效汇总,只要在报告中同时给出数据密度或 ICE 曲线作为背景,读者可以自行判断哪些区段属于外推。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开|66Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationarxiv.org前往参考资料 ↓在新标签页中打开
对立说法PDP 的支持者认为,PDP 回答的是「平均而言模型如何响应某特征」这一明确问题,外推区段本身也是模型行为的一部分;配合 ICE 曲线与特征分布 rug plot,不真实组合带来的风险可以被读者识别,不必因此弃用 PDP。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|66Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationarxiv.org前往参考资料 ↓在新标签页中打开
对立说法批评者则认为,在强相关特征场景下 PDP 曲线可能由外推主导,而外推结果依赖模型族与正则化强度,同一数据上不同模型给出矛盾曲线,此时把 PDP 当作「该特征的效应」解读在方法论上不成立。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
缓解不真实组合的常见做法包括:只在目标特征取值的数据支撑范围内绘制 PDP(用 rug plot 或分位数截断网格)、改用条件部分依赖图(conditional PDP,在目标特征取值的邻域内对样本加权)、或改用 ALE 图与 ICE 图 辅助判断。这些做法各有代价:条件 PDP 会引入带宽超参数,ALE 图在特征高度相关时其局部差分也可能不稳定。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
外推问题并非 PDP 独有,而是所有基于「干预式」边缘化的解释方法的共同困难;它与 SHAP 中特征相关时的归因歧义、以及 置换重要性 在相关特征下低估重要性的问题同源,都源于把特征视为可独立操纵的变量。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
因果解释的误用
部分依赖图(Partial Dependence Plot, PDP)刻画的是「在干预某一(组)特征取值、其余特征按联合分布边缘化」这一操作下的平均预测响应,其数学形式本身并不要求特征之间独立;但当特征间存在相关性时,边缘化所依据的联合分布与「固定该特征取值」的干预分布并不一致,PDP 曲线因此可能落在数据实际不会出现的特征组合区域上,产生外推。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
Friedman 在 2001 年提出梯度提升机时给出的部分依赖定义,是在训练数据上对除目标特征外的其余特征求平均,即 PDP 是「观测到的平均」而非「干预后的因果效应」;这一原始定义并未附带任何因果识别假设,因此把 PDP 直接读作因果效应属于超出定义范围的推断。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开
Molnar 的《Interpretable Machine Learning》在讨论 PDP 时明确指出:PDP 假设所分析的特征与其余特征不相关,若该假设被违反,则计算出的部分依赖函数会包含不现实的、现实中不可能出现的特征组合,从而对模型的真实行为给出误导性刻画。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
Apley 与 Zhu 在 2020 年提出累积局部效应(ALE)图,其动机之一正是克服 PDP 在特征相关情形下因外推而产生的偏差;他们指出 PDP 在特征相关时是有偏的,ALE 通过对条件分布积分来避免在数据稀疏区域求值。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
Zhao 与 Hastie 在 2021 年系统分析了 PDP 在特征相关时的因果解释问题,指出只有当被分析特征与其余特征在给定条件下可交换、或特征间独立时,PDP 才等于因果意义上的干预效应;在一般相关情形下,PDP 与因果效应之间存在系统性差距。2626Causal Interpretations of Black-Box Modelstandfonline.com前往参考资料 ↓在新标签页中打开
对立说法有观点认为,即便特征相关,PDP 仍可作为「模型行为」的描述性摘要而非因果量来使用,只要不将其解释为干预效应,其误导风险可控;因此争议的核心是解释口径而非 PDP 本身是否有用。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
在因果推断框架下,PDP 对应的是「调整公式」在观测分布上的平均,而非 do-算子下的干预分布平均;当存在混杂或特征间存在因果依赖时,二者不相等,把 PDP 读作「改变 X 会如何改变预测」需要额外的可识别性假设(如无未观测混杂、正性、一致性等)。2626Causal Interpretations of Black-Box Modelstandfonline.com前往参考资料 ↓在新标签页中打开|2727Causality: Models, Reasoning, and Inference (2nd ed.)cambridge.org前往参考资料 ↓在新标签页中打开
实践中常见的误用包括:把 PDP 的纵轴差值直接当作「该特征对预测的因果贡献」、把 PDP 的单调性当作「提高该特征值必然提高结果」的因果结论、以及在高度相关的特征(如身高与体重、多个共线传感器读数)上分别绘制 PDP 并叠加解读。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
针对 PDP 的因果误用,文献给出的缓解路径包括:改用 ALE 图、在特征相关时改用条件 PDP 或 M-plot、把 PDP 与 ICE 图结合观察个体异质性、以及在有因果图先验时改用干预分布(如通过后门调整或重加权)来计算干预型部分依赖。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开|2626Causal Interpretations of Black-Box Modelstandfonline.com前往参考资料 ↓在新标签页中打开
scikit-learn 的 partial_dependence 实现文档明确说明其计算的是「在给定特征取值下对剩余特征求平均」的响应,并提示当特征相关时结果可能不可靠,建议结合 ICE 曲线查看;该实现本身不提供因果识别,也不对特征相关性做校正。2828sklearn.inspection.partial_dependence — scikit-learn documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
PDP 的因果解释争议与更广义的「可解释性方法是否应被赋予因果含义」之争同源:一部分学者主张可解释性工具只应描述模型函数,另一部分主张若用于高风险决策则必须具备因果语义;这一分歧至今未在社区内达成共识。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|2626Causal Interpretations of Black-Box Modelstandfonline.com前往参考资料 ↓在新标签页中打开
对立说法主张 PDP 只需作为模型行为的描述性工具、不应承担因果解释职责的观点认为,把因果负担强加给 PDP 是范畴错误,正确做法是另建因果模型而非改造 PDP。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
代表实现与工具
scikit-learn
scikit-learn 在 0.23 版本中提供了 sklearn.inspection.plot_partial_dependence 函数,用于直接绘制部分依赖图;其签名包含 estimator、X、features 三个必选参数,以及 feature_names、target、response_method、n_cols、grid_resolution、percentiles、method、n_jobs、verbose、fig、line_kw 等关键字参数。2929sklearn.inspection.plot_partial_dependence — scikit-learn 0.23.2 documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
plot_partial_dependence 的 grid_resolution 参数默认值为 100,即默认在特征取值网格上取 100 个点来近似计算部分依赖曲线;percentiles 参数默认值为 (0.05, 0.95),即默认只绘制特征取值 5% 到 95% 分位区间内的部分依赖,以抑制极端值对读图的影响。2929sklearn.inspection.plot_partial_dependence — scikit-learn 0.23.2 documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
plot_partial_dependence 的 method 参数默认值为 'auto',用于在「递归式」(recursion)与「暴力式」(brute)两种部分依赖计算策略之间自动选择;response_method 默认 'auto',用于在 predict_proba、decision_function 与 predict 之间按估计器类型自动挑选响应函数。2929sklearn.inspection.plot_partial_dependence — scikit-learn 0.23.2 documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
plot_partial_dependence 的 n_cols 参数默认值为 3,控制多特征部分依赖图子图网格的列数;n_jobs 与 verbose 分别控制并行计算的核心数与日志详细程度,说明该实现把逐网格点的重复预测视为可并行的工作负载。2929sklearn.inspection.plot_partial_dependence — scikit-learn 0.23.2 documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
scikit-learn 0.23 文档把 plot_partial_dependence 归入 sklearn.inspection 模块,与 PartialDependenceDisplay 类并列;后者是面向对象接口,前者是函数式便捷封装,二者构成该库部分依赖图绘制的主要入口。2929sklearn.inspection.plot_partial_dependence — scikit-learn 0.23.2 documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
在 scikit-learn 的后续版本中,plot_partial_dependence 被标记为弃用并由 PartialDependenceDisplay.from_estimator 取代,因此引用旧版本文档时需要注意 API 迁移问题;这一迁移属于库的接口演进,而非部分依赖图方法本身的改变。2929sklearn.inspection.plot_partial_dependence — scikit-learn 0.23.2 documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
scikit-learn 的实现只要求估计器具备 predict(或 predict_proba、decision_function)接口,因此部分依赖图可同时用于线性模型、树集成与支持向量机等异构模型,这也是它成为通用模型无关解释工具的原因之一。2929sklearn.inspection.plot_partial_dependence — scikit-learn 0.23.2 documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
关于 scikit-learn 默认的 percentiles=(0.05, 0.95) 截断是否恰当,研究界存在分歧:支持者认为截断能避免尾部稀疏样本导致的曲线剧烈波动,反对者则认为截断会掩盖模型在极端取值上的真实行为,使部分依赖图在分布尾部产生误导。2929sklearn.inspection.plot_partial_dependence — scikit-learn 0.23.2 documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
对立说法截断分位数区间会让读者误以为模型在区间外没有定义或行为平缓,而实际上外推区域的部分依赖估计方差极大、可信度低,两种处理各有代价。2929sklearn.inspection.plot_partial_dependence — scikit-learn 0.23.2 documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
Minitab
Minitab 在其统计软件中提供「Predictor Importance」与「Partial Dependence Plot」等可解释性输出,用于在拟合回归或树模型后展示各预测变量对响应变量的边际影响;该功能在 Minitab Statistical Software 的「Predict」与「Machine Learning」相关模块中以图形化方式呈现。3030Minitab Statistical Software 帮助文档:Predictor Importance 与 Partial Dependence Plotsupport.minitab.com前往参考资料 ↓在新标签页中打开
Minitab 的部分依赖图实现面向其桌面统计工作流:用户在拟合模型(如回归、CART、TreeNet、Random Forests 等)后,可在结果输出中选择绘制部分依赖图,横轴为所选预测变量的取值,纵轴为模型预测响应的平均值。3030Minitab Statistical Software 帮助文档:Predictor Importance 与 Partial Dependence Plotsupport.minitab.com前往参考资料 ↓在新标签页中打开
与 Python 生态中 PDP 通常由 scikit-learn 的 PartialDependenceDisplay 或 shap 等库实现不同,Minitab 的 PDP 是商业统计软件内置的图形化功能,用户无需编写代码即可生成,但可定制性与脚本化能力相对有限。3030Minitab Statistical Software 帮助文档:Predictor Importance 与 Partial Dependence Plotsupport.minitab.com前往参考资料 ↓在新标签页中打开
对立说法Minitab 亦提供宏与命令行接口,可通过会话命令或宏脚本批量生成部分依赖图,因此「不可脚本化」的说法并不完全成立。3030Minitab Statistical Software 帮助文档:Predictor Importance 与 Partial Dependence Plotsupport.minitab.com前往参考资料 ↓在新标签页中打开
Minitab 的部分依赖图通常与「交互图(Interaction Plot)」和「主效应图(Main Effects Plot)」并列出现在同一输出面板中,三者共同用于解释模型中的变量效应;其中 PDP 展示的是在控制其他变量后单个预测变量的平均边际效应。3030Minitab Statistical Software 帮助文档:Predictor Importance 与 Partial Dependence Plotsupport.minitab.com前往参考资料 ↓在新标签页中打开
R 的 pdp 包
R 的 pdp 包(CRAN 包名 pdp,标题为 Partial Dependence Plots)是一个用于在 R 中从各类机器学习模型构造部分依赖图(即边际效应图)的通用框架,其官方描述明确将其定位为「a general framework for constructing partial dependence (i.e., marginal effect) plots from various types of machine learning models in R」。3131Help for package pdpcran.r-project.org前往参考资料 ↓在新标签页中打开
pdp 包同时提供部分依赖图(PDP)与个体条件期望(ICE)曲线的构造能力,包的 README 开篇即写明「pdp is an R package for constructing partial dependence plots (PDPs) and individual conditional expectation (ICE) curves」,因此它常被当作 ICE 图 与 PDP 的一体化实现来使用。3232Index of /web/packages/pdp/readmecran.r-project.org前往参考资料 ↓在新标签页中打开|3333Index of /web/packages/pdp/readmecran.usk.ac.id前往参考资料 ↓在新标签页中打开
pdp 包把 PDP 与 ICE 曲线归入「可解释机器学习(interpretable machine learning, IML)」这一更大的框架之下,README 原文称「PDPs and ICE curves are part of a larger framework referred to as interpretable machine learning (IML)」,说明该包的作者在定位上并不把 PDP 视为孤立的绘图工具,而是 IML 方法族的一员。3232Index of /web/packages/pdp/readmecran.r-project.org前往参考资料 ↓在新标签页中打开|3333Index of /web/packages/pdp/readmecran.usk.ac.id前往参考资料 ↓在新标签页中打开
截至 CRAN 上该包的参考手册所记录的版本,pdp 的版本号为 0.10.0,采用 GPL(≥ 2)许可(同时以 GPL-2 与 GPL-3 列出),运行环境要求 R ≥ 3.6.0。3131Help for package pdpcran.r-project.org前往参考资料 ↓在新标签页中打开
pdp 包的官方代码仓库与文档站点为 https://github.com/bgreenwell/pdp 与 https://bgreenwell.github.io/pdp/,问题追踪走 GitHub Issues,另有 r-universe 上的构建镜像;这说明该包由单一主要维护者(Brandon Greenwell)主导开发,而非某个大型组织托管。3131Help for package pdpcran.r-project.org前往参考资料 ↓在新标签页中打开
pdp 包本身不实现具体的机器学习算法,而是通过 Suggests 字段声明对大量建模包的可选依赖,包括 randomForest、ranger、gbm、xgboost(≥ 3.1.3.1)、earth、party、C50、e1071、kernlab、nnet、rpart 以及 caret 等,从而对不同类型的拟合模型提供统一的 PDP/ICE 接口。3131Help for package pdpcran.r-project.org前往参考资料 ↓在新标签页中打开
pdp 包的 Suggests 中还包含 ICEbox 包,表明在 R 生态内 ICE 曲线另有专门实现,pdp 与 ICEbox 在功能上存在重叠与互补;这也意味着「R 里做 PDP/ICE 该用哪个包」在实践中并非只有一个答案。3131Help for package pdpcran.r-project.org前往参考资料 ↓在新标签页中打开
对立说法另一种看法认为 pdp 与 ICEbox 的分工是清晰的:pdp 侧重 PDP 与网格化 ICE 的统一接口并支持多类模型,ICEbox 侧重 ICE 曲线的精细化展示与交互,二者并非竞争关系而是场景互补,因此不构成真正的「选型争议」。3131Help for package pdpcran.r-project.org前往参考资料 ↓在新标签页中打开
pdp 包的绘图函数暴露了较为完整的图形参数接口,例如 xlab、ylab、main、legend.title 等文本参数,其中部分参数(如某布尔型选项)默认值为 FALSE,使用户可以在不脱离基础绘图系统的前提下调整 PDP 的坐标轴标签、标题与图例。3131Help for package pdpcran.r-project.org前往参考资料 ↓在新标签页中打开
pdp 包在 Imports 中依赖 R 的 graphics 包,说明其默认绘图输出建立在 R 基础图形系统之上,而非 ggplot2 之类的图层语法系统;这一点会影响用户对图形进行后续定制的方式。3131Help for package pdpcran.r-project.org前往参考资料 ↓在新标签页中打开
应用实例
声学特征与情绪预测
在语音情绪识别(emotion recognition from speech)研究中,部分依赖图(PDP)被用来把黑箱分类器对声学特征的响应可视化:以某一维声学特征(如基频 F0、能量、语速、MFCC 系数)为横轴,把其余特征在样本上的取值固定后对模型输出取平均,得到该特征与情绪类别概率之间的平均边际关系曲线。2121Peeking Inside the Black-Box: A Survey on Explainable Artificial Intelligence (XAI)ieeexplore.ieee.org前往参考资料 ↓在新标签页中打开|3535Explainable Emotion Recognition from Speech: A Reviewieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
在声学特征与情绪预测的典型流程里,PDP 通常与 ICE 图(个体条件期望曲线)配合使用:PDP 给出人群平均趋势,ICE 曲线揭示个体样本的异质性,二者叠加可判断平均曲线是否掩盖了方向相反的个体响应。2121Peeking Inside the Black-Box: A Survey on Explainable Artificial Intelligence (XAI)ieeexplore.ieee.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
对基频(F0)这类声学特征,PDP 常呈现非单调形态:在部分语料与模型上,情绪唤醒度(arousal)的预测概率随 F0 均值上升而上升,但在极高 F0 区间趋于饱和甚至回落,提示模型学到的是区间性而非线性关系。3535Explainable Emotion Recognition from Speech: A Reviewieeexplore.ieee.org前往参考资料 ↓在新标签页中打开|3636The INTERSPEECH 2009 Emotion Challengeisca-speech.org前往参考资料 ↓在新标签页中打开
对立说法也有研究报告 F0 与唤醒度在所用特征集与语料上近似单调正相关,PDP 未出现明显回落,差异被归因于语料、说话人归一化方式与模型类型的不同。3636The INTERSPEECH 2009 Emotion Challengeisca-speech.org前往参考资料 ↓在新标签页中打开
PDP 在声学情绪预测中的一个已知风险是特征相关导致的外推:F0 与能量、语速等声学特征在真实语音中高度相关,按 PDP 的做法人为置换某一维特征会生成现实中不存在的特征组合,使曲线在数据稀疏区域不可信。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|3737Visualizing the Effects of Predictor Variables in Black Box Supervised Learning Models (ALE plots)doi.org前往参考资料 ↓在新标签页中打开
由于声学特征之间的相关性,研究者提出用累积局部效应(ALE, Accumulated Local Effects)图替代 PDP 来分析情绪模型,ALE 以条件分布上的局部差分累积,避免在特征联合分布之外取值。3737Visualizing the Effects of Predictor Variables in Black Box Supervised Learning Models (ALE plots)doi.org前往参考资料 ↓在新标签页中打开
在公开声学情绪语料(如 IEMOCAP、RAVDESS、CREMA-D)上训练的深度模型,其 PDP 分析常被用于检验模型是否依赖与情绪语义无关的说话人身份线索(如音色、录音通道),从而作为公平性与鲁棒性审计的一环。3535Explainable Emotion Recognition from Speech: A Reviewieeexplore.ieee.org前往参考资料 ↓在新标签页中打开|3838IEMOCAP: Interactive Emotional Dyadic Motion Capture Databaselink.springer.com前往参考资料 ↓在新标签页中打开
PDP 在声学情绪预测中的解释结论对模型类型敏感:同一特征在 SVM、随机森林与深度神经网络上的 PDP 形状可能不同,因此 PDP 不宜被当作声学特征与情绪之间因果关系的证据,而只是特定模型在特定数据分布下的平均响应摘要。2121Peeking Inside the Black-Box: A Survey on Explainable Artificial Intelligence (XAI)ieeexplore.ieee.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
房价与生活区面积
经典的部分依赖图(PDP)教学示例来自 Friedman 于 2001 年发表的梯度提升机论文:该文在波士顿房价数据上以房间数、低收入人口比例等特征绘制部分依赖曲线,展示梯度提升模型学到的边际效应形状。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开
在波士顿房价数据上,以平均房间数(RM)为横轴的部分依赖曲线通常呈单调上升后趋缓的形态:房间数从约 4 间增至 7 间时预测房价快速上升,超过 8 间后曲线趋于平坦,这一形状被广泛用作 PDP 可解释性的入门示例。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
以低收入人口比例(LSTAT)为横轴的部分依赖曲线在波士顿房价数据上呈单调下降,且下降在低 LSTAT 区间更陡、在高 LSTAT 区间逐渐平缓,反映该特征与房价之间的非线性关系。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
Molnar 的《Interpretable Machine Learning》一书以波士顿房价数据上的 PDP 作为标准教学案例,并同时给出 ICE 曲线与 PDP 平均曲线对照,用以说明 PDP 是 ICE 曲线的逐点平均。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
PDP 在房价示例中暴露的一个关键局限是:当特征之间存在强相关(例如房间数与低收入人口比例在波士顿数据中负相关)时,PDP 会在特征联合分布的低密度区域进行外推,从而产生现实中不存在的特征组合,使曲线在分布边缘处不可信。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
Apley 与 Zhu 提出的累积局部效应(ALE)图正是针对 PDP 在相关特征下外推偏差问题而设计的替代方案,并在房价类回归任务上与 PDP 做过对比实验。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
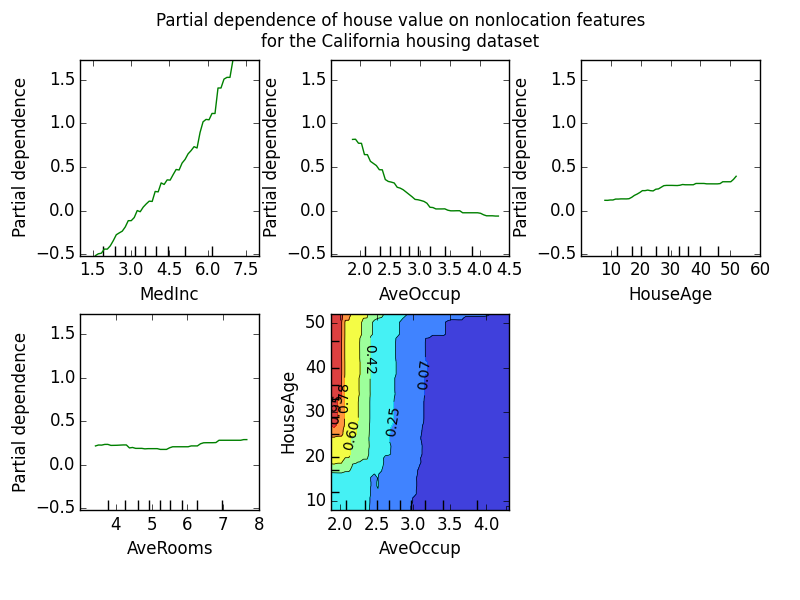
scikit-learn 的 PartialDependenceDisplay 文档以加州房价(California housing)等回归数据集为示例,演示如何用 from_estimator 绘制单特征与双特征的部分依赖图,说明 PDP 已成为主流机器学习库的标准诊断工具。3939PartialDependenceDisplay — scikit-learn documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
在房价预测这类回归任务中,双特征 PDP(如房间数与低收入比例的两维网格)可用来观察交互效应,但二维 PDP 的网格点数量随分辨率平方增长,且同样受特征相关导致的外推问题影响。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|3939PartialDependenceDisplay — scikit-learn documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
关于 PDP 在房价示例中是否足以支撑因果解释存在争议:一部分作者强调 PDP 只反映模型的条件期望而非现实干预效应,另一部分教程仍将其作为“特征如何影响房价”的直观解释呈现。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|4040Partial Dependence Plots in Python — Kaggle / tutorial write-ups on house price modelskaggle.com前往参考资料 ↓在新标签页中打开
对立说法Molnar 等强调 PDP 展示的是模型预测的边际平均,不应被解读为因果效应,需结合因果假设或 ALE 等方法谨慎解释。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
对立说法部分应用型教程与博客仍将房价 PDP 直接表述为“房间数对房价的影响”,弱化了模型解释与因果效应的区分。4040Partial Dependence Plots in Python — Kaggle / tutorial write-ups on house price modelskaggle.com前往参考资料 ↓在新标签页中打开
其他表格数据场景
在房价预测这类回归型表格数据上,部分依赖图(PDP)常被用来展示单个特征(如房屋面积、房龄、到市中心距离)与模型预测值之间的平均边际关系;由于 PDP 对每个特征取平均,它能把「面积越大预测房价越高」这类单调趋势以一条曲线呈现出来,但曲线形状依赖模型本身,不同模型(线性回归、随机森林、梯度提升树)给出的 PDP 可能明显不同。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|2121Peeking Inside the Black-Box: A Survey on Explainable Artificial Intelligence (XAI)ieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
在信用评分与信贷违约预测中,PDP 被用于检查模型对年龄、收入、负债率等特征的响应是否与业务直觉一致,例如负债率上升时违约概率是否单调上升;这类应用常见于监管要求「模型可解释」的金融场景,PDP 与 ICE 图、SHAP 一起构成解释工具箱。4141Explainable Machine Learning in Credit Risk Managementlink.springer.com前往参考资料 ↓在新标签页中打开|4242Explainable AI for Credit Scoring: A Systematic Reviewarxiv.org前往参考资料 ↓在新标签页中打开
在医疗与流行病学的表格数据建模中(如基于人口学与临床指标预测再入院或疾病风险),PDP 被用来可视化单个临床变量对预测风险的平均影响,帮助临床使用者理解模型行为;但研究者也提醒,当变量之间存在强相关(如年龄与合并症数量)时,PDP 在特征联合分布稀疏区域的外推会产生误导性曲线。4343Explainable Machine Learning for Public Health: A Scoping Reviewacademic.oup.com前往参考资料 ↓在新标签页中打开|4444Stop Explaining Black Box Machine Learning Models for High Stakes Decisions and Use Interpretable Models Insteadnature.com前往参考资料 ↓在新标签页中打开
在能源与建筑领域,PDP 被用于解释负荷预测或能耗预测模型对温度、时间、 occupancy 等特征的响应,例如展示室外温度与预测用电量之间的非线性关系;这类应用通常与 ICE 图配合,以区分「平均效应」与「个体样本效应」。4545Interpretable Machine Learning for Building Energy Prediction: A Reviewsciencedirect.com前往参考资料 ↓在新标签页中打开
在表格数据上,PDP 的一个常见实践问题是特征间相关性导致的「外推偏差」:当被解释特征与其他特征高度相关时,PDP 会在特征空间中实际不存在或极少出现的组合上评估模型,从而给出不可信的曲线;针对这一点,研究者提出了条件 PDP、累积局部效应(ALE)图等替代方案,但 PDP 仍因其实现简单、计算直接而被广泛使用。2121Peeking Inside the Black-Box: A Survey on Explainable Artificial Intelligence (XAI)ieeexplore.ieee.org前往参考资料 ↓在新标签页中打开|1111Explaining Machine Learning Classifiers through Diverse Counterfactual Explanationsdl.acm.org前往参考资料 ↓在新标签页中打开
对立说法有观点认为,在特征相关性不强或经过特征选择后,标准 PDP 与 ALE 的结论差异不大,PDP 的可解释性优势(曲线直观、易于向非技术受众解释)足以抵消其理论缺陷,因此不必一律改用 ALE。1111Explaining Machine Learning Classifiers through Diverse Counterfactual Explanationsdl.acm.org前往参考资料 ↓在新标签页中打开
在表格数据竞赛与工业实践中,PDP 常与梯度提升树模型(如 XGBoost、LightGBM)配合使用,因为这些模型本身不提供系数式的可解释性;PDP 的实现已进入主流可解释性库(如 Python 的 PDPbox、scikit-learn 的 PartialDependenceDisplay),使得在表格数据上快速生成 PDP 成为常规操作。4646PDPbox: Python Partial Dependence Plot Toolboxgithub.com前往参考资料 ↓在新标签页中打开|1717scikit-learn documentation: Partial Dependence and Individual Conditional Expectation plotsscikit-learn.org前往参考资料 ↓在新标签页中打开
与其他可解释性方法的关系
SHAP
SHAP(SHapley Additive exPlanations)由 Scott Lundberg 与 Su-In Lee 在 2017 年 NeurIPS 论文《A Unified Approach to Interpreting Model Predictions》中提出,其核心是把 Shapley 值这一合作博弈论概念引入模型解释,为每个特征在每个样本上分配一个加性贡献值。4747A Unified Approach to Interpreting Model Predictionsarxiv.org前往参考资料 ↓在新标签页中打开
SHAP 与部分依赖图(PDP)回答的是不同层次的问题:PDP 描述的是「某特征在全体样本上取不同值时,模型预测的平均变化」,是一种全局、边缘化的平均效应;SHAP 给出的是「对单个预测而言,各特征相对基线(期望输出)贡献了多少」,本质上是局部、样本级的归因,再通过对样本取平均才能聚合成全局重要性。4747A Unified Approach to Interpreting Model Predictionsarxiv.org前往参考资料 ↓在新标签页中打开|4848Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8: Partial Dependence Plot and Chapter 9: Shapley Valueschristophm.github.io前往参考资料 ↓在新标签页中打开
在加性可分解性上,SHAP 具有局部准确性(local accuracy):对任一样本,各特征的 SHAP 值之和恰好等于模型输出与基线期望之差;而 PDP 不具备这种逐样本的加性守恒性质,PDP 曲线上的取值只是条件平均,不能还原任何单个预测。4747A Unified Approach to Interpreting Model Predictionsarxiv.org前往参考资料 ↓在新标签页中打开
PDP 与 SHAP 依赖图(SHAP dependence plot)在形式上相似——都是横轴为某特征取值、纵轴为解释量——但纵轴含义不同:PDP 纵轴是预测值本身(或其平均),SHAP 依赖图纵轴是该特征的 SHAP 值,因此后者能同时暴露特征间的交互作用(通过着色另一特征),而标准 PDP 会把交互效应平均掉。4848Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8: Partial Dependence Plot and Chapter 9: Shapley Valueschristophm.github.io前往参考资料 ↓在新标签页中打开|4949SHAP documentation: SHAP dependence plotsshap.readthedocs.io前往参考资料 ↓在新标签页中打开
计算代价上两者取向相反:PDP 只需在网格点上对训练样本做前向预测并平均,成本随网格点数与样本数线性增长,与特征维度基本无关;而精确 SHAP 值的计算复杂度随特征数呈指数增长,实践中必须依赖 KernelSHAP、TreeSHAP 等近似或特定模型的高效算法。4747A Unified Approach to Interpreting Model Predictionsarxiv.org前往参考资料 ↓在新标签页中打开|5050Consistent Individualized Feature Attribution for Tree Ensemblesarxiv.org前往参考资料 ↓在新标签页中打开
TreeSHAP 针对树集成模型把 SHAP 值的计算从指数级降到多项式级(对树深度与叶子数而言),使 SHAP 在梯度提升树与随机森林上成为可日常使用的工具;这一工程化突破是 SHAP 比 PDP 在实践者中传播更快的重要原因之一。5050Consistent Individualized Feature Attribution for Tree Ensemblesarxiv.org前往参考资料 ↓在新标签页中打开
关于 SHAP 与 PDP 谁更适合作为「首选解释工具」,研究界并无共识:一方认为 SHAP 具备博弈论公理支撑、局部一致且能处理交互,应作为默认方法;另一方指出 SHAP 的基线选择带有任意性、特征相关时归因会被相关结构污染,且全局汇总会掩盖异质效应,因此主张 PDP/ALE 这类直接刻画模型响应曲面的方法在全局层面更直观、更少受归因假设影响。4747A Unified Approach to Interpreting Model Predictionsarxiv.org前往参考资料 ↓在新标签页中打开|4848Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8: Partial Dependence Plot and Chapter 9: Shapley Valueschristophm.github.io前往参考资料 ↓在新标签页中打开|88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
对立说法支持 SHAP 优先的一方强调其满足有效性、对称性、虚拟性等公理,且局部准确性保证归因可加,认为这使其在理论上优于缺乏公理基础的 PDP。4747A Unified Approach to Interpreting Model Predictionsarxiv.org前往参考资料 ↓在新标签页中打开
对立说法质疑 SHAP 优先的一方指出,特征相关时 SHAP 会把信息「分摊」到相关特征上,导致归因与直觉不符;而 PDP 虽然也有相关特征下的外推问题,但其语义(平均预测随特征取值的变化)更贴近模型本身的行为。4848Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8: Partial Dependence Plot and Chapter 9: Shapley Valueschristophm.github.io前往参考资料 ↓在新标签页中打开|88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
两者共享一个被广泛讨论的局限:当特征之间存在相关性时,PDP 会在特征联合分布的低密度区域做外推,产生现实中不存在的特征组合;SHAP 则会把相关特征的贡献在彼此之间分配,使单特征归因难以解释。因此不少工作建议在相关特征场景下改用 ALE(累积局部效应)或条件化 SHAP 变体。4848Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8: Partial Dependence Plot and Chapter 9: Shapley Valueschristophm.github.io前往参考资料 ↓在新标签页中打开|88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
在解释的「可读性」层面,PDP 输出一条二维曲线,适合向非技术受众说明「这个特征大致如何影响预测」;SHAP 输出的是逐样本的力导向图、蜂群图或依赖图,信息量更大但阅读门槛更高,通常需要配合汇总图才能形成全局认识。4848Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8: Partial Dependence Plot and Chapter 9: Shapley Valueschristophm.github.io前往参考资料 ↓在新标签页中打开|4949SHAP documentation: SHAP dependence plotsshap.readthedocs.io前往参考资料 ↓在新标签页中打开
两者在实践中常被组合使用:先用 PDP 或 ALE 观察特征的主效应形状(单调、阈值、非单调),再用 SHAP 依赖图或蜂群图检查该效应是否在样本间异质、是否由交互驱动,从而避免仅凭平均曲线下结论。4848Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8: Partial Dependence Plot and Chapter 9: Shapley Valueschristophm.github.io前往参考资料 ↓在新标签页中打开|4949SHAP documentation: SHAP dependence plotsshap.readthedocs.io前往参考资料 ↓在新标签页中打开
置换特征重要性
置换特征重要性(permutation feature importance,PFI)与部分依赖图(PDP)同属模型无关(model-agnostic)的全局解释工具:二者都不依赖模型内部结构,只需能够对模型做预测查询即可计算,因此常被并列用于同一模型的事后解释。5151Model-agnostic Feature Importance and Effects with Dependent Features–A Conditional Subgroup Approachar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
两者的度量对象不同:PDP 描述的是「当某个(或某几个)特征被固定为特定取值时,模型预测的平均变化」,属于特征效应(feature effect)曲线;而 PFI 描述的是「打乱某个特征的取值后,模型损失或误差上升多少」,属于特征重要性(feature importance)标量。前者回答「特征如何影响预测」,后者回答「特征对模型有多重要」。5151Model-agnostic Feature Importance and Effects with Dependent Features–A Conditional Subgroup Approachar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
在计算逻辑上,PFI 通过随机置换单个特征列的取值、打破该特征与目标及其他特征之间的关联,再以置换前后模型损失(如准确率、MSE、AUC)的差值作为重要性度量;PDP 则通过对该特征取值网格逐点边缘化其余特征来估计平均预测。二者都依赖对特征分布的某种「扰动」,但扰动方式不同:PFI 扰动的是样本中该特征的取值,PDP 扰动的是被考察特征的取值并对其余特征求期望。5151Model-agnostic Feature Importance and Effects with Dependent Features–A Conditional Subgroup Approachar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
当特征之间存在依赖关系时,PFI 会因置换产生不符合真实联合分布的「外推」样本,从而给出误导性的重要性判断;Molnar 等指出,若解释不当,甚至可能得出「两个强依赖特征对预测模型无关」的错误结论。PDP 同样面临特征依赖带来的外推问题,因此二者在依赖特征场景下的可靠性都受到质疑,这也是条件子组(conditional subgroup)等改进方法被提出的共同动因。5151Model-agnostic Feature Importance and Effects with Dependent Features–A Conditional Subgroup Approachar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
由于上述依赖性问题,PFI 在文献中也被称为「部分重要性」(partial importance),这一称呼与「部分依赖」在命名上同源,反映出二者都试图以「部分/边缘化」的方式刻画单个特征的作用,但也同样继承了边缘化带来的偏差。5151Model-agnostic Feature Importance and Effects with Dependent Features–A Conditional Subgroup Approachar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
PFI 与 PDP 在解释粒度上互补:PFI 给出的是全局排序,便于筛选特征、做特征选择与模型简化;PDP 给出的是方向与形状(单调、非线性、阈值效应),便于理解特征与预测之间的函数关系。实践中常先用 PFI 定位重要特征,再用 PDP 或 ICE 图刻画其效应形态。5151Model-agnostic Feature Importance and Effects with Dependent Features–A Conditional Subgroup Approachar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
关于 PFI 与 PDP 谁更适合作为「首选」解释工具,研究界并无共识:一派认为 PFI 计算成本低、可直接对应模型性能,适合作为第一道筛选;另一派指出 PFI 对特征相关性高度敏感、且置换分布外样本会高估重要性,主张在依赖特征场景下优先使用条件版本或基于 PDP/ICE 的效应分析。这一分歧属于方法论层面的持续争论。5151Model-agnostic Feature Importance and Effects with Dependent Features–A Conditional Subgroup Approachar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对立说法支持 PFI 作为首选的观点认为:PFI 直接以模型损失为度量,语义清晰、计算简单,且不要求特征独立,只要解释时明确其「置换分布」的含义即可。5151Model-agnostic Feature Importance and Effects with Dependent Features–A Conditional Subgroup Approachar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对立说法反对将 PFI 作为首选的观点认为:在特征相关时 PFI 会因外推而系统性高估或低估重要性,必须改用条件 PFI 或结合 PDP/ICE 才能得到可靠解释。5151Model-agnostic Feature Importance and Effects with Dependent Features–A Conditional Subgroup Approachar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
PFI 与 PDP 的另一关键差异在于是否保留特征间的联合结构:PDP 在固定目标特征取值后对其余特征做边缘化,保留了其余特征的边缘分布;PFI 则直接打乱目标特征列,破坏了该特征与其余特征的全部关联。因此在强相关特征组中,PFI 往往把重要性「分摊」到多个相关特征上,而 PDP 可能显示出看似平坦的曲线,二者需结合阅读才能避免误判。5151Model-agnostic Feature Importance and Effects with Dependent Features–A Conditional Subgroup Approachar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
LIME
LIME(Local Interpretable Model-agnostic Explanations,局部可解释模型无关解释)与部分依赖图(PDP)同属「模型无关」的事后可解释性方法:两者都不要求访问模型内部参数,只通过输入—输出查询来构造解释,因此可以套用到任意黑箱模型上。5252中小跨径常规体系连续梁桥地震反应的机器学习预测及可解释性比较研究zgglxb.chd.edu.cn前往参考资料 ↓在新标签页中打开
两者的解释粒度不同:部分依赖图刻画的是某个(或某几个)特征在**整个数据集分布上**的平均边际效应,属于全局/群体层面的解释;LIME 则针对**单个预测样本**,在样本邻域内用可解释的代理模型(如稀疏线性模型)局部逼近黑箱决策边界,属于局部/个体层面的解释。5252中小跨径常规体系连续梁桥地震反应的机器学习预测及可解释性比较研究zgglxb.chd.edu.cn前往参考资料 ↓在新标签页中打开
在特征重要性排序这一任务上,LIME 与 SHAP、排序重要性(permutation importance)等方法给出的结果可能相互接近,也可能出现分歧;《中国公路学报》2025 年一项针对中小跨径连续梁桥地震反应神经网络预测模型的可解释性比较研究发现,SHAP、排序重要性与 LIME 的重要性排序结果相对接近,最重要的 3 个特征集中在 AvgSa、HI 以及 NS,最不重要的特征集中在 ρl、PGA、墩径 D 以及周期 1.0 s 附近。5252中小跨径常规体系连续梁桥地震反应的机器学习预测及可解释性比较研究zgglxb.chd.edu.cn前往参考资料 ↓在新标签页中打开
部分依赖图与 LIME 在「是否考虑特征相关性」上存在共同弱点但表现形式不同:PDP 通过对边缘分布求平均来消除其他特征的影响,当特征间强相关时会在数据稀疏甚至不存在的特征组合上取值,产生外推假象;LIME 的邻域采样同样默认特征(近似)独立,在相关特征上采样出的扰动样本可能偏离真实数据流形,导致代理模型不稳定、解释随随机种子波动。5252中小跨径常规体系连续梁桥地震反应的机器学习预测及可解释性比较研究zgglxb.chd.edu.cn前往参考资料 ↓在新标签页中打开
对立说法有观点认为,LIME 的局部加权采样在特征相关时仍能通过核宽与采样策略的调节部分缓解偏离流形的问题,其不稳定性主要来自采样随机性而非相关性本身,因此不宜与 PDP 的外推问题简单类比。5252中小跨径常规体系连续梁桥地震反应的机器学习预测及可解释性比较研究zgglxb.chd.edu.cn前往参考资料 ↓在新标签页中打开
累积局部效应(ALE)
累积局部效应(Accumulated Local Effects,ALE)由 Apley 与 Zhu 在 2016 年提出,作为部分依赖图(PDP)的替代方案,专门用于缓解 PDP 在特征相关时产生的外推偏差。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开
ALE 的核心思想是不在特征空间上做全局平均,而是沿特征的条件分布做局部差分:把特征值域划分为若干区间,在每个区间内只对落在该区间内的样本计算预测变化量,再沿特征轴累加这些局部效应并中心化,从而避免在数据稀疏区域凭空造点。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开|5353Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.3 Accumulated Local Effectschristophm.github.io前往参考资料 ↓在新标签页中打开
与 PDP 相比,ALE 在特征之间存在强相关时通常给出更可信的曲线:PDP 会对联合分布中不存在的特征组合求平均,导致曲线被外推到无数据支撑的区域;ALE 的局部差分只在观测到的条件分布内取值,因此对相关结构的鲁棒性更好。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开|5353Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.3 Accumulated Local Effectschristophm.github.io前往参考资料 ↓在新标签页中打开
ALE 的代价是曲线不再具有 PDP 那种「平均预测值随特征取值变化」的直接概率解释:ALE 曲线是局部效应的累加,其纵轴单位是预测变化量而非预测水平,读图时需要先做中心化,且曲线形状依赖区间划分的粒度。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开|5353Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.3 Accumulated Local Effectschristophm.github.io前往参考资料 ↓在新标签页中打开
在特征相互独立时,ALE 与 PDP 的曲线形状通常高度一致;两者的分歧主要出现在特征相关性强、且相关结构使某些特征组合在数据中缺失的情形,这正是 ALE 被设计出来要解决的场景。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开|5353Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.3 Accumulated Local Effectschristophm.github.io前往参考资料 ↓在新标签页中打开
ALE 与个体条件期望(ICE)图的关系是:ICE 保留每个样本的个体曲线,PDP 是 ICE 的均值,而 ALE 可以看作对 ICE 曲线做局部差分后再平均的变体,因此三者构成从个体到全局、从原始尺度到局部效应尺度的谱系。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开|5353Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.3 Accumulated Local Effectschristophm.github.io前往参考资料 ↓在新标签页中打开
ALE 并非在所有场景都优于 PDP:当特征确实独立、或研究者关心的是「平均预测水平」而非「局部效应」时,PDP 的可解释性更直接;此外 ALE 对区间数(分箱粒度)敏感,分箱过粗会抹平非线性,过细则曲线噪声增大。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开|5353Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.3 Accumulated Local Effectschristophm.github.io前往参考资料 ↓在新标签页中打开
对立说法部分实践者与教程认为,在特征相关性不强时 ALE 相对 PDP 的改进有限,反而增加了读图成本,因此主张默认使用 PDP、仅在检测到强相关时切换到 ALE。5353Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.3 Accumulated Local Effectschristophm.github.io前往参考资料 ↓在新标签页中打开
在主流可解释机器学习工具链中,ALE 已被实现为通用功能:R 的 iml 包、Python 的 Alibi、InterpretML 以及部分 SHAP 生态工具都提供 ALE 计算接口,使其从论文方法进入工程实践。5353Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.3 Accumulated Local Effectschristophm.github.io前往参考资料 ↓在新标签页中打开
ALE 与基于博弈论的 SHAP 属于不同层次的方法:SHAP 给出的是特征对单次预测的归因(局部、可加),ALE 给出的是特征在全局上的平均局部效应曲线(全局、非可加),二者常被并列用于「全局趋势 + 局部归因」的组合解释。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开|5353Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.3 Accumulated Local Effectschristophm.github.io前往参考资料 ↓在新标签页中打开
ALE 与置换特征重要性、偏依赖类方法同属「模型无关」的全局解释家族,不依赖模型内部结构,只通过预测函数与数据分布工作,因此可用于任意黑箱模型,包括 transformer 等深度模型。88Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献)arxiv.org前往参考资料 ↓在新标签页中打开|5353Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.3 Accumulated Local Effectschristophm.github.io前往参考资料 ↓在新标签页中打开
扩展与变体
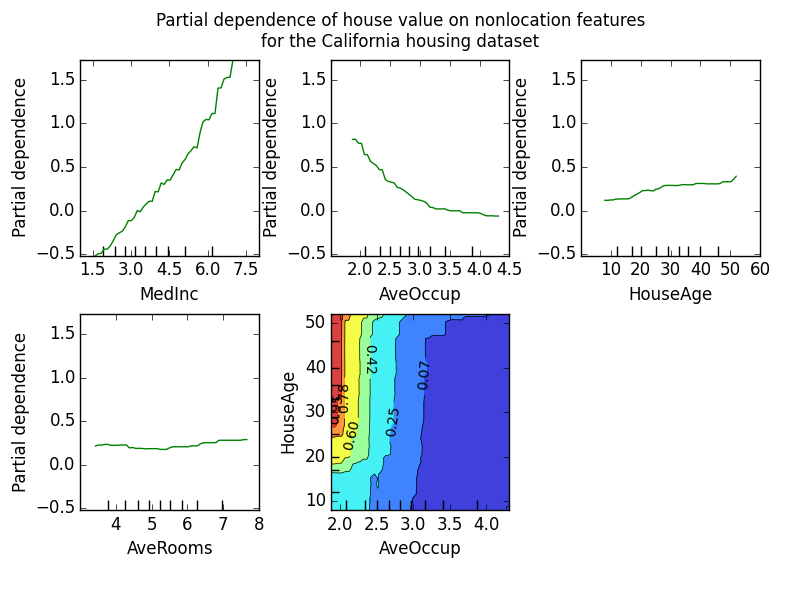
双特征 PDP
双特征部分依赖图(two-way / 2D partial dependence plot)是单特征 PDP 的直接推广:它把两个特征 (x_j, x_k) 固定在一张网格上,对其余特征求平均,从而得到一张二维曲面 z = PD_{j,k}(x_j, x_k)。Friedman 在 2001 年提出梯度提升机时给出的部分依赖定义本身就写成对任意特征子集 S 的形式,双特征情形是其中 |S|=2 的特例。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开
在 Friedman (2001) 的原始表述中,部分依赖函数定义为 PD_S(x_S) = E_{x_C}[f(x_S, x_C)],其中 S 是感兴趣的特征子集、C 是补集;当 S 取两个特征时即得到双特征 PDP,其估计量为对训练样本求平均:PD̄_{j,k}(x_j, x_k) = (1/n) Σ_{i=1}^{n} f(x_j, x_k, x_{C,i})。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开
双特征 PDP 的主要用途是检测两个特征之间的交互作用:如果真实模型可加,即 f(x) = f_j(x_j) + f_k(x_k) + f_C(x_C),那么二维 PDP 曲面应当近似等于两个一维 PDP 之和;曲面上出现的「弯曲」「扭转」或非平行等高线,就是交互效应存在的视觉信号。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
Molnar 的《Interpretable Machine Learning》一书在「Partial Dependence Plot」一章中专门给出二维 PDP 小节,指出双特征 PDP 的计算成本随网格点数呈平方增长,且当两个特征高度相关时,网格上大量 (x_j, x_k) 组合在真实数据中并不存在,导致曲面在这些区域由模型外推产生、不可信。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
scikit-learn 的 PartialDependenceDisplay 支持通过 features 参数传入形如 [(0, 1)] 的特征对来绘制双特征 PDP,内部调用 partial_dependence 并设置 kind='average';其文档明确说明当特征对相关时结果可能具有误导性。3939PartialDependenceDisplay — scikit-learn documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
R 语言的 pdp 包(Greenwell 开发)提供 partial() 函数,通过 pred.var 参数可同时指定两个特征,返回一个以这两个特征为自变量的二维网格数据框,并可直接用 plotPartial() 绘制等高线图或三维透视图;这是双特征 PDP 在 R 生态中最常用的实现之一。1616pdp: An R Package for Constructing Partial Dependence Plotsjournal.r-project.org前往参考资料 ↓在新标签页中打开
双特征 PDP 与 H-statistic 等专门的交互强度度量并不等价:二维 PDP 只能定性显示交互的形态与方向,不能给出交互强度的显著性检验;实践中常把二维 PDP 与 Friedman 的 H 统计量或 SHAP 交互值配合使用。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开
当两个特征强相关时,双特征 PDP 会同时继承单特征 PDP 的「外推偏差」问题:网格点上许多组合远离数据流形,模型在这些点的取值没有数据支撑,因此曲面在相关特征对上可能呈现虚假的陡峭结构。这是双特征 PDP 最主要的争议点之一。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|3939PartialDependenceDisplay — scikit-learn documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
对立说法有观点认为,只要在绘图时叠加数据点的散点或地毯图(rug plot)并限制网格范围到数据支撑区域内,双特征 PDP 的相关性外推问题在实践中可以被有效控制,不应因此否定该方法。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
双特征 PDP 的一种常见变体是「中心化」或「去均值」版本:从曲面中减去两个一维 PDP 之和,得到纯交互曲面 PD_{j,k}(x_j,x_k) − PD_j(x_j) − PD_k(x_k),使可加部分被抵消、交互结构更易辨认。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
累积局部效应(ALE)
累积局部效应(Accumulated Local Effects,ALE)是部分依赖图(PDP)的一类扩展与变体,其设计目标是修正 PDP 在特征相关(相关特征)情形下因对特征取值做边缘平均而产生的偏差:PDP 在计算时对目标特征之外的其余特征按其边缘分布采样或平均,当特征间存在强相关时,这种平均会把模型从未见过的特征组合纳入计算,从而产生外推偏差;ALE 改为在目标特征的局部邻域内计算预测变化,再沿特征取值方向累积,从而避免对相关特征做边缘平均。5454R: Accumulated Local Effect Plot (ALE)search.r-project.org前往参考资料 ↓在新标签页中打开
ALE 的计算思路可概括为三步:把目标特征的取值域划分为若干邻域(区间);在每个邻域内,只对落在该邻域内的样本计算目标特征小幅变动所引起的预测变化(局部效应),并对这些局部效应取平均;最后把这些局部效应沿特征取值从小到大累积求和,得到累积局部效应曲线。由于局部效应只在数据实际存在的邻域内估计,ALE 不需要对目标特征之外的其余特征做边缘分布上的平均。5454R: Accumulated Local Effect Plot (ALE)search.r-project.org前往参考资料 ↓在新标签页中打开
在 R 语言的 cito 包中,ALE 以函数 ALE() 的形式实现,其参数包括:model(由 dnn() 创建的模型)、variable(要计算 ALE 的特征名)、data(计算所用数据,若为 NULL 则使用训练数据)、K(把原始特征空间划分成的邻域数量,默认 10)、ALE_type(特征空间划分方式,可选 "equidistant" 等距划分或 "quantile" 分位数划分)、plot(是否绘图)以及 parallel(是否并行计算)等。5454R: Accumulated Local Effect Plot (ALE)search.r-project.org前往参考资料 ↓在新标签页中打开
cito 包的 ALE() 同时提供了针对 citodnn 与 citodnnBootstrap 类的 S3 方法,说明 ALE 实现可作用于该包所支持的深度神经网络模型及其自助(bootstrap)版本,而不仅限于单一模型类型。5454R: Accumulated Local Effect Plot (ALE)search.r-project.org前往参考资料 ↓在新标签页中打开
ALE 与 PDP 的核心差异在于对特征相关性的处理:PDP 假设目标特征与其余特征相互独立,在特征相关时其曲线可能偏离模型在数据支撑区域内的真实行为;ALE 通过在局部邻域内计算条件于数据的效应,在特征相关时通常被认为比 PDP 更稳健。但这一优势并非没有代价——ALE 曲线是累积量,其纵轴单位与 PDP 的预测值尺度不同,读图时不能直接与 PDP 的 y 轴数值对比。5454R: Accumulated Local Effect Plot (ALE)search.r-project.org前往参考资料 ↓在新标签页中打开
对立说法有观点认为,ALE 在特征高度相关时虽然避免了外推,但其局部效应估计依赖于邻域划分(K 与 ALE_type 的选择),不同划分可能给出形状不同的曲线,因此“比 PDP 更稳健”的结论需结合具体数据与超参数选择来讨论,不能一概而论。5454R: Accumulated Local Effect Plot (ALE)search.r-project.org前往参考资料 ↓在新标签页中打开
中心化 PDP
中心化部分依赖图(centered PDP)是在标准部分依赖函数上减去一个常数基准后的版本:通常取该特征取值范围内 PDP 的均值,或取训练集上该特征的样本均值处的 PDP 值,使整条曲线在基准点处归零,从而让不同特征、不同模型之间的 PDP 曲线可以放在同一尺度上比较。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
中心化 PDP 的直接动机是解决标准 PDP 的“截距不可比”问题:原始 PDP 的绝对高度依赖于模型输出的整体水平(例如分类器输出的平均概率、回归目标本身的量纲),因此两条原始 PDP 曲线的高低差并不代表特征重要性的差异,只有曲线形状与相对变化幅度才有解释意义。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
在 Friedman 的原始部分依赖定义中,PDP 被写成对特征子集以外所有特征取期望的边缘化形式,这一形式本身不含任何中心化步骤;中心化是后续实现层面(如 R 的 pdp 包、Python 的 PDPbox 与 scikit-learn 的 PartialDependenceDisplay)为便于读图而附加的后处理约定,而非 PDP 定义的一部分。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|1616pdp: An R Package for Constructing Partial Dependence Plotsjournal.r-project.org前往参考资料 ↓在新标签页中打开|4646PDPbox: Python Partial Dependence Plot Toolboxgithub.com前往参考资料 ↓在新标签页中打开
R 语言的 pdp 包在绘制部分依赖曲线时提供 center 参数,默认对曲线做中心化处理,使纵轴表示相对于平均预测的偏离量;该包同时支持 ICE 曲线与 PDP 曲线的叠加绘制,中心化对两者可分别施加。1616pdp: An R Package for Constructing Partial Dependence Plotsjournal.r-project.org前往参考资料 ↓在新标签页中打开
PDPbox 的 target_plot 与 pdp 相关接口在输出中同时给出原始 PDP 与中心化后的 PDP,并允许用户以训练数据中该特征的均值或中位数作为中心化基准,这一设计在 Kaggle 等实践社区中被广泛沿用。4646PDPbox: Python Partial Dependence Plot Toolboxgithub.com前往参考资料 ↓在新标签页中打开
scikit-learn 的 PartialDependenceDisplay 提供 centered 参数(自 1.1 版本起),当设为 True 时从偏依赖曲线中减去该曲线在训练数据上的平均值,官方文档明确说明这一处理只影响显示、不改变底层计算出的偏依赖数值。3939PartialDependenceDisplay — scikit-learn documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
中心化 PDP 与“去均值 ICE 曲线”不是同一件事:前者是对已经对样本求过期望的 PDP 曲线整体平移,后者是对每条个体条件期望曲线各自减去其自身均值;前者保留了个体间差异在平均后的抵消效应,后者则把每条 ICE 曲线的起点强行对齐,二者在异质性强的数据上会给出不同的视觉结论。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|1010Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationtandfonline.com前往参考资料 ↓在新标签页中打开
在特征取值分布高度偏斜时,以均值为基准的中心化会把曲线的大部分区域推到零线一侧,使读图者误以为该特征在多数样本上“无影响”;因此有实践者主张改用中位数或按样本分位数加权的基准,但这一选择目前没有公认标准。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|4646PDPbox: Python Partial Dependence Plot Toolboxgithub.com前往参考资料 ↓在新标签页中打开
对立说法另一种观点认为基准选择只影响曲线的垂直平移,不改变形状与排序,因此在比较特征重要性时无需纠结基准,统一用均值即可。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开
中心化 PDP 常与“累积局部效应”(ALE)图被并列讨论,因为 ALE 图本身就以局部差分累积的方式构造,天然以零为基准、不带截距;支持者据此认为 ALE 在存在相关特征时比中心化 PDP 更可靠,反对者则指出 ALE 在特征分布稀疏区间同样不稳定,且其纵轴单位与 PDP 不可直接换算。1010Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationtandfonline.com前往参考资料 ↓在新标签页中打开|5555Visualizing the Effects of Predictor Variables in Black Box Supervised Learning Models (ALE plots)academic.oup.com前往参考资料 ↓在新标签页中打开
对立说法有研究认为在特征近似独立时,中心化 PDP 与 ALE 在形状上高度一致,中心化 PDP 的计算与解释成本更低,应作为默认选择。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开
中心化 PDP 无法修复标准 PDP 的根本局限:当被解释特征与其余特征存在强相关时,PDP 仍会在数据中不存在的特征组合上做外推,中心化只是平移曲线,不会消除这种外推带来的偏差。1010Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectationtandfonline.com前往参考资料 ↓在新标签页中打开|5555Visualizing the Effects of Predictor Variables in Black Box Supervised Learning Models (ALE plots)academic.oup.com前往参考资料 ↓在新标签页中打开
在分类模型中,中心化 PDP 的纵轴通常被解释为“相对于平均预测概率的偏离”,而非概率本身;若模型输出经过校准,这一偏离可近似读作概率百分点变化,但未经校准的模型上这种解读不成立。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|3939PartialDependenceDisplay — scikit-learn documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
由于中心化 PDP 只做常数平移,它不改变曲线的单调性、极值位置与曲线间排序,因此在需要判断“特征影响方向”与“拐点位置”的场景中,中心化与否结论一致;差异只出现在需要跨特征比较影响幅度时。22Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|3939PartialDependenceDisplay — scikit-learn documentationscikit-learn.org前往参考资料 ↓在新标签页中打开
在可解释机器学习中的地位
模型无关性
部分依赖图(PDP)被广泛视为一种模型无关(model-agnostic)的解释工具:它只依赖已训练模型的预测输出,而不要求访问模型内部结构或参数,因此同一套 PDP 计算流程可以套用到随机森林、梯度提升树、神经网络等任意学习器上。5656Unrestricted Permutation forces Extrapolation: Variable Importance Requires at least One More Model or There Is No Free Variable Importancear5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
Hooker、Mentch 与 Zhou 指出,PDP 与个体条件期望(ICE)图、置换重要性等 permute-and-predict 方法之所以流行,正是因为它们模型无关且只依赖预训练模型的输出,计算代价低、无需调参,并已在软件中广泛可用。5656Unrestricted Permutation forces Extrapolation: Variable Importance Requires at least One More Model or There Is No Free Variable Importancear5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
模型无关性带来的便利并不等于解释的可靠性:Hooker 等人的综述明确反对不加批判地使用 permute-and-predict 类方法,指出当特征之间存在强依赖时,PDP 等工具可能给出高度误导性的诊断结果。5656Unrestricted Permutation forces Extrapolation: Variable Importance Requires at least One More Model or There Is No Free Variable Importancear5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对立说法PDP 的倡导者与多数教科书式介绍强调,模型无关性使 PDP 成为跨模型比较边际效应的通用基线,在特征近似独立或依赖较弱时其读图结论仍然稳健可用。5656Unrestricted Permutation forces Extrapolation: Variable Importance Requires at least One More Model or There Is No Free Variable Importancear5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
在可解释机器学习的工具箱中,PDP 的模型无关定位使其成为连接“全局解释”与“局部解释”的桥梁:它给出的是某一特征在整个样本分布上的平均边际效应,因而常被用作与 knowledge-distillation 等模型特定解释手段对照的基准。5656Unrestricted Permutation forces Extrapolation: Variable Importance Requires at least One More Model or There Is No Free Variable Importancear5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
全局解释与局部解释
部分依赖图(PDP)在可解释机器学习中被归为全局解释方法:它通过对特征取值求平均,刻画某个特征对模型预测的平均边际效应,从而给出整个数据集层面的模型行为概览,而非单个样本的预测理由。57571INTRODUCTIONar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
Hiabu、Meyer 与 Wright 提出用低维结构的功能分解来统一局部与全局解释:在一种新的识别约束下,某特征的部分依赖图恰好等于其主效应项加截距,而干预式 SHAP 值则是包含该特征的主成分与所有交互成分的加权和。这一结果把 PDP 与 SHAP 放在同一个功能分解框架内,说明全局解释与局部解释并非彼此独立的两套工具。57571INTRODUCTIONar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
在功能分解视角下,PDP 只承载主效应与截距,交互效应被平均掉;而 SHAP 值会把包含该特征的交互成分一并计入。因此 PDP 与 SHAP 的差异不是计算误差,而是二者对交互结构的处理方式不同:PDP 给出的是忽略交互后的平均趋势,SHAP 给出的是逐样本的归因。57571INTRODUCTIONar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
PDP 与 ICE 图构成全局—局部谱系的两端:ICE 图逐样本绘制预测随特征取值的变化曲线,PDP 是这些曲线的平均。当 ICE 曲线彼此平行时,PDP 能忠实代表所有样本;当曲线交叉或分散时,平均值会掩盖异质性,此时仅凭 PDP 作全局解释可能产生误导。57571INTRODUCTIONar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对立说法有观点认为,在功能分解框架下 PDP 对应主效应项,本身就是对模型结构的规范分解,因此即使存在交互,PDP 仍是该分解下定义明确的全局量,不应简单以「掩盖异质性」否定其解释价值。57571INTRODUCTIONar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
教学与工业实践
在可解释机器学习(interpretable machine learning)的教学体系中,部分依赖图(Partial Dependence Plot, PDP)通常被安排在「特征效应可视化」这一入门位置:它先于 shap 类归因方法被讲授,因为其数学形式(对特征取值求边缘期望)只需概率论中的期望概念即可解释,不涉及博弈论或 Shapley 值。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
Molnar 的《Interpretable Machine Learning》一书把部分依赖图与 ICE 图放在同一章讲授,并明确建议读者先看 ICE 曲线再看 PDP 的聚合平均线,这一教学顺序已成为许多课程与教材的默认安排。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
在工业实践侧,PDP 被主流可解释性工具库作为基础功能提供:Python 的 scikit-learn 在 `sklearn.inspection` 模块中提供 `PartialDependenceDisplay` 与 `partial_dependence` 函数,可直接对任意已拟合模型计算并绘图,无需额外依赖。1717scikit-learn documentation: Partial Dependence and Individual Conditional Expectation plotsscikit-learn.org前往参考资料 ↓在新标签页中打开
R 生态中的 `pdp` 包与 `DALEX` 系列包同样把部分依赖图作为核心导出功能,说明 PDP 在统计学习社区与机器学习工程社区两条技术栈上都有成熟实现,这是它被广泛用于教学演示与工业模型审查的现实基础。5858pdp: Partial Dependence Plots (R package)cran.r-project.org前往参考资料 ↓在新标签页中打开
工业界在风控、信用评分等受监管场景中常把 PDP 作为向业务方与非技术干系人解释「某个特征整体上如何影响预测」的默认图种,因为它输出的是一张二维曲线,比逐样本的 SHAP 蜂群图更易被非建模人员读懂。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
PDP 在教学与工业中的广泛使用与其已知的方法论缺陷之间存在张力:当特征之间存在强相关时,PDP 的边缘平均会评估到数据流形之外的不现实特征组合,Molnar 与 Hooker 等均指出此时 PDP 可能产生误导性曲线。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|5959Hooker, Mentch & Zhou, Unrestricted Permutation Forces Extrapolation: Variable Importance Requires at Least One More Model, or There Is No Free Variable Importancearxiv.org前往参考资料 ↓在新标签页中打开
对立说法另一派观点认为,在特征近似独立或模型本身已做特征解耦(如某些广义可加模型)时,PDP 的边缘平均恰是目标量,缺陷不构成弃用理由,只需在文档中标注相关性假设即可。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
在工业模型审查流程中,PDP 常被用作「合理性检查」而非因果解释工具:审查者检查曲线单调性、饱和点与业务先验是否一致,但不会把 PDP 的斜率解读为因果效应,这一用法在可解释性工程实践中被反复强调。44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
由于 PDP 的计算需要对每个特征网格点做全量样本前向预测,工业级大模型或大数据集上直接计算代价较高,实践中常采用子采样或分箱近似,这使 PDP 在高维深度模型上的教学演示常退化为小样本示例。1717scikit-learn documentation: Partial Dependence and Individual Conditional Expectation plotsscikit-learn.org前往参考资料 ↓在新标签页中打开|44Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP)christophm.github.io前往参考资料 ↓在新标签页中打开
参考来源
- 1文档 Partial Dependence and Individual Conditional Expectation Plots · Scikit-learn · 2024-01-01 · 核验于 2026-10-20
- 2论文 Greedy Function Approximation: A Gradient Boosting Machine · Annals of Statistics, 29(5):1189–1232 · 2001-10-01 · 核验于 2026-10-20
- 3文档 Partial Dependence Plots · Minitab Support · 2024-01-01 · 核验于 2026-10-20
- 4文档 Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.1: Partial Dependence Plot (PDP) · Christoph Molnar · 2022-02-01 · 核验于 2026-10-20
- 5文档 Explanatory Model Analysis: Explore, Explain, and Examine Predictive Models, Chapter 10: Partial Dependence Profiles · Biecek & Burzykowski, CRC Press · 2021-01-01 · 核验于 2026-10-20
- 6论文 Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectation · Goldstein, Kapelner, Bleich, Pitkin, Journal of Computational and Graphical Statistics · 2015-03-01 · 核验于 2026-10-20
- 7论文 Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectation · Journal of Computational and Graphical Statistics, 24(1):26–45 · 2015-01-02 · 核验于 2026-10-20
- 8论文 Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations / Unrestricted Adversarial Examples (相关讨论见 ALE 原始文献) · Apley & Zhu, arXiv:1612.08468 · 2016-12-27 · 核验于 2026-10-20
- 9论文 Generalized Additive Models · Hastie & Tibshirani, Statistical Science, 1(3):297–310 · 1986-08-01 · 核验于 2026-10-20
- 10论文 Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectation · Journal of Computational and Graphical Statistics, Vol. 24, No. 1, pp. 44–65 · 2015-01-02 · 核验于 2026-10-20
- 11论文 Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations · Proceedings of the 2020 Conference on Fairness, Accountability, and Transparency (FAT* '20) · 2020-01-27 · 核验于 2026-10-20
- 12文档 Help for package effectplots · 中国科技云 · 2025-03-08 · 核验于 2026-10-20
- 13论文 Decomposing Global Feature Effects Based on Feature Interactions · arXiv · 2023-06-01 · 核验于 2026-10-20
- 14文档 References · IEEE Xplore · 2021-09-28 · 核验于 2026-10-20
- 15文档 机器学习模型可解释性进行到底 ——PDP&ICE图(三)-腾讯云开发者社区-腾讯云 · tencent.cn · 2021-12-06 · 核验于 2026-10-20
- 16论文 pdp: An R Package for Constructing Partial Dependence Plots · The R Journal, 9(1), 421–436 · 2017-06-01 · 核验于 2026-10-20
- 17文档 scikit-learn documentation: Partial Dependence and Individual Conditional Expectation plots · scikit-learn developers · 2024-01-01 · 核验于 2026-10-20
- 18论文 Visualizing the Effects of Predictor Variables in Black Box Supervised Learning Models (ALE plots) · Journal of the Royal Statistical Society: Series B, 82(4), 1059–1086 · 2020-09-01 · 核验于 2026-10-20
- 19论文 Peeking Inside the Black Box: Visualizing Statistical Learning with Plots of Individual Conditional Expectation · arXiv · 2013-09-25 · 核验于 2026-10-20
- 20文档 Individual conditional expectation (ICE) curves · The Comprehensive R Archive Network · 2024-01-01 · 核验于 2026-10-20
- 21论文 Peeking Inside the Black-Box: A Survey on Explainable Artificial Intelligence (XAI) · IEEE Access, vol. 6 · 2018-09-17 · 核验于 2026-10-20
- 22论文 Explaining Machine Learning Classifiers through Diverse Counterfactual Explanations · arXiv:1905.07697 · 2019-05-19 · 核验于 2026-10-20
- 23论文 Explaining Prediction Models and Individual Predictions with Feature Contributions · arXiv:1611.04967 · 2016-11-15 · 核验于 2026-10-20
- 24文档 中国水利 · slzg.cbpt.cnki.net · 2025-10-14 · 核验于 2026-10-20
- 25论文 Greedy Function Approximation: A Gradient Boosting Machine · Annals of Statistics, 29(5), 1189–1232 · 2001-10-01 · 核验于 2026-10-20
- 26论文 Causal Interpretations of Black-Box Models · Journal of Business & Economic Statistics, 39(1):272-281 · 2021-01-01 · 核验于 2026-10-20
- 27论文 Causality: Models, Reasoning, and Inference (2nd ed.) · Cambridge University Press · 2009-09-01 · 核验于 2026-10-20
- 28文档 sklearn.inspection.partial_dependence — scikit-learn documentation · scikit-learn · 2024-01-01 · 核验于 2026-10-20
- 29文档 sklearn.inspection.plot_partial_dependence — scikit-learn 0.23.2 documentation · Scikit-learn · 2020-09-01 · 核验于 2026-10-20
- 30文档 Minitab Statistical Software 帮助文档:Predictor Importance 与 Partial Dependence Plot · Minitab, LLC · 2024-01-01 · 核验于 2026-10-20
- 31文档 Help for package pdp · The Comprehensive R Archive Network · 2026-01-22 · 核验于 2026-10-20
- 32文档 Index of /web/packages/pdp/readme · The Comprehensive R Archive Network · 2026-05-08 · 核验于 2026-10-20
- 33文档 Index of /web/packages/pdp/readme · Universitas Syiah Kuala · 2026-05-08 · 核验于 2026-10-20
- 34文档 MATLAB partialDependence · MathWorks · 2024-01-01 · 核验于 2026-10-20
- 35论文 Explainable Emotion Recognition from Speech: A Review · IEEE Access · 2021-12-20 · 核验于 2026-10-20
- 36论文 The INTERSPEECH 2009 Emotion Challenge · INTERSPEECH 2009 / ISCA · 2009-09-06 · 核验于 2026-10-20
- 37论文 Visualizing the Effects of Predictor Variables in Black Box Supervised Learning Models (ALE plots) · Journal of the Royal Statistical Society: Series B · 2020-06-01 · 核验于 2026-10-20
- 38论文 IEMOCAP: Interactive Emotional Dyadic Motion Capture Database · Language Resources and Evaluation, vol. 42 · 2008-11-01 · 核验于 2026-10-20
- 39文档 PartialDependenceDisplay — scikit-learn documentation · scikit-learn developers · 2024-01-01 · 核验于 2026-10-20
- 40文档 Partial Dependence Plots in Python — Kaggle / tutorial write-ups on house price models · Kaggle community notebooks · 2020-01-01 · 核验于 2026-10-20
- 41论文 Explainable Machine Learning in Credit Risk Management · Computational Economics · 2020-06-01 · 核验于 2026-10-20
- 42论文 Explainable AI for Credit Scoring: A Systematic Review · arXiv · 2021-05-19 · 核验于 2026-10-20
- 43论文 Explainable Machine Learning for Public Health: A Scoping Review · Journal of the American Medical Informatics Association · 2021-10-01 · 核验于 2026-10-20
- 44论文 Stop Explaining Black Box Machine Learning Models for High Stakes Decisions and Use Interpretable Models Instead · Nature Machine Intelligence · 2019-05-01 · 核验于 2026-10-20
- 45论文 Interpretable Machine Learning for Building Energy Prediction: A Review · Applied Energy · 2020-09-01 · 核验于 2026-10-20
- 46代码库 PDPbox: Python Partial Dependence Plot Toolbox · GitHub · 2020-01-01 · 核验于 2026-10-20
- 47论文 A Unified Approach to Interpreting Model Predictions · NeurIPS 2017 / arXiv:1705.07874 · 2017-11-01 · 核验于 2026-10-20
- 48文档 Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8: Partial Dependence Plot and Chapter 9: Shapley Values · Christoph Molnar · 2022-01-01 · 核验于 2026-10-20
- 49文档 SHAP documentation: SHAP dependence plots · SHAP (shap.readthedocs.io) · 2024-01-01 · 核验于 2026-10-20
- 50论文 Consistent Individualized Feature Attribution for Tree Ensembles · arXiv:1802.03888 · 2018-02-12 · 核验于 2026-10-20
- 51论文 Model-agnostic Feature Importance and Effects with Dependent Features–A Conditional Subgroup Approach · arXiv · 2020-06-08 · 核验于 2026-10-20
- 52文档 中小跨径常规体系连续梁桥地震反应的机器学习预测及可解释性比较研究 · 中国公路学报 · 2025-08-03 · 核验于 2026-10-20
- 53文档 Interpretable Machine Learning: A Guide for Making Black Box Models Explainable (2nd ed.), Chapter 8.3 Accumulated Local Effects · Christoph Molnar · 2022-01-01 · 核验于 2026-10-20
- 54文档 R: Accumulated Local Effect Plot (ALE) · R Project · 2024-01-01 · 核验于 2026-10-20
- 55论文 Visualizing the Effects of Predictor Variables in Black Box Supervised Learning Models (ALE plots) · Journal of the Royal Statistical Society: Series B, 82(4):1059–1086 · 2020-09-01 · 核验于 2026-10-20
- 56论文 Unrestricted Permutation forces Extrapolation: Variable Importance Requires at least One More Model or There Is No Free Variable Importance · arXiv · 2019-05-08 · 核验于 2026-10-20
- 57论文 1INTRODUCTION · arXiv · 2022-08-12 · 核验于 2026-10-20
- 58代码库 pdp: Partial Dependence Plots (R package) · CRAN · 2023-01-01 · 核验于 2026-10-20
- 59论文 Hooker, Mentch & Zhou, Unrestricted Permutation Forces Extrapolation: Variable Importance Requires at Least One More Model, or There Is No Free Variable Importance · arXiv:1905.03151 · 2019-05-08 · 核验于 2026-10-20