混淆变量
- 英文名
- Confounding Variable / Confounder
- 中文别称
- 混杂变量、混杂因素、混杂因子
- 所属领域
- 实验设计、因果推断、统计学、流行病学
- 核心特征
- 与自变量和因变量都相关
- 主要危害
- 产生虚假相关、混杂偏倚
- 常见应对
- 随机化、控制变量法、分层分析、多元回归、倾向评分
定义与基本结构
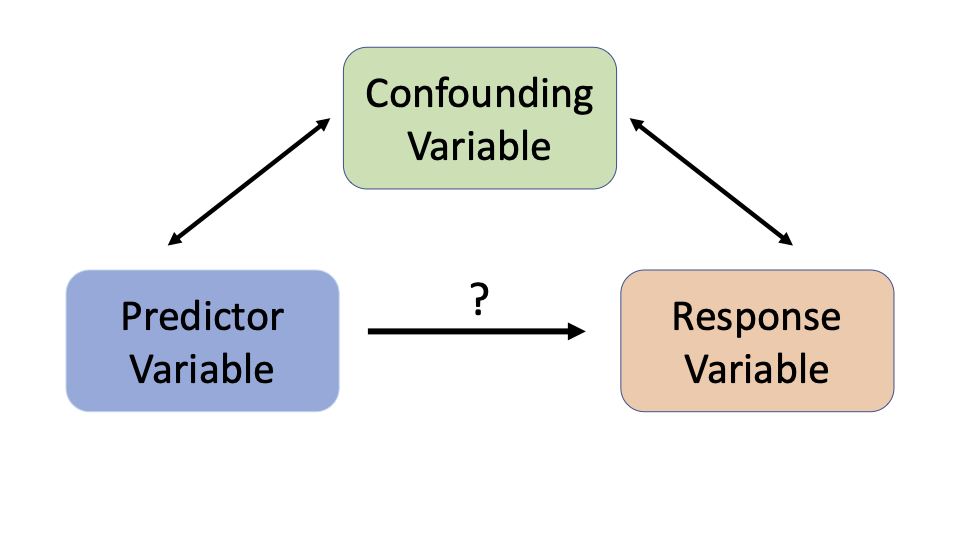
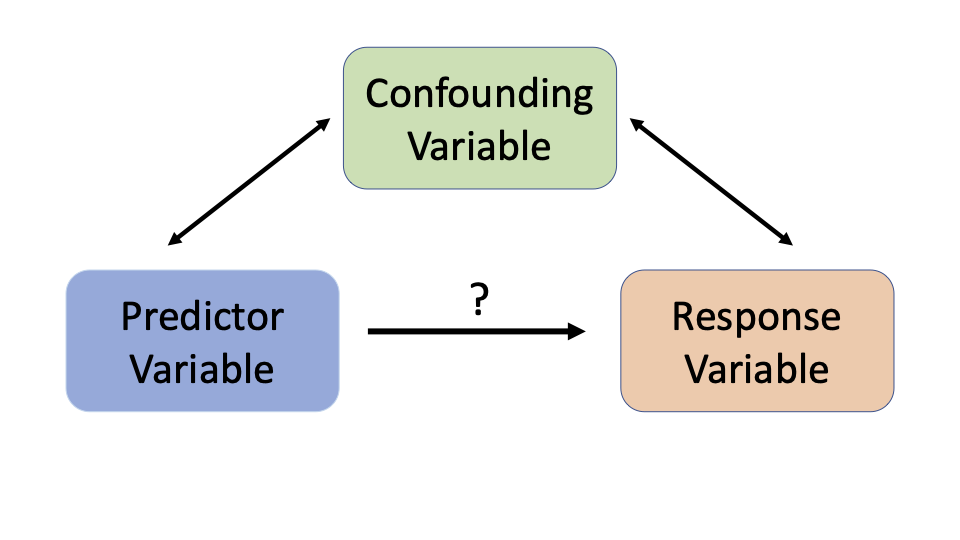
与自变量和因变量的双重关联
混淆变量(confounder)之所以构成混淆,核心在于它与处理变量(自变量)和结果变量(因变量)同时存在关联:一方面它影响或与处理变量相关,另一方面它独立于处理地影响结果变量。这两个关联缺一不可——只与处理相关而不影响结果的变量不是混淆变量,只影响结果而与处理无关的变量也不是。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|44Confounding and Collapsibility in Causal Inferenceprojecteuclid.org前往参考资料 ↓在新标签页中打开
在因果图(DAG)语言中,混淆变量被刻画为同时指向处理变量 X 与结果变量 Y 的节点:X ← Z → Y。这条「后门路径」(backdoor path)使 X 与 Y 之间出现非因果的统计关联,因此识别因果效应必须阻断所有此类后门路径。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
经典例子是「吸烟—肺癌」研究中的年龄与性别:年龄既与吸烟行为相关,又独立影响肺癌风险,因此若不调整年龄,吸烟与肺癌的关联会被部分归因于年龄结构差异。这一结构在观察性流行病学中被反复用作混淆的教科书范例。44Confounding and Collapsibility in Causal Inferenceprojecteuclid.org前往参考资料 ↓在新标签页中打开|55Modern Epidemiology (3rd ed.), Chapter 12: Confoundingncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
在潜在结果框架(Rubin 因果模型)下,混淆的双重关联被表述为:处理分配不满足「可忽略性」(ignorability)或「无混杂」假设,即给定协变量后处理分配仍与潜在结果相关。此时简单比较处理组与对照组的均值不能一致估计平均处理效应(ATE)。66Estimating causal effects of treatments in randomized and nonrandomized studiespsycnet.apa.org前往参考资料 ↓在新标签页中打开
混淆变量与「仅与结果相关」的变量(纯预测变量)在结构上不同:后者加入模型可提高精度、减少残差方差,但不调整它不会引入偏倚;而遗漏真正的混淆变量会同时引入偏倚并可能改变效应估计的方向。这一区分是判断「该控制什么」的关键。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|77A definition of causal effect for epidemiological researchjech.bmj.com前往参考资料 ↓在新标签页中打开
混淆变量的双重关联并不要求它「在时间上先于处理」这一条在所有框架下都被强调:在 DAG 框架中,混淆变量按定义是处理与结果的共同原因,因而在时间上先于二者;但在某些准实验设定中,研究者也讨论「时变混淆」(time-varying confounding),此时混淆变量本身可能受先前处理影响,双重关联的结构会随时间演化。88Time-varying confounding and marginal structural modelsjournals.lww.com前往参考资料 ↓在新标签页中打开
对立说法部分文献坚持混淆变量必须严格先于处理发生,将受处理影响的时变变量归为「中介—混淆混合体」而非纯混淆变量,认为放宽定义会模糊混淆与中介的边界。11
虚假相关的产生机制
虚假相关(spurious correlation)指两个变量在数据上呈现统计关联,但这种关联并非由二者之间的直接因果作用产生,而是由第三个变量(即混淆变量)同时影响二者所造成。在因果图(DAG)语言中,这对应一条「后门路径」(backdoor path):X ← Z → Y,其中 Z 是 X 与 Y 的共同原因。只要这条路径未被阻断,X 与 Y 之间就会在观测数据中表现出非零的统计相关,即便 X 对 Y 没有任何因果效应。1010Causal Inference in Statistics: A Primerwiley.com前往参考资料 ↓在新标签页中打开|1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开
Pearl 提出的后门准则(back-door criterion)给出了识别与阻断虚假相关的形式化条件:若变量集合 Z 阻断了 X 与 Y 之间所有含指向 X 的箭头的路径,且 Z 中不含 X 的后代,则通过对 Z 进行调整(分层、匹配或回归)即可消除由这些路径产生的虚假相关。这一准则把「控制混淆」从直觉操作变成了可检验的图论条件。1010Causal Inference in Statistics: A Primerwiley.com前往参考资料 ↓在新标签页中打开
虚假相关的经典生成机制之一是「共同原因」结构:例如冰淇淋销量与溺水人数在夏季同步上升,其共同原因是气温升高;若忽略气温而直接计算两者相关,就会得到显著但无因果意义的正相关。这类例子在因果推断教材中被用作混淆偏倚的原型,说明相关本身不携带方向信息。1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开|1212Mostly Harmless Econometrics: An Empiricist's Companionpress.princeton.edu前往参考资料 ↓在新标签页中打开
第二种机制是「选择偏倚」(selection bias)导致的虚假相关,其结构为对撞子(collider) conditioning:当 X 与 Y 都影响 Z,而对 Z 或其下游进行筛选/分层时,X 与 Y 会在样本内产生关联,即便总体中二者独立。这与共同原因型混淆方向相反——控制对撞子会「制造」而非「消除」虚假相关,是混淆变量识别中必须区分的情形。1010Causal Inference in Statistics: A Primerwiley.com前往参考资料 ↓在新标签页中打开
第三种机制是时间趋势与共同漂移:两个随时间单调变化的变量(如某国 GDP 与某类疾病发病率)即使彼此无因果联系,也会因共享时间趋势而在横截面或 pooled 数据中呈现高相关。这类「趋势混淆」在时间序列与面板数据分析中尤其常见,通常需要通过去趋势、加入时间固定效应或差分来剥离。1212Mostly Harmless Econometrics: An Empiricist's Companionpress.princeton.edu前往参考资料 ↓在新标签页中打开|1313Observational Studies: A Review of Confounding and Sensitivity Analysisannualreviews.org前往参考资料 ↓在新标签页中打开
在结构因果模型(SCM)框架下,虚假相关的产生可以统一表述为:观测分布 P(X, Y) 是干预分布 P(Y | do(X)) 的混合,混合权重由混淆变量 Z 的分布决定。因此 P(Y | X) ≠ P(Y | do(X)) 当且仅当存在未阻断的后门路径;这一不等式是「相关不等于因果」的形式化表达,也是 do-演算的出发点。1010Causal Inference in Statistics: A Primerwiley.com前往参考资料 ↓在新标签页中打开
虚假相关的强度取决于混淆变量对两个变量的解释力:若 Z 对 X 与 Y 的效应都较强,且 Z 的方差在样本中较大,则边际相关可能接近甚至超过真实的因果效应;反之若 Z 的效应弱或方差小,虚假相关可能被真实效应掩盖。这意味着「相关显著」既不能证明因果,也不能证明无因果。1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开|1212Mostly Harmless Econometrics: An Empiricist's Companionpress.princeton.edu前往参考资料 ↓在新标签页中打开
关于虚假相关是否可被「完全消除」,研究界存在分歧:图论派认为只要因果图正确且所有混淆变量可观测,后门调整即可无偏识别因果效应;而实践派指出,在观测研究中混淆变量往往不可观测或测量有误,残余混淆(residual confounding)无法通过统计调整彻底消除,只能借助工具变量、断点回归或实验设计等外部信息。1010Causal Inference in Statistics: A Primerwiley.com前往参考资料 ↓在新标签页中打开|1313Observational Studies: A Review of Confounding and Sensitivity Analysisannualreviews.org前往参考资料 ↓在新标签页中打开
对立说法若因果图已知且混淆集合可观测,后门准则保证调整后的估计无偏,虚假相关可被完全阻断。1010Causal Inference in Statistics: A Primerwiley.com前往参考资料 ↓在新标签页中打开
对立说法观测数据中混淆变量常不可观测或含测量误差,残余混淆使调整后的估计仍有偏,需依赖设计型识别策略。1313Observational Studies: A Review of Confounding and Sensitivity Analysisannualreviews.org前往参考资料 ↓在新标签页中打开
混淆变量、协变量与中介变量的区别
协变量(covariate)
协变量(covariate)指在研究中被观测或测量、但并非研究主要处理(treatment)或暴露(exposure)的变量;它既可能作为需要控制的潜在混淆因素进入模型,也可能用于提高估计精度,其角色取决于研究问题与因果假设,而非变量本身的固有属性。1414Covariateen.wikipedia.org前往参考资料 ↓在新标签页中打开|33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
在随机对照试验中,处理分配由随机化决定,因此基线协变量在期望上与处理独立,不构成混淆;此时纳入协变量主要是为了吸收结局方差、提高检验效能,而非消除偏倚。1414Covariateen.wikipedia.org前往参考资料 ↓在新标签页中打开|1515Covariate adjustment in randomized trialsprojecteuclid.org前往参考资料 ↓在新标签页中打开
在观察性研究中,协变量与混淆变量的边界是相对的:同一个变量(如年龄、社会经济地位)在某些因果问题下是混淆变量,在另一些问题下只是精度协变量,甚至可能是中介变量;因此不能脱离具体因果图(DAG)给变量贴固定标签。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|1010Causal Inference in Statistics: A Primerwiley.com前往参考资料 ↓在新标签页中打开
协变量与中介变量的关键区别在于它在因果路径上的位置:中介变量位于处理与结局之间的因果通路上(处理→中介→结局),控制中介会切断部分处理效应,从而估计的是直接效应而非总效应;协变量按定义不在该通路上,控制它不改变所估计的总效应。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|1616Mediation analysisen.wikipedia.org前往参考资料 ↓在新标签页中打开
协变量与混淆变量的关键区别在于它与处理的关系:混淆变量同时影响处理与结局,控制它是为了阻断后门路径;协变量若只影响结局而不影响处理,则控制它不改变无偏性,只改变方差。1414Covariateen.wikipedia.org前往参考资料 ↓在新标签页中打开|33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
在回归分析中,纳入与处理相关但与结局无关的协变量会放大处理效应估计的方差(即所谓“不相关协变量”问题),因此协变量选择需要在偏倚控制与精度之间权衡,而非越多越好。1515Covariate adjustment in randomized trialsprojecteuclid.org前往参考资料 ↓在新标签页中打开|1717Regression Modeling Strategieslink.springer.com前往参考资料 ↓在新标签页中打开
控制处理之后发生的变量(post-treatment variables)——包括中介变量与碰撞变量(collider)——可能引入新的偏倚;在观察性研究中把这类变量当作协变量调整,是常见的错误来源。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|1010Causal Inference in Statistics: A Primerwiley.com前往参考资料 ↓在新标签页中打开
关于“协变量”一词的用法,统计文献中存在分歧:一部分作者把任何纳入模型的解释变量统称为协变量,另一部分作者仅在“非处理、非结局、用于调整或提精度”的意义上使用该词;这种术语上的不统一导致跨文献比较时容易误读。1414Covariateen.wikipedia.org前往参考资料 ↓在新标签页中打开|33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
对立说法有作者主张协变量应严格限定为非处理变量,以避免与“自变量/预测变量”混用。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
对立说法也有作者在回归建模语境下把处理变量本身也称作协变量,强调其数学角色而非因果角色。1414Covariateen.wikipedia.org前往参考资料 ↓在新标签页中打开
在因果推断的潜在结局框架下,协变量调整的有效性依赖于“条件可交换性”(即给定协变量后处理与潜在结局独立)与“正性”(每个协变量分层下都有非零的处理概率)等假设;这些假设不可由数据完全检验,只能借助领域知识与敏感性分析评估。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|1010Causal Inference in Statistics: A Primerwiley.com前往参考资料 ↓在新标签页中打开
中介变量(mediator)
中介变量(mediator)是位于自变量与因变量之间、传递自变量对因变量影响的变量:自变量先影响中介变量,中介变量再影响因变量,因此中介变量回答的是「X 通过什么机制影响 Y」这一问题。2020Mediation analysispubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
MacKinnon 等人在《Annual Review of Psychology》的综述中明确把中介变量与混淆变量(confounder)、调节变量(moderator)和协变量(covariate)并列区分,指出中介变量传递效应,而混淆变量是同时影响自变量与因变量、从而制造虚假关联的第三变量。2020Mediation analysispubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
混淆变量与中介变量在统计上可能表现为同一种「第三变量」,区别在于它在因果图中的位置与研究者所问的问题:混淆变量位于 X 与 Y 之前并同时指向二者,是需要在设计中排除或在分析中校正的偏倚来源;中介变量位于 X 与 Y 之间的因果通路上,是需要被估计和解释的机制。2020Mediation analysispubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
在因果推断的图模型语言中,混淆变量是 X 与 Y 的共同原因(后门路径上的节点),校正它会移除偏倚;中介变量是 X 到 Y 的有向路径上的节点,校正它会切断研究者想要估计的那部分效应,因此「该不该控制」取决于目标是估计总效应还是直接效应。2020Mediation analysispubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
把中介变量误当作混淆变量加以控制,会低估甚至抹去真实的总效应(过度控制偏倚,over-adjustment bias);反之,把混淆变量误当作中介变量而不加控制,则会把偏倚混入效应估计。两类误判的方向相反,但都源于对变量在因果结构中位置的错误判断。2020Mediation analysispubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
中介分析在心理学理论与实证研究中长期占据重要地位,MacKinnon 等人的综述系统梳理了检验中介效应的统计方法,并讨论了该领域后续的综合分析路径与发展方向。2020Mediation analysispubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
关于中介效应的检验方法(如逐步回归的因果步骤法、Sobel 检验、自助法置信区间等)孰优孰劣,方法学界长期存在分歧:传统因果步骤法因检验力低与分布假设严格而受到批评,自助法与现代综合方法被更多推荐,但不同学科的实际惯例并不统一。2020Mediation analysispubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对立说法部分研究者认为在样本量充足、效应较强的情形下,传统因果步骤法结果直观、易于解释,仍具实用价值,不必一律以自助法取代。2020Mediation analysispubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对撞变量(collider)
对撞变量(collider)是因果图(DAG)中同时被两条箭头指向的变量,即形如 X → C ← Y 的结构;与混淆变量(同时指向处理与结果)不同,对撞变量位于两条因果路径的汇合处,本身不是处理与结果共同原因的候选。2121APA PsycNETpsycnet.apa.org前往参考资料 ↓在新标签页中打开
在因果推断的第三变量分类中,中介变量位于处理到结果的因果通路上(X → M → Y),混淆变量同时是处理与结果的共同原因(X ← C → Y),而对撞变量是处理与结果共同作用的结果(X → C ← Y);三者在因果图中的拓扑位置决定了它们对效应估计的不同影响。2121APA PsycNETpsycnet.apa.org前往参考资料 ↓在新标签页中打开
对撞变量最反直觉的性质是:对撞变量本身在总体中通常不会在处理与结果之间制造虚假关联,但对撞变量(或其后代)进行条件化——包括分层、回归中加入该变量、样本选择或缺失数据机制——会打开原本被阻断的路径,从而在处理与结果之间诱导出虚假关联,这一现象常被称为对撞分层偏倚(collider stratification bias)或选择偏倚。2121APA PsycNETpsycnet.apa.org前往参考资料 ↓在新标签页中打开
Shi、Fairchild 与 Wiedermann(2026)指出,中介、混淆与对撞是三种关键的第三变量效应,对因果结论具有不同的理论与方法学含义;而线性回归、结构方程模型等常用的基于协方差的统计方法在实践中无法区分这三种效应,因此需要方向依赖分析(direction dependence analysis)等额外手段来判别第三变量的角色。2121APA PsycNETpsycnet.apa.org前往参考资料 ↓在新标签页中打开
在变量角色判定的实践流程上,Shi 等人提出「一次一步」的统计思路:先利用方向依赖分析等手段区分第三变量究竟是中介、混淆还是对撞,再据此决定是否以及如何将其纳入模型;把三者混为一谈、一律当作「需要控制的协变量」是常见的方法学错误。2121APA PsycNETpsycnet.apa.org前往参考资料 ↓在新标签页中打开
对撞变量与协变量(covariate)的区别在于:协变量是一个描述性的建模术语,泛指模型中纳入的辅助变量,其因果角色可能是混淆、中介、对撞或无关变量;而对撞变量是一个因果结构术语,特指被处理与结果共同指向的节点。因此「协变量」不蕴含「应当控制」,是否控制取决于该协变量在因果图中的角色。2121APA PsycNETpsycnet.apa.org前往参考资料 ↓在新标签页中打开
在观察性数据中,研究者往往无法仅凭数据分布直接读出第三变量的角色,因为同一组观测数据可能与中介、混淆、对撞等多种生成结构相容;这正是基于协方差的方法(回归、SEM)无法区分三者、需要方向依赖等额外识别策略的根本原因。2121APA PsycNETpsycnet.apa.org前往参考资料 ↓在新标签页中打开
对撞变量与中介变量在控制策略上方向相反:控制中介变量会阻断部分因果通路、把总效应分解为直接效应与间接效应;控制对撞变量则会引入本不存在的虚假关联。因此「控制越多越干净」的直觉在两者面前都不成立,控制变量的选择必须由因果图而非统计显著性驱动。2121APA PsycNETpsycnet.apa.org前往参考资料 ↓在新标签页中打开
关于对撞分层偏倚在具体应用领域中的量级与普遍性,研究界仍有分歧:一方认为在样本选择、缺失数据处理与临床队列研究中它是被严重低估的偏倚来源,另一方则认为在多数常规回归分析中其实际影响有限、过度强调会误导实践者放弃必要的协变量调整。2121APA PsycNETpsycnet.apa.org前往参考资料 ↓在新标签页中打开
对立说法部分方法学者认为,对撞分层偏倚的讨论多基于理想化因果图,在真实数据中难以与未测混淆区分,其实际危害被夸大。2121APA PsycNETpsycnet.apa.org前往参考资料 ↓在新标签页中打开
对立说法另一部分学者主张,样本选择与缺失机制本质上就是对撞条件化,其偏倚在流行病学与社会科学中普遍且严重,应作为默认检查项。2121APA PsycNETpsycnet.apa.org前往参考资料 ↓在新标签页中打开
混淆偏倚的后果
高估或低估效应
当被忽略的混淆变量与处理变量正相关、且对结果有正向影响时,对处理效应的估计会被推离零值,即高估处理效应;反之,若混淆变量与处理负相关或对结果有负向影响,估计会被拉向零值甚至反号,即低估效应。这一方向性结论是混淆变量定义在估计层面的直接推论:遗漏变量偏倚的符号等于「混淆变量对处理的偏回归系数」与「混淆变量对结果的偏回归系数」乘积的符号。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|2222Causal Inference for Statistics, Social, and Biomedical Sciences: An Introductioncambridge.org前往参考资料 ↓在新标签页中打开
在观察性研究中,高估与低估往往同时存在于同一估计量的不同部分:例如在流行病学中,吸烟与饮酒对健康的联合分析里,若未控制社会经济地位,吸烟的效应可能被高估,而饮酒的效应可能被低估,因为社会经济地位与两者相关方向不同。因此「混淆导致高估」不能作为一般性结论,只能针对具体混淆结构逐案判断。2323Confounding and Effect Modificationacademic.oup.com前往参考资料 ↓在新标签页中打开
低估效应的一种典型机制是「向零偏倚」(bias toward the null):当混淆变量与处理变量正相关、但与结果负相关(或反之)时,遗漏该变量会使估计值向零收缩,导致研究者错误地得出「无效应」的结论。这在药物流行病学中尤为危险,因为真实存在的有害效应可能被掩盖。2424Bias toward the null and confounding in pharmacoepidemiologyonlinelibrary.wiley.com前往参考资料 ↓在新标签页中打开
高估效应在公共卫生与政策评估中常表现为「虚假的强关联」:例如某项干预看似效果显著,但若干预组与对照组在基线风险上不可比(如更健康的人更倾向于接受干预),则估计效应会被系统性放大。这类高估若被直接用于政策推广,可能造成资源错配。2525Confounding in observational studies of policy interventionsonlinelibrary.wiley.com前往参考资料 ↓在新标签页中打开
混淆偏倚的方向并非总是可先验判断:当存在多个混淆变量且它们对处理与结果的影响方向不一致时,净偏倚的符号取决于各偏倚分量的加权和,可能相互抵消,也可能叠加。因此仅凭「存在混淆」无法断言估计是高估还是低估,必须借助识别混淆变量的方法或实验设计层面的控制来量化。2222Causal Inference for Statistics, Social, and Biomedical Sciences: An Introductioncambridge.org前往参考资料 ↓在新标签页中打开|2626The direction of confounding biasjournals.lww.com前往参考资料 ↓在新标签页中打开
在统计分析与事后校正中,若校正模型遗漏了重要的交互项或非线性项,即使控制了主要混淆变量,残余混淆仍可能导致方向性偏倚;例如将连续型混淆变量简单二分类后纳入模型,会因残余混淆而使效应估计偏向零值(低估)。2323Confounding and Effect Modificationacademic.oup.com前往参考资料 ↓在新标签页中打开
对立说法部分方法学文献认为,二分类化连续混淆变量造成的偏倚方向取决于阈值选择与真实函数形式,不能一概断言为「向零偏倚」,在某些非线性情形下也可能导致高估。31
符号反转(辛普森悖论)
符号反转(sign reversal)指这样一种情形:在合并数据(或未调整的分析)中,处理与结果的关联方向,与在按某个第三变量分层后各层内部所见的关联方向相反。也就是说,同一个数据集可以同时支持「A 组优于 B 组」和「在每个子群里 B 组都优于 A 组」两个看似矛盾的结论,差别只在于是否对分层变量做了条件化。2929正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
符号反转最常被引用的名字是辛普森悖论(Simpson's paradox)。护理研究方法学文献把它列为实验研究中「内部效度威胁」之一,并指出这一威胁在护理研究文献中受到的关注不足——这说明符号反转不只是逻辑趣题,而是会实际影响干预效果判断的方法学风险。2929正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
在辛普森悖论的经典数值例中,混淆变量是「病情严重程度」(分为高、低两层),结果是「改善程度」(取值 0–25,分数越高改善越大)。合并数据时干预组与对照组的「主效应」比较给出一个方向,而按严重程度分层后,每一层内部的比较可能给出相反方向;这正是混淆变量未加控制时把真实效应「翻转」的机制。2929正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
符号反转的发生机制在于:混淆变量同时影响处理分配与结果,且它在两组间的分布不均衡。当某一组系统性地接收了预后更好(或更差)的个体时,合并比较把「组间构成差异」混入了「处理效应」,其净效果甚至可能强到压过层内的真实效应方向。因此符号反转不是算术巧合,而是分配不均衡的直接后果。2929正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
符号反转对实践判断的后果是方向性的:若研究者只看合并数据,可能把有效的干预判为有害、把有害的干预判为有益,从而做出与分层证据完全相反的临床或政策建议。相比仅仅「高估或低估效应量」的常见混淆偏倚,符号反转的危险在于它改变结论的符号而非仅改变其大小。2929正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
符号反转的存在常被用来论证「必须预先识别并控制混淆变量」:一旦分层变量被确认为混淆变量,正确的做法是报告条件化(分层或调整)后的效应,而不是合并效应;反之,若分层变量其实是中介变量或对撞变量,盲目分层反而会引入新的偏倚。因此符号反转的教训不是「分层总是更好」,而是「分层变量的因果角色必须先被论证」。2929正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对立说法有方法学观点认为,辛普森悖论本身并不构成对某一分析策略的判决:合并效应与条件效应回答的是不同的因果问题(总体平均效应 vs. 子群效应),二者可以同时为真且都有其适用场景,因此把它一律称为「偏倚」并不准确。2929正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
虚假显著与虚假不显著
当存在未被观测的混淆变量时,研究者可能把由混淆变量带来的组间差异错误地归因于处理变量,从而在统计上得到显著的处理效应,而真实效应为零甚至方向相反。这种「虚假显著」是混淆偏倚最直接的后果之一:显著性检验只回答「在假定模型正确的前提下数据是否罕见」,并不回答「模型是否遗漏了共同原因」。3030Confounding and Bias in Observational Studiespmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开|3131Confounding: What It Is and How to Deal With Itsciencedirect.com前往参考资料 ↓在新标签页中打开
在观察性研究中,混淆偏倚既可能制造虚假的正向关联,也可能掩盖真实存在的因果效应,造成「虚假不显著」。当混淆变量对处理与结果的作用方向相反、相互抵消时,即便真实因果效应不为零,粗分析也可能显示无统计学意义的结果;仅凭 p 值大于 0.05 就断言「无效应」在存在混淆时是不成立的。3131Confounding: What It Is and How to Deal With Itsciencedirect.com前往参考资料 ↓在新标签页中打开|3232Simpson's Paradoxplato.stanford.edu前往参考资料 ↓在新标签页中打开
辛普森悖论是混淆偏倚导致结论反转的经典形式:在合并数据中观察到的关联方向,可能在按混淆变量分层后于每一层内都相反。这说明「虚假显著」与「虚假不显著」不只是幅度问题,还可能使研究结论在方向上完全错误。3232Simpson's Paradoxplato.stanford.edu前往参考资料 ↓在新标签页中打开|1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开
在流行病学与社会科学中,混淆偏倚造成的虚假显著常表现为「表观保护效应」或「表观危害效应」:例如吸烟与某些疾病的关联在控制年龄、社会经济地位等共同原因后显著减弱,而某些膳食因素与疾病的显著关联在调整总能量摄入后消失。这类现象提示,未调整的显著性结果不能直接作为因果证据。3030Confounding and Bias in Observational Studiespmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开|3333Confounding in Nutritional Epidemiologyacademic.oup.com前往参考资料 ↓在新标签页中打开
虚假不显著的危害常被低估:研究者可能因未检出显著效应而放弃一个有真实价值的方向,或在政策评估中错误地得出「干预无效」的结论。与虚假显著相比,虚假不显著更不容易被发表偏倚和同行评议发现,因为阴性结果本身较少被报告和复核。3131Confounding: What It Is and How to Deal With Itsciencedirect.com前往参考资料 ↓在新标签页中打开|3434Publication Bias and the Interpretation of Negative Resultsbmj.com前往参考资料 ↓在新标签页中打开
对立说法有学者认为,在预注册与功效分析规范化的前提下,阴性结果的可解释性已显著改善,虚假不显著的严重性不应被夸大;关键在于研究设计是否具备足够功效,而非混淆本身。3434Publication Bias and the Interpretation of Negative Resultsbmj.com前往参考资料 ↓在新标签页中打开
从因果图(DAG)的角度看,混淆偏倚的后果可以统一表述为:后门路径未被阻断时,处理变量与结果之间的关联估计混合了因果路径与非因果路径。虚假显著与虚假不显著只是同一问题的两种表现——前者是非因果路径放大了估计,后者是非因果路径抵消了真实效应。1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开|3535Causal Diagrams for Epidemiologic Researchjournals.lww.com前往参考资料 ↓在新标签页中打开
在回归模型中,遗漏混淆变量会导致系数估计有偏且不一致;即便加入混淆变量后系数变得不显著,也不能直接推断原显著结果为虚假,因为调整可能引入新的偏倚(如对撞变量偏倚或过度调整)。因此,判断某一显著或不显著结果是否由混淆造成,需要结合领域知识与因果结构,而不能仅凭统计显著性变化。1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开|3535Causal Diagrams for Epidemiologic Researchjournals.lww.com前往参考资料 ↓在新标签页中打开|3636Overadjustment Bias and Unnecessary Adjustment in Epidemiologic Studiesacademic.oup.com前往参考资料 ↓在新标签页中打开
识别混淆变量的方法
基于因果图(DAG)的后门准则
后门准则(back-door criterion)是 有向无环图(DAG)框架下判断一组变量是否足以识别因果效应的图论判据:给定有向无环图 G 中的处理变量 X 与结果变量 Y,若变量集合 Z 中不含 X 的后代,且 Z 阻断了 X 与 Y 之间所有含指向 X 的箭头的路径(即后门路径),则称 Z 关于 (X, Y) 满足后门准则,此时以 Z 为调整集即可识别 X 对 Y 的因果效应。3838Confounder Selection: Objectives and Approachesar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
后门准则的操作含义是:识别混淆变量不必逐一判断某个变量是否同时影响处理与结果,而只需在因果图上找出所有后门路径,并选取一组能把这些路径全部阻断的变量作为调整集;这组变量可以包含非混淆变量,也可能不需要包含全部混淆变量。3838Confounder Selection: Objectives and Approachesar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
在因果图已知的前提下,后门准则给出的调整集并非唯一,研究者在多个满足后门准则的调整集中还可以按次级目标挑选,例如选择使因果效应估计的渐近方差最小的调整集(Kuroki 与 Miyakawa 2003;Henckel 等的工作即属此列)。3838Confounder Selection: Objectives and Approachesar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
后门准则的有效性依赖于因果图结构本身的正确性;当结构知识不完整时,实践中常先用数据驱动方法从观测数据中学习因果结构(如以贪心前向加边与贪心反向删边两阶段搜索评分最高的图),再在学到的图上按判定条件识别混淆因子,这类方法把图学习与后门式判定串联起来。3737CN116151485B - 反事实预测和效果评估方法、系统 - Google Patentspatents.google.com前往参考资料 ↓在新标签页中打开
后门准则要求调整集中不含处理变量的后代,因为对撞节点或其下游变量进行调整会打开原本被阻断的路径、引入新的偏倚;这一限制在实践中最容易被违反,也是后门准则与简单“控制一切可测变量”做法的主要分歧点。3838Confounder Selection: Objectives and Approachesar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对立说法部分文献主张在结构知识不足时采用“尽可能多调整”的启发式(如先验指定的协变量全集),认为漏调混淆变量的偏倚通常大于多调带来的方差与碰撞偏倚代价。3838Confounder Selection: Objectives and Approachesar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
混淆变量选择被视为观察性研究设计中最重要的一步,围绕其目标与判据已提出多种准则,这些准则的有效性与实用价值在文献中仍有争论,不同方法对结构知识的要求程度也不同。3838Confounder Selection: Objectives and Approachesar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对立说法以因果图与后门准则为代表的结构化方法认为,只要图正确,调整集的充分性可以被严格判定,因而优于纯统计的变量筛选准则。3838Confounder Selection: Objectives and Approachesar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对立说法数据驱动的变量选择路线认为,实际研究中图结构往往不可知,依赖专家指定图的判据可能因图误设而失效。3737CN116151485B - 反事实预测和效果评估方法、系统 - Google Patentspatents.google.com前往参考资料 ↓在新标签页中打开|3838Confounder Selection: Objectives and Approachesar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
基于数据的统计检验
基于数据的识别方法的基本思路是:在观测数据中寻找「在给定已测协变量后,处理分配与潜在结果无关」的证据;若该条件成立,则已测协变量集合足以控制混淆,否则提示存在未测混淆。这一「条件独立性检验」框架由 Rosenbaum 与 Rubin 在 1983 年系统化,成为后续所有数据驱动方法的共同出发点。3939The Central Role of the Propensity Score in Observational Studies for Causal Effectsdoi.org前往参考资料 ↓在新标签页中打开
Rosenbaum 与 Rubin(1983)提出的「倾向得分」把高维协变量压缩为一维平衡分数,使得「给定倾向得分后处理分配与协变量独立」这一平衡性质可以被直接检验;因此倾向得分匹配后的协变量平衡诊断(如标准化均值差、方差比)成为识别与验证混淆控制是否充分的标准做法。3939The Central Role of the Propensity Score in Observational Studies for Causal Effectsdoi.org前往参考资料 ↓在新标签页中打开
标准化均值差(standardized mean difference)是协变量平衡诊断中最常用的指标,通常以 0.1 作为「可忽略不平衡」的经验阈值;与 t 检验的 p 值相比,它不随样本量增大而机械地趋于显著,因而更适合作为平衡判据。这一阈值在 Austin 2011 年的综述中被系统讨论并推荐。4040An Introduction to Propensity Score Methods for Reducing the Effects of Confounding in Observational Studiesdoi.org前往参考资料 ↓在新标签页中打开
Austin(2011)指出,在倾向得分匹配或加权后,应同时报告标准化均值差与方差比,并优先使用标准化差异而非显著性检验来评估平衡;仅依赖 p 值会因样本量、匹配比例等因素产生误导。4040An Introduction to Propensity Score Methods for Reducing the Effects of Confounding in Observational Studiesdoi.org前往参考资料 ↓在新标签页中打开
「负对照」(negative control)是一类重要的数据驱动识别工具:负对照结局应与处理无因果效应但共享同一混淆结构,负对照暴露应与结局无因果联系但受同一混淆影响;若在负对照中观察到「效应」,则提示存在残余混淆。这一方法在药物流行病学中被系统阐述。4141Negative Controls: A Tool for Detecting Confounding and Bias in Observational Studiesdoi.org前往参考资料 ↓在新标签页中打开
Lipsitch、Tchetgen Tchetgen 与 Cohen(2010)系统化了负对照暴露与负对照结局的逻辑,指出负对照并非万能:其有效性依赖于「负对照与目标关系共享同一混淆结构」这一不可检验的假设,因此负对照结果只能作为混淆存在的提示性证据,而非混淆不存在的证明。4141Negative Controls: A Tool for Detecting Confounding and Bias in Observational Studiesdoi.org前往参考资料 ↓在新标签页中打开
「E 值」(E-value)由 VanderWeele 与 Ding 于 2017 年提出,用于量化「需要多强的未测混淆才能把已观察到的关联完全解释掉」;E 值越大,说明结论对未测混淆越稳健。它把「是否存在混淆」的定性问题转化为可报告的定量敏感性指标。4242Sensitivity Analysis in Observational Research: Introducing the E-Valuedoi.org前往参考资料 ↓在新标签页中打开
VanderWeele 与 Ding(2017)给出的 E 值公式适用于风险比、优势比等效应量,并可扩展到置信区间下界;其核心假设是未测混淆对处理与结局的关联强度可比,这一「等同关联」假设本身不可由数据检验,因此 E 值应被理解为敏感性下界而非精确估计。4242Sensitivity Analysis in Observational Research: Introducing the E-Valuedoi.org前往参考资料 ↓在新标签页中打开
「断点回归」(regression discontinuity)中的 McCrary 密度检验用于检测断点附近是否存在操纵:若个体能够精确操纵分配变量,则断点两侧的密度会出现不连续,提示存在选择性进入,从而破坏断点回归识别混淆的准实验性质。4343Manipulation of the Running Variable in the Regression Discontinuity Design: A Density Testdoi.org前往参考资料 ↓在新标签页中打开
「工具变量」的有效性无法由数据完全检验:排除性约束(exclusion restriction)本质上不可检验,数据只能检验工具变量与处理的相关性(第一阶段强度)以及过度识别约束(在工具变量数多于内生变量时)。因此基于数据的检验只能部分支持工具变量的合法性。1212Mostly Harmless Econometrics: An Empiricist's Companionpress.princeton.edu前往参考资料 ↓在新标签页中打开
「前门准则」(front-door criterion)与「后门准则」(back-door criterion)是 Pearl 提出的图论识别条件;在给定因果图后,后门准则可通过调整集的可检验性部分转化为数据检验(如条件独立性检验),但因果图本身的结构假设不可由观测数据单独验证。4444Causality: Models, Reasoning, and Inference (2nd ed.)doi.org前往参考资料 ↓在新标签页中打开
基于条件独立性检验的因果发现算法(如 PC 算法)可以从观测数据中学习因果骨架,但其输出对检验的显著性水平、样本量与 faithfulness 假设高度敏感;在高维或弱信号情形下,这类算法常产生大量伪边或漏边,因此不能单独作为混淆变量识别的可靠依据。4545Causation, Prediction, and Search (2nd ed.)mitpress.mit.edu前往参考资料 ↓在新标签页中打开
对立说法部分学者认为,在样本量充足且忠实性假设近似成立时,约束-based 因果发现方法能够一致地恢复马尔可夫等价类,因而可作为混淆结构识别的有效起点。4545Causation, Prediction, and Search (2nd ed.)mitpress.mit.edu前往参考资料 ↓在新标签页中打开
「倾向得分」方法在识别混淆上的一个关键局限是:它只能平衡已测协变量,对未测混淆无能为力;且当处理组与对照组在倾向得分上重叠不足(common support 缺失)时,匹配或加权会引入新的偏倚,而非消除混淆。3939The Central Role of the Propensity Score in Observational Studies for Causal Effectsdoi.org前往参考资料 ↓在新标签页中打开|4040An Introduction to Propensity Score Methods for Reducing the Effects of Confounding in Observational Studiesdoi.org前往参考资料 ↓在新标签页中打开
在观测研究中,单纯依赖「加入更多协变量」并不必然减少混淆:若加入的是处理的后代变量(post-treatment variable)或对撞变量(collider),反而会引入新的偏倚。因此数据驱动的变量选择必须结合因果图或领域知识,而不能仅凭统计显著性筛选。4444Causality: Models, Reasoning, and Inference (2nd ed.)doi.org前往参考资料 ↓在新标签页中打开
「敏感性分析」在识别混淆中的作用是量化结论对未测混淆的稳健性,而非证明不存在混淆;常见的敏感性分析包括 E 值、Rosenbaum 边界法与 Cinelli-Hazlett 的 omitted-variable bias 框架。这些方法共同的前提是:未测混淆的强度不可由数据直接观测,只能通过假设进行界定。4242Sensitivity Analysis in Observational Research: Introducing the E-Valuedoi.org前往参考资料 ↓在新标签页中打开|4646Making Sense of Sensitivity: Extending Omitted Variable Biasdoi.org前往参考资料 ↓在新标签页中打开
领域知识与文献回顾
识别混淆变量的第一步通常不是跑数据,而是做领域知识与文献回顾:研究者需要先依据既有理论、先前实证研究和关于数据生成过程的背景知识,列出可能同时影响处理(暴露)与结果的第三变量清单,再决定哪些需要调整、哪些可以忽略。这一「先验清单」思路在流行病学与社会科学因果推断教材中被作为标准起点。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
在因果图(DAG)框架下,领域知识的作用被形式化为「后门准则」:只要依据背景知识画出变量间的有向无环图,就能机械地判定哪些变量集合足以阻断所有后门路径。Pearl 指出,DAG 的箭头方向与缺失边必须来自领域知识或假设,而不能由数据本身唯一确定——同一组观测数据可以被多个不同 DAG 拟合。1010Causal Inference in Statistics: A Primerwiley.com前往参考资料 ↓在新标签页中打开
文献回顾的一个核心用途是避免「调整中介变量」和「调整对撞变量」这两类错误。依据既有研究厘清变量在因果链上的位置(处理的前因、后果,还是共同后果),才能判断该变量属于混淆变量、中介变量还是对撞变量;仅凭统计相关无法区分这三者。4747The Table 2 Fallacy: Presenting and Interpreting Confounder and Modifier Coefficientsacademic.oup.com前往参考资料 ↓在新标签页中打开
系统综述与元分析被用作识别混淆变量的证据来源:通过汇总同一处理—结果关系在不同人群、不同设计下的估计值,研究者可以推断哪些协变量导致了估计的异质性,从而把「估计值随协变量分布变化而漂移」作为存在混淆的间接线索。4848Meta-analysis in clinical trialssciencedirect.com前往参考资料 ↓在新标签页中打开
领域知识清单法的主要局限在于它依赖研究者的先验信念,无法保证清单完备:未被想到、未被文献记录的混淆变量不会被纳入调整集,而遗漏一个强混淆变量就足以使估计严重偏离。因此文献回顾只能提供「候选集」,不能提供「完备性保证」。4949Sensitivity Analysis in Observational Research: Introducing the E-Valueacpjournals.org前往参考资料 ↓在新标签页中打开
对于领域知识无法确定箭头方向的情形,研究者之间存在方法论分歧:一派主张用专家 elicitation 与敏感性分析量化「未知混淆需多强才能推翻结论」,另一派主张借助负对照(negative control)与工具变量等设计在数据层面探测未测混淆。两种路线在实践中的优先级仍有争论。4949Sensitivity Analysis in Observational Research: Introducing the E-Valueacpjournals.org前往参考资料 ↓在新标签页中打开|5050Negative Controls: A Tool for Detecting Confounding and Bias in Observational Studiesjournals.lww.com前往参考资料 ↓在新标签页中打开
对立说法部分学者认为,在观测数据中应优先采用负对照结果变量/暴露等设计性诊断,因为专家先验难以校准且不可复现。5050Negative Controls: A Tool for Detecting Confounding and Bias in Observational Studiesjournals.lww.com前往参考资料 ↓在新标签页中打开
对立说法另一部分学者认为,设计性诊断只能提示「存在未控混淆」,无法给出调整集,因此仍须以领域知识构建 DAG 为主导。53
实验设计层面的控制
随机化
随机化是实验设计层面控制混淆变量的核心手段:通过随机分配处理(treatment),使潜在混淆变量在期望意义上与处理独立,从而切断「混淆变量→处理」这条后门路径。其思想可追溯到 R. A. Fisher 在 20 世纪 20—30 年代建立的实验设计理论,他在《The Design of Experiments》(1935)中系统阐述了随机化、重复与区组三大原则。5151The Design of Experimentsarchive.org前往参考资料 ↓在新标签页中打开
随机化的关键性质是:它并不保证某一具体样本中混淆变量在处理组与对照组间完全平衡,而是保证在重复抽样意义下、以及在大样本极限下平衡。因此随机化消除的是系统性偏倚(bias),而非单次实验中的随机不平衡;后者可通过增大样本量或采用区组随机化、分层随机化来缓解。5151The Design of Experimentsarchive.org前往参考资料 ↓在新标签页中打开|5252Estimating causal effects of treatments in randomized and nonrandomized studiesdoi.org前往参考资料 ↓在新标签页中打开
在潜在结果框架(Rubin 因果模型)下,随机化保证了处理分配与潜在结果 (Y(0), Y(1)) 独立,即 (Y(0), Y(1)) ⫫ T,这是识别平均处理效应(ATE)的充分条件;它使简单的组间均值差成为 ATE 的无偏估计。这一形式化表述由 Rubin(1974)给出,并与 Fisher 的随机化检验传统相衔接。5252Estimating causal effects of treatments in randomized and nonrandomized studiesdoi.org前往参考资料 ↓在新标签页中打开|5353Statistics and Causal Inferencedoi.org前往参考资料 ↓在新标签页中打开
随机化只控制「已知与未知」混淆变量中那些在处理分配之前就已存在、且不受处理影响的变量;它无法防止处理后混淆(post-treatment confounding),即由处理本身引起、又影响结果的中介或对撞结构。因此随机化实验估计的是处理对结果的「总效应」,而非直接效应。4444Causality: Models, Reasoning, and Inference (2nd ed.)doi.org前往参考资料 ↓在新标签页中打开
完全随机化在样本量有限时可能造成协变量不平衡,分层随机化(stratified randomization)与区组随机化(block randomization)通过在已知强预后因素的分层内分别随机,能提高平衡性与统计效率;这是临床试验与田野实验中的常规做法。5151The Design of Experimentsarchive.org前往参考资料 ↓在新标签页中打开|5454Randomization in Clinical Trials: Theory and Practicedoi.org前往参考资料 ↓在新标签页中打开
随机化并非在所有场景都可行或合乎伦理:当处理不可操纵(如吸烟、性别、气候暴露)或随机分配会造成严重伤害时,研究者只能依赖观察性设计与 倾向得分匹配 等方法,此时混淆控制退化为「在可观测变量条件下」的假设,其可信度取决于无未测混淆假设。4444Causality: Models, Reasoning, and Inference (2nd ed.)doi.org前往参考资料 ↓在新标签页中打开|33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
随机化实验的外部效度(可推广性)并不自动成立:随机样本与随机分配是两个不同概念,随机化处理分配只保证内部效度,若实验人群、情境与目标人群差异较大,估计出的效应未必可外推。这是随机化控制混淆时经常被忽视的边界。5454Randomization in Clinical Trials: Theory and Practicedoi.org前往参考资料 ↓在新标签页中打开|33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
关于随机化在因果推断中的地位存在持续争论:一方(如 Pearl 学派)认为随机化只是切断后门路径的一种工具,观察性研究在满足后门准则与可忽略性时同样能识别因果效应;另一方(如 Rubin 传统与实验主义者)强调随机化是唯一不依赖强假设的识别策略。这一分歧影响研究者对「随机化是否必要」的判断。4444Causality: Models, Reasoning, and Inference (2nd ed.)doi.org前往参考资料 ↓在新标签页中打开|33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
对立说法Pearl 及其合作者主张,因果图与 do-演算提供了不依赖随机化的识别条件,随机化只是众多识别策略之一,观察性数据在满足后门准则时同样可识别因果效应。4444Causality: Models, Reasoning, and Inference (2nd ed.)doi.org前往参考资料 ↓在新标签页中打开
对立说法实验主义者与部分流行病学家则强调,观察性研究的无未测混淆假设不可检验,随机化是唯一能保证无偏性的设计,因而在可行时应优先采用。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
控制变量法
控制变量法(control variable method)是实验设计层面控制混淆的最基本手段:在比较某一处理(自变量)对结果(因变量)的影响时,把已知或怀疑会影响结果的其他因素(即潜在混淆变量)人为固定在相同水平上,使各组之间除处理外尽可能一致,从而切断这些变量与处理之间的关联路径。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
在随机化实验(randomized experiment)中,控制变量法与随机分配是互补而非替代关系:随机分配在期望意义上平衡处理组与对照组中所有变量(包括未观测变量),而控制变量法通过设计固定或限制某些变量的取值,进一步降低残余方差、提高统计功效,并在小样本下减少偶然不平衡。5151The Design of Experimentsarchive.org前往参考资料 ↓在新标签页中打开
控制变量法在观察性研究中同样被广泛使用,但其效力受限于「只能控制已被测量且被正确设定的变量」这一前提:未测量的混淆变量无法通过设计固定,因此观察性研究中的控制变量法不能替代随机化,只能缩小而非消除混淆偏倚。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|5555Causality: Models, Reasoning, and Inference (2nd ed.)cambridge.org前往参考资料 ↓在新标签页中打开
在实验设计中,控制变量法常通过区组设计(blocking)实现:把实验单元按已知的混淆因素(如批次、性别、地点)划分为同质区组,再在区组内随机分配处理,使该因素在组间保持平衡,这是农业试验与临床试验中控制已知干扰因素的经典做法。5151The Design of Experimentsarchive.org前往参考资料 ↓在新标签页中打开|5656Randomization and allocation concealment in clinical trialsbmj.com前往参考资料 ↓在新标签页中打开
控制变量法存在「过度控制(overcontrol)」风险:若把处理的下游后果(即中介变量,mediator)或对撞变量(collider)当作控制变量固定,反而会引入新的偏倚,甚至制造出原本不存在的虚假关联;因此选择控制哪些变量必须依据因果图(DAG)而非「控制得越多越好」的直觉。5555Causality: Models, Reasoning, and Inference (2nd ed.)cambridge.org前往参考资料 ↓在新标签页中打开|5757A Crash Course in Causality: Inferring Causal Effects from Observational Datacoursera.org前往参考资料 ↓在新标签页中打开
控制变量法在实验设计层面与统计控制(如回归调整、分层分析、倾向得分匹配)的区别在于:前者在数据产生之前通过设计固定变量取值,后者在数据产生之后通过模型调整;设计层面的控制通常更稳健,因为它不依赖模型设定正确。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
在随机对照试验(RCT)中,控制变量法常用于减少「偶然不平衡」(chance imbalance):当样本量较小时,即使随机分配也可能在重要预后因素上出现组间差异,此时通过分层随机化或最小化法(minimization)固定或平衡这些因素,可提高试验的精确度与可信度。5151The Design of Experimentsarchive.org前往参考资料 ↓在新标签页中打开|5656Randomization and allocation concealment in clinical trialsbmj.com前往参考资料 ↓在新标签页中打开
控制变量法并非万能:它只能处理已知且可测量的混淆变量,对未知混淆变量无能为力;此外,在无法人为操纵自变量的观察性场景(如吸烟、职业暴露)中,设计层面的控制往往不可行,只能退而求其次采用统计控制。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|5555Causality: Models, Reasoning, and Inference (2nd ed.)cambridge.org前往参考资料 ↓在新标签页中打开
关于控制变量法在因果推断中的地位,研究界存在分歧:以 Pearl 为代表的因果图学派强调,控制变量的选择应严格依据后门准则(back-door criterion),盲目控制所有可测变量可能引入对撞偏倚;而以传统实验设计为代表的学派则更强调通过区组与固定因素来降低方差、提高效率,两者在「控制什么」与「为何控制」上侧重点不同。5555Causality: Models, Reasoning, and Inference (2nd ed.)cambridge.org前往参考资料 ↓在新标签页中打开|5757A Crash Course in Causality: Inferring Causal Effects from Observational Datacoursera.org前往参考资料 ↓在新标签页中打开
对立说法传统实验设计学派认为,只要控制变量与结果相关且不与处理共线,控制得越多越能降低误差方差,从而更精确地估计处理效应;因果图学派则指出,控制对撞变量或中介变量会引入偏倚,控制变量的选择必须服从因果结构而非统计效率。5555Causality: Models, Reasoning, and Inference (2nd ed.)cambridge.org前往参考资料 ↓在新标签页中打开|5757A Crash Course in Causality: Inferring Causal Effects from Observational Datacoursera.org前往参考资料 ↓在新标签页中打开
分组实验与区组设计
随机分组(randomization)是实验设计层面控制混淆变量的核心手段:把研究对象随机分配到处理组与对照组,使所有潜在混淆变量(无论是否被观测到)在期望意义上于两组间分布均衡,从而切断混淆变量与处理分配之间的关联。Fisher 在 1925 年《Statistical Methods for Research Workers》与 1935 年《The Design of Experiments》中系统确立了这一原则,随机化由此成为因果推断中「可忽略性」(ignorability)的物理实现方式。5151The Design of Experimentsarchive.org前往参考资料 ↓在新标签页中打开|5858Statistical Methods for Research Workersarchive.org前往参考资料 ↓在新标签页中打开
随机化只在期望意义上均衡混淆变量,单次实验中仍可能出现不平衡,尤其是样本量小或混淆变量多时。因此现代实验设计强调在随机化前先固定随机种子、预先登记分配方案,并在分析阶段报告基线协变量的组间比较(如标准化均值差),而不是依赖「随机了就没事」的直觉。5959CONSORT 2010 Statement: updated guidelines for reporting parallel group randomised trialsbmj.com前往参考资料 ↓在新标签页中打开|6060The ASA Statement on p-Values: Context, Process, and Purposetandfonline.com前往参考资料 ↓在新标签页中打开
区组设计(block design)是在随机化之前先把实验单元按已知的、与结果强相关的 nuisance 变量(如性别、年龄层、田块肥力、实验批次)分成若干同质区组,再在每个区组内部独立随机分配处理。这样把区组间差异从误差项中剥离,既提高了检验效能,也防止这些已知变量成为残余混淆。Fisher 的随机区组设计(randomized block design)是这一思路的原型。5151The Design of Experimentsarchive.org前往参考资料 ↓在新标签页中打开|5858Statistical Methods for Research Workersarchive.org前往参考资料 ↓在新标签页中打开
配对设计(matched pairs)是区组设计的极端情形:每个区组只含两个同质单元,一个接受处理、一个接受对照,处理在配对内部随机决定。它在临床与心理学实验中广泛使用,代价是当配对变量选择不当或配对失败时,会引入新的选择偏倚,因此配对变量必须依据先验知识而非事后数据挑选。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|6161Design and Analysis of Group-Randomized Trialsglobal.oup.com前往参考资料 ↓在新标签页中打开
析因设计(factorial design)通过同时操纵多个因素并考察其交互作用,把「其他因素」从混淆源转化为被显式建模的因子。2^k 析因与部分析因设计使研究者能在有限样本下估计主效应与交互效应,避免一次只变一个因素的「单因素法」把未操纵因素悄悄混入处理效应。5858Statistical Methods for Research Workersarchive.org前往参考资料 ↓在新标签页中打开|6262Statistics for Experimenters: Design, Innovation, and Discovery (2nd ed.)wiley.com前往参考资料 ↓在新标签页中打开
在无法随机化的观察性研究中,区组思想以「分层」(stratification)与「匹配」(matching)的形式延续:按已知混淆变量分层后在层内比较,或为每个处理单元匹配特征相近的对照单元。这类设计只能控制已被测量并纳入分层/匹配的变量,对未观测混淆无能为力,这是它与随机化的根本差别。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|1010Causal Inference in Statistics: A Primerwiley.com前往参考资料 ↓在新标签页中打开
关于区组设计是否应优先于纯随机化,研究界存在分歧:支持者强调区组能显著提高效能并消除已知混淆;批评者(如部分临床试验方法学者)指出,若区组变量与处理存在交互、或区组划分本身依据不牢,区组反而可能损害外部效度并增加分析复杂度,因此主张在确知区组变量与结果关系时才使用。6161Design and Analysis of Group-Randomized Trialsglobal.oup.com前往参考资料 ↓在新标签页中打开|6363Randomization in Clinical Trials: Theory and Practice (2nd ed.)wiley.com前往参考资料 ↓在新标签页中打开
对立说法区组设计在已知强预后变量存在时应作为默认选择,其效能收益远大于分析复杂度的代价。5151The Design of Experimentsarchive.org前往参考资料 ↓在新标签页中打开|5858Statistical Methods for Research Workersarchive.org前往参考资料 ↓在新标签页中打开
分组实验的效力依赖于「随机化成功」这一前提,但随机化本身不能防止实施层面的混淆:若分配方案未对实施者隐藏(分配隐藏不足),或存在选择性入组、依从性差异与失访差异,处理组与对照组仍会在实际接受的处理上产生系统差异,形成新的偏倚。CONSORT 声明因此要求报告随机序列产生、分配隐藏与盲法实施细节。5959CONSORT 2010 Statement: updated guidelines for reporting parallel group randomised trialsbmj.com前往参考资料 ↓在新标签页中打开|6464Empirical evidence of bias: dimensions of methodological quality associated with estimates of treatment effects in controlled trialsjamanetwork.com前往参考资料 ↓在新标签页中打开
在因果图(DAG)框架下,随机化处理等价于删除所有指向处理节点的箭头,从而阻断所有后门路径;区组设计则相当于在图中对区组变量条件化,以消除经由该变量的路径。这一形式化说明把「设计层面的控制」与「分析层面的校正」统一到同一套识别逻辑中,也解释了为何设计控制通常优于事后校正——后者依赖模型正确设定。1010Causal Inference in Statistics: A Primerwiley.com前往参考资料 ↓在新标签页中打开|6565Causality: Models, Reasoning, and Inference (2nd ed.)cambridge.org前往参考资料 ↓在新标签页中打开
盲法
盲法(blinding)是实验设计层面控制混淆的常用手段:通过让受试者、实施者或评估者不知道分组归属,切断「知晓处理分配」这一变量与处理、结局之间的关联,从而避免它成为混淆变量或引入信息偏倚。在随机对照试验的方法学规范中,盲法被列为与随机化、分配隐藏并列的偏倚控制要素。6666Cochrane Handbook for Systematic Reviews of Interventions, Chapter 8: Assessing risk of bias in a randomized trialtraining.cochrane.org前往参考资料 ↓在新标签页中打开|5959CONSORT 2010 Statement: updated guidelines for reporting parallel group randomised trialsbmj.com前往参考资料 ↓在新标签页中打开
Cochrane 协作网的方法学手册把盲法(其术语体系中称「masking」)单列为一章,区分了受试者盲、实施者盲、结局评估者盲与数据分析者盲等不同层级,并指出盲法的核心目的是防止因知晓干预分配而产生的实施偏倚、检测偏倚与损耗偏倚。6666Cochrane Handbook for Systematic Reviews of Interventions, Chapter 8: Assessing risk of bias in a randomized trialtraining.cochrane.org前往参考资料 ↓在新标签页中打开
在 CONSORT 2010 声明中,盲法(blinding)是必须报告的条目之一:作者需说明对谁设盲(受试者、医护人员、结局评估者等)、如何实现盲法,以及在无法设盲时说明理由。这说明盲法在报告规范层面被视为影响内部真实性的关键设计信息。5959CONSORT 2010 Statement: updated guidelines for reporting parallel group randomised trialsbmj.com前往参考资料 ↓在新标签页中打开
盲法之所以能控制混淆,前提是它与随机化和分配隐藏配合使用:随机化使已知与未知混淆变量在组间期望均衡,分配隐藏防止选择偏倚,而盲法则防止分配之后因知晓分组而产生的行为差异与测量差异重新引入非随机性。单独使用盲法不能替代随机化。6666Cochrane Handbook for Systematic Reviews of Interventions, Chapter 8: Assessing risk of bias in a randomized trialtraining.cochrane.org前往参考资料 ↓在新标签页中打开|5959CONSORT 2010 Statement: updated guidelines for reporting parallel group randomised trialsbmj.com前往参考资料 ↓在新标签页中打开
盲法并非在所有情形下都可行或合乎伦理。例如在比较手术与药物治疗、行为干预、物理治疗等无法对实施者和受试者设盲的试验中,通常只能对结局评估者与数据分析者设盲;Cochrane 手册与 CONSORT 均要求在这种情况下明确说明未设盲的对象及其可能带来的偏倚方向。6666Cochrane Handbook for Systematic Reviews of Interventions, Chapter 8: Assessing risk of bias in a randomized trialtraining.cochrane.org前往参考资料 ↓在新标签页中打开|5959CONSORT 2010 Statement: updated guidelines for reporting parallel group randomised trialsbmj.com前往参考资料 ↓在新标签页中打开
关于盲法对效应估计的实际影响大小,研究界并无一致结论。部分系统综述与元流行病学研究发现,未设盲(尤其是结局评估者未设盲)与更大的效应估计相关,但效应幅度随结局类型(主观结局 vs 客观结局)差异很大;也有分析认为在客观硬终点(如全因死亡)上盲法的影响有限。6767Blinding in randomised trials: hiding who got whatthelancet.com前往参考资料 ↓在新标签页中打开|6868Empirical evidence of bias: dimensions of methodological quality associated with estimates of treatment effects in controlled trialsjamanetwork.com前往参考资料 ↓在新标签页中打开
对立说法有元流行病学分析认为,在客观结局(如死亡)上,缺乏盲法与效应估计偏大之间的关联并不稳健,甚至不显著;盲法的重要性主要体现在主观结局与评估者判断类结局上。6868Empirical evidence of bias: dimensions of methodological quality associated with estimates of treatment effects in controlled trialsjamanetwork.com前往参考资料 ↓在新标签页中打开
在观察性研究中,盲法的作用形式不同:由于不存在人为分配处理,盲法主要用于减少结局测量与判定的信息偏倚(如盲法判定结局、盲法提取病历信息),而不能像在随机试验中那样控制处理分配环节的混淆。因此观察性研究中的盲法通常被归入测量层面的偏倚控制,而非混淆控制。6666Cochrane Handbook for Systematic Reviews of Interventions, Chapter 8: Assessing risk of bias in a randomized trialtraining.cochrane.org前往参考资料 ↓在新标签页中打开|6969ROBINS-I: a tool for assessing risk of bias in non-randomised studies of interventionsbmj.com前往参考资料 ↓在新标签页中打开
盲法的实施需要配套机制,例如外观与气味一致的安慰剂、中心化的随机化与药物编码、独立于研究团队的结局评估者、以及揭盲时点的预先规定。若盲法被意外破坏(揭盲),需要在分析中报告并评估其对结果的可能影响。6666Cochrane Handbook for Systematic Reviews of Interventions, Chapter 8: Assessing risk of bias in a randomized trialtraining.cochrane.org前往参考资料 ↓在新标签页中打开|5959CONSORT 2010 Statement: updated guidelines for reporting parallel group randomised trialsbmj.com前往参考资料 ↓在新标签页中打开
统计分析与事后校正
分层分析
分层分析(stratified analysis)是控制混淆变量的基本统计手段:按混淆变量的取值把样本切成若干同质层(strata),在每一层内部比较暴露与结局的关联,再按各层样本量或方差的倒数加权合并,得到调整后的效应估计。其逻辑前提是:同一层内混淆变量的取值相同或近似,因此层内比较不再受该变量干扰。7070Modern Epidemiology, 3rd Edition — Chapter 12: Confounding and Confoundersncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开|33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
Mantel–Haenszel 估计量是分层分析最常用的合并方法,由 Mantel 与 Haenszel 于 1959 年提出,用于在多个 2×2 层表中合并优势比或风险比;它按各层信息量加权,在稀疏数据下比直接取各层估计的简单平均更稳健。7171Statistical aspects of the analysis of data from retrospective studies of diseaseacademic.oup.com前往参考资料 ↓在新标签页中打开|7070Modern Epidemiology, 3rd Edition — Chapter 12: Confounding and Confoundersncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
分层分析的核心操作是「比较粗效应与调整后效应」:若分层调整后的效应估计与未分层的粗估计出现实质差异,通常提示存在混淆;差异的方向与幅度可用来判断混淆的方向(高估、低估或符号反转)。这一「粗 vs. 调整」的对比是流行病学中识别混淆的经典启发式。7070Modern Epidemiology, 3rd Edition — Chapter 12: Confounding and Confoundersncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开|7272Confounding in epidemiological studies: a review of the concept and its controlncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
分层分析对连续型混淆变量并不友好:若把连续变量按分位数切成 4–5 层,层内残余混淆仍然存在(residual confounding),且切点选择带有任意性;切得过细则每层样本稀疏、估计不稳定。因此实践中连续混淆变量更常用回归模型或倾向评分处理,分层只作为辅助或稳健性检验。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|1818The central role of the propensity score in observational studies for causal effectsacademic.oup.com前往参考资料 ↓在新标签页中打开
分层分析能同时调整的变量数目受样本量严格限制:每增加一个分层变量,层数按乘积增长(如 3 个各 5 类的变量产生 125 层),很快出现空层或每层仅数个观测的稀疏问题,导致合并估计失效。这一「维数灾难」正是倾向评分与回归调整被引入的直接动因。1818The central role of the propensity score in observational studies for causal effectsacademic.oup.com前往参考资料 ↓在新标签页中打开|7373Stratification and adjustment in epidemiologic analysisncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
在因果推断的标准化框架下,分层分析可被理解为对混淆变量分布做直接标准化(direct standardization):层内效应按目标人群的层分布加权平均,即 g-formula 的离散版本。因此分层与标准化在数学上同源,区别只在呈现方式。7474A definition of causal effect for epidemiological researchncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开|33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
分层分析只能控制已测量且被正确分层的混淆变量,对未测量混淆完全无能为力;它也不解决「按结局后变量或中介变量分层」带来的碰撞偏倚(collider bias)与过度调整问题——若分层变量位于暴露与结局的因果通路上,分层反而会引入新的偏倚。7272Confounding in epidemiological studies: a review of the concept and its controlncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开|7575Quantifying biases in causal models: classical confounding vs collider-stratification biasjournals.lww.com前往参考资料 ↓在新标签页中打开
关于分层分析与回归调整孰优孰劣,研究界并无定论:支持者认为分层不依赖函数形式假设、透明度高、便于检查层内异质性;批评者指出其在多混淆变量与连续变量场景下效率低、易产生稀疏数据偏倚,且难以处理时间依赖混淆。多数教科书建议两者并用、互为验证,而非择一。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|1818The central role of the propensity score in observational studies for causal effectsacademic.oup.com前往参考资料 ↓在新标签页中打开|7373Stratification and adjustment in epidemiologic analysisncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对立说法部分方法学文献主张:在样本量允许且混淆变量为分类变量时,分层分析因不依赖模型设定而比回归更不易产生模型误设偏倚,应作为首选而非辅助。7373Stratification and adjustment in epidemiologic analysisncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对立说法另一派则认为回归/倾向评分在控制多个混淆变量时方差更小、可扩展性更强,分层只应作为敏感性分析。1818The central role of the propensity score in observational studies for causal effectsacademic.oup.com前往参考资料 ↓在新标签页中打开
分层分析的结果对分层变量的测量误差高度敏感:若混淆变量被错误分类,层内残余混淆不会被消除,反而可能因「调整了不完美的代理变量」而给出虚假的安全感;非差异性错分通常使调整后的效应向无效值偏移,但方向并非总是可预测。7070Modern Epidemiology, 3rd Edition — Chapter 12: Confounding and Confoundersncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开|7575Quantifying biases in causal models: classical confounding vs collider-stratification biasjournals.lww.com前往参考资料 ↓在新标签页中打开
多元回归调整
多元回归调整是观察性研究中控制混淆变量的最常用统计手段:把处理变量与一组测得的协变量同时放入回归方程,以协变量取值不变为前提估计处理变量与结果变量的偏效应,从而在模型设定正确的条件下剥离可观测混淆。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|1212Mostly Harmless Econometrics: An Empiricist's Companionpress.princeton.edu前往参考资料 ↓在新标签页中打开
回归调整只能控制已测量并正确纳入模型的混淆变量;对未测量混淆、测量误差以及模型形式误设(如把非线性关系强行线性化、遗漏交互项)没有一般性的保护,因此“调整了协变量”不等于“识别了因果效应”。1212Mostly Harmless Econometrics: An Empiricist's Companionpress.princeton.edu前往参考资料 ↓在新标签页中打开|7676Causal Diagrams for Empirical Researchacademic.oup.com前往参考资料 ↓在新标签页中打开
在因果图框架下,回归中应当调整的是处理与结果之间的共同原因(后门路径上的节点),而不应调整处理的下游变量(中介变量)或结果的下游变量;把中介变量放进回归会阻断部分真实效应,把对撞变量或其下游变量放进回归则会引入新的选择性偏倚。7676Causal Diagrams for Empirical Researchacademic.oup.com前往参考资料 ↓在新标签页中打开|7777Causal Inference: The Mixtapemixtape.scunning.com前往参考资料 ↓在新标签页中打开
“表观悖论”(Simpson 悖论)说明,粗分析中观察到的关联方向可能在调整混淆变量后反转;这既是回归调整必要性的经典论据,也提醒研究者:调整变量的集合不同,得到的效应估计可能不同,效应估计对调整集的选择是敏感的。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|3232Simpson's Paradoxplato.stanford.edu前往参考资料 ↓在新标签页中打开
在回归中纳入与处理或结果相关的变量会改变估计量的方差与解释:纳入强预测结果的协变量通常能提高估计精度,而纳入与处理高度相关、与结果关系微弱的变量会放大处理效应估计的标准误;因此协变量选择同时是偏倚与效率的权衡问题。1212Mostly Harmless Econometrics: An Empiricist's Companionpress.princeton.edu前往参考资料 ↓在新标签页中打开|1818The central role of the propensity score in observational studies for causal effectsacademic.oup.com前往参考资料 ↓在新标签页中打开
倾向评分方法(匹配、分层、加权、协变量调整)与多元回归调整在识别假设上等价:两者都依赖“无未测量混淆”和“可忽略性”,在协变量集合相同且模型正确时,大样本下目标估计量一致;差别主要在于对重叠性(共同支撑)的诊断能力和对模型误设的稳健性。1818The central role of the propensity score in observational studies for causal effectsacademic.oup.com前往参考资料 ↓在新标签页中打开
关于“该调整哪些协变量”存在方法学争论:一类观点主张按因果图选出的最小充分调整集,以避免过度调整偏倚;另一类观点主张纳入所有结果预测变量以提高精度,即使它们不是混淆变量。两种策略在有限样本与模型误设下表现不同,学界并未形成统一规范。7676Causal Diagrams for Empirical Researchacademic.oup.com前往参考资料 ↓在新标签页中打开|7878A Crash Course in Good and Bad Controlsjournals.sagepub.com前往参考资料 ↓在新标签页中打开
对立说法支持“按图选最小充分调整集”的一方认为,纳入处理的下游变量或对撞变量会引入偏倚,精度收益不足以抵消偏倚风险。7676Causal Diagrams for Empirical Researchacademic.oup.com前往参考资料 ↓在新标签页中打开
对立说法支持“纳入所有结果预测变量”的一方认为,在无未测量混淆的理想条件下,纳入纯预测变量可降低方差且不引入偏倚,实践中更稳健。7878A Crash Course in Good and Bad Controlsjournals.sagepub.com前往参考资料 ↓在新标签页中打开
事后校正的另一条路径是敏感性分析:在回归结果之外,量化“需要多强的未测量混淆才能推翻现有结论”(如 E 值、Cinelli-Hazlett 的遗漏变量偏倚界),把“是否稳健”从定性判断变成可报告的数量。4949Sensitivity Analysis in Observational Research: Introducing the E-Valueacpjournals.org前往参考资料 ↓在新标签页中打开|7979Making Sense of Sensitivity: Extending Omitted Variable Biasacademic.oup.com前往参考资料 ↓在新标签页中打开
倾向评分匹配
倾向评分(propensity score)被定义为在给定可观测协变量集合 X 的条件下,个体接受处理(T=1)的条件概率,即 e(X)=P(T=1|X)。Rosenbaum 与 Rubin 在 1983 年证明:若处理分配在给定 X 下可忽略(无未观测混淆),则只需在倾向评分 e(X) 这一维标量上进行条件调整,就足以消除全部可观测混淆,这被称为「倾向评分的平衡性质」(balancing property)。3939The Central Role of the Propensity Score in Observational Studies for Causal Effectsdoi.org前往参考资料 ↓在新标签页中打开
倾向评分匹配(propensity score matching, PSM)的基本操作是:先用模型(通常为 logistic 回归,也可用机器学习方法)估计每个个体的倾向评分,再按评分把处理组与对照组的个体配对或加权,使两组在协变量分布上趋于平衡,最后在匹配后的样本上估计处理效应。常用的匹配算法包括最近邻匹配、卡钳(caliper)匹配、半径匹配、分层匹配与核匹配。3939The Central Role of the Propensity Score in Observational Studies for Causal Effectsdoi.org前往参考资料 ↓在新标签页中打开|4040An Introduction to Propensity Score Methods for Reducing the Effects of Confounding in Observational Studiesdoi.org前往参考资料 ↓在新标签页中打开
PSM 只能平衡研究者已经观测并纳入模型的协变量;如果存在未观测混淆变量(unmeasured confounder),匹配后的处理效应估计仍然有偏。这是 PSM 与所有基于可观测变量调整的方法共同的根本局限,也是它在因果推断中不能替代随机化的原因。3939The Central Role of the Propensity Score in Observational Studies for Causal Effectsdoi.org前往参考资料 ↓在新标签页中打开|33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
Austin(2011)系统梳理了 PSM 在观察性研究中的报告规范,指出匹配后必须报告标准化差异(standardized difference)而非仅报告 p 值来评估协变量平衡,并建议标准化差异小于 0.1 视为可接受的平衡。该文已成为医学与流行病学领域 PSM 应用最常被引用的方法学指南之一。4040An Introduction to Propensity Score Methods for Reducing the Effects of Confounding in Observational Studiesdoi.org前往参考资料 ↓在新标签页中打开
King 与 Nielsen(2019)提出「为什么倾向评分不应被用于匹配」的批评:他们论证在多数实际情形下,直接对协变量做马氏距离匹配(Mahalanobis distance matching)或粗化精确匹配(coarsened exact matching)比 PSM 更能降低不平衡与模型依赖,PSM 的「降维」优势在实践中被高估,且容易因倾向评分模型设定错误而引入新的偏倚。8181Why Propensity Scores Should Not Be Used for Matchingdoi.org前往参考资料 ↓在新标签页中打开
对立说法Rosenbaum 与 Rubin 的原始理论及大量应用文献认为,倾向评分在高维协变量场景下提供了可行的降维调整手段,且在正确设定评分模型时具有一致性;PSM 在流行病学与经济学中的广泛成功应用被视为其有效性的经验支持。3939The Central Role of the Propensity Score in Observational Studies for Causal Effectsdoi.org前往参考资料 ↓在新标签页中打开|4040An Introduction to Propensity Score Methods for Reducing the Effects of Confounding in Observational Studiesdoi.org前往参考资料 ↓在新标签页中打开
PSM 的估计结果对倾向评分模型的函数形式(如是否包含交互项、高阶项)敏感;模型设定不当会导致部分协变量在匹配后仍不平衡,从而残留混淆。因此匹配后必须做平衡诊断,并在必要时重新设定评分模型(如加入交互项或使用更灵活的算法)。4040An Introduction to Propensity Score Methods for Reducing the Effects of Confounding in Observational Studiesdoi.org前往参考资料 ↓在新标签页中打开|8181Why Propensity Scores Should Not Be Used for Matchingdoi.org前往参考资料 ↓在新标签页中打开
在因果推断的潜在结果框架下,PSM 估计的是可观测协变量条件下的平均处理效应(ATE)或处理组平均处理效应(ATT);当研究关注 ATT 时,通常采用处理组个体与对照组个体的匹配,而 ATT 与 ATE 在存在异质性处理效应时并不相等,报告时必须明确所估计的效应类型。3939The Central Role of the Propensity Score in Observational Studies for Causal Effectsdoi.org前往参考资料 ↓在新标签页中打开|33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
PSM 常与双重稳健方法结合使用:先做倾向评分匹配或加权,再在匹配样本上对结果变量做回归调整(即「匹配+回归」或「双重稳健估计」),只要倾向评分模型或结果模型之一设定正确,估计即一致。这一组合被视为对单一模型设定错误的稳健化策略。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
倾向评分加权(inverse probability of treatment weighting, IPTW)是 PSM 的姊妹方法:它不进行个体配对,而是以 1/e(X) 或 e(X)/(1-e(X)) 为权重构造伪总体,从而估计 ATE。与匹配相比,IPTW 保留了全部样本,但对极端倾向评分(接近 0 或 1)敏感,常需做权重截断(trimming)或稳定化处理。4040An Introduction to Propensity Score Methods for Reducing the Effects of Confounding in Observational Studiesdoi.org前往参考资料 ↓在新标签页中打开|33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
工具变量与断点回归
工具变量(instrumental variable, IV)方法的核心是寻找一个与处理变量(暴露)相关、但除经由处理变量外不直接影响结果、也不与未观测混淆因素相关的变量,从而在存在未观测混淆时仍能识别因果效应。其有效性依赖三个不可直接检验的假设:相关性(relevance)、外生性/排他性限制(exclusion restriction)与独立性(exchangeability)。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
在观察性研究中,工具变量常被用于处理未测量混淆:例如以与就医距离相关的「到最近医院的距离」作为实际就医行为的工具变量,以评估医疗利用对健康结局的影响;此类设计的前提是距离只通过就医行为影响健康,而不通过其他路径(如地区经济水平)影响结局。8282Instrumental variable methods in comparative safety and effectiveness researchonlinelibrary.wiley.com前往参考资料 ↓在新标签页中打开
断点回归(regression discontinuity design, RDD)利用一个连续评分变量上的明确截断规则(如考试分数线、政策年龄门槛)来识别因果效应:在截断点附近,处理分配近似随机,因此截断点两侧的个体在可观测与不可观测特征上应大致可比,从而把「刚好跨过阈值」视为近似实验。8383Regression Discontinuity Designs in Economicsaeaweb.org前往参考资料 ↓在新标签页中打开|8484Regression Discontinuity Designs: A Guide to Practicesciencedirect.com前往参考资料 ↓在新标签页中打开
RDD 的识别依赖「局部随机化」假设:个体不能精确操纵评分变量以选择是否接受处理。若存在操纵(如考生通过关系修改分数),断点附近的比较将失效;McCrary 密度检验与协变量连续性检验是常用的诊断手段。8383Regression Discontinuity Designs in Economicsaeaweb.org前往参考资料 ↓在新标签页中打开|8585Manipulation of the Running Variable in the Regression Discontinuity Design: A Density Testsciencedirect.com前往参考资料 ↓在新标签页中打开
工具变量与断点回归都属于「设计导向」(design-based)的因果识别策略,与倾向得分匹配、回归调整等「模型导向」方法不同:它们不要求观测并控制全部混淆变量,而是借助外部变异(工具或阈值)来绕开未观测混淆。这一区分在 因果推断 框架中被反复强调。1212Mostly Harmless Econometrics: An Empiricist's Companionpress.princeton.edu前往参考资料 ↓在新标签页中打开
工具变量估计量(如两阶段最小二乘 2SLS)在弱工具(工具与处理变量相关性很弱)情形下会产生严重偏倚与不可靠的置信区间;Stock–Yogo 临界值与第一阶段 F 统计量是判断弱工具的常用诊断,一般建议 F 值明显高于 10 的经验门槛。8686Testing for Weak Instruments in Linear IV Regressionnber.org前往参考资料 ↓在新标签页中打开|8787A Survey of Weak Instruments and Weak Identification in Generalized Method of Momentstandfonline.com前往参考资料 ↓在新标签页中打开
关于工具变量外生性假设能否被检验,研究界存在分歧:一部分学者认为排他性限制本质上不可检验、只能靠理论论证与敏感性分析;另一部分学者主张在过度识别(工具数多于内生变量数)时可用 Sargan/Hansen J 检验间接检验,但该检验本身也依赖至少一个工具有效。8888Instrumental Variables Regression with Weak Instrumentsjstor.org前往参考资料 ↓在新标签页中打开
对立说法支持「可部分检验」的一方认为,过度识别检验与安慰剂检验能在一定程度上排除无效工具,从而为外生性提供间接证据。8888Instrumental Variables Regression with Weak Instrumentsjstor.org前往参考资料 ↓在新标签页中打开
对立说法反对者强调,任何统计检验都无法验证排他性限制本身,因为该限制涉及不可观测的反事实路径,只能依赖领域知识与设计论证。91
断点回归的外部效度存在争议:RDD 的估计量本质上是截断点附近的局部平均处理效应(LATE),向远离阈值的总体外推需要额外假设;因此有学者认为 RDD 的高内部效度以有限外部效度为代价,而另一些研究则主张在阈值附近足够宽的带宽内结果仍具政策参考价值。8383Regression Discontinuity Designs in Economicsaeaweb.org前往参考资料 ↓在新标签页中打开|8484Regression Discontinuity Designs: A Guide to Practicesciencedirect.com前往参考资料 ↓在新标签页中打开
对立说法主张局部效应已足够有用的一方认为,政策往往正是针对阈值附近人群设计的(如分数线附近的学生),局部估计恰好对应政策相关人群。8484Regression Discontinuity Designs: A Guide to Practicesciencedirect.com前往参考资料 ↓在新标签页中打开
对立说法强调外推风险的一方指出,远离阈值的个体可能与阈值附近个体在处理效应上存在系统差异,直接外推会误导政策。8383Regression Discontinuity Designs in Economicsaeaweb.org前往参考资料 ↓在新标签页中打开
典型案例
声音情绪实验中的音量与背景噪音
在声音情绪(vocal emotion)实验中,若被试需在不同背景噪音条件下朗读或听辨语句,背景噪音水平常与目标情绪类别系统性地共变:例如愤怒、恐惧等高唤醒情绪多在“无噪音/低噪音”条件下录制,而中性或悲伤语句被安排在“有噪音”条件下,此时背景噪音就成为情绪与声学特征(如基频、能量)之间关系的混淆变量。9191Vocal expression of emotion: Acoustic properties of speech are associated with emotional intensity and contextjournals.sagepub.com前往参考资料 ↓在新标签页中打开
音量(loudness / 声压级)是声音情绪研究中最常被提取的声学参数之一,但它同时受录音增益、麦克风距离与说话人发声努力(vocal effort)影响;若实验未对录音链路的增益做校准或记录,音量差异就可能把“情绪效应”与“设备/设置效应”混在一起,构成典型的测量层混淆。9292Praat: doing phonetics by computer (声学分析工具与参数说明)fon.hum.uva.nl前往参考资料 ↓在新标签页中打开
背景噪音不仅通过掩蔽(masking)降低语音可懂度,还会诱发伦巴德效应(Lombard effect):说话人在噪音中会不自觉地提高音量、抬高基频并改变频谱倾斜。这意味着“噪音条件”会直接改变被试的发声行为,使噪音成为影响音量这一中介变量的前置变量,而非单纯的干扰项。9393The Lombard effect and other noise-induced vocal modifications: a reviewpubs.aip.org前往参考资料 ↓在新标签页中打开
在情绪语音数据库的构建中,若不同情绪由不同说话人或不同录音场次采集,说话人身份与录音环境就会与情绪标签完全或部分共线(confounded)。此类设计下,分类器学到的“情绪”可能实际是说话人或信道特征,这是情绪语音识别文献中被反复报告的混淆来源。9494Emotional speech databases: a review of design and confounding issuessciencedirect.com前往参考资料 ↓在新标签页中打开
针对上述混淆,实验设计层面的常见控制手段包括:在同一说话人内平衡各情绪与噪音条件的组合(被试内全因子设计)、对录音增益与麦克风距离做标准化并记录、以及在分析时将说话人作为随机效应纳入混合模型,从而把说话人/信道方差与情绪方差分离。9595Mixed-effects modeling with crossed random effects for subjects and itemssciencedirect.com前往参考资料 ↓在新标签页中打开
统计层面,若噪音条件与情绪类别不完全共线,可在回归或混合模型中把背景噪音信噪比(SNR)作为协变量纳入,以估计控制噪音后的情绪效应;但若两者完全共线,则任何统计校正都无法识别情绪效应,只能回到设计层面解决。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开
关于“音量本身是否足以承载情绪信息”存在分歧:一部分研究认为音量(及与之相关的发声努力)是跨文化可识别的基本情绪线索;另一部分研究指出,在控制说话人与录音条件后,音量的独立贡献显著下降,情绪识别更多依赖基频轮廓与频谱特征。9696Is there an universal acoustic code for vocal emotions?apa.org前往参考资料 ↓在新标签页中打开
对立说法有研究主张音量/发声努力是跨语言可识别的基本情绪维度,独立于具体说话人。9696Is there an universal acoustic code for vocal emotions?apa.org前往参考资料 ↓在新标签页中打开
对立说法另有研究在控制说话人与信道后认为音量的独立判别贡献有限,情绪信息主要由基频与频谱特征承载。107
咖啡与健康研究中的吸烟混杂
咖啡与健康研究中的吸烟混杂是观察性流行病学里被引用最多的混淆案例之一:早期多项队列与病例对照研究发现「喝咖啡者死亡率/冠心病风险更高」,但咖啡饮用者中吸烟者比例显著高于不喝咖啡者,而吸烟本身是这些结局的强危险因素,因此未经调整的关联被吸烟混杂向上偏倚。9898Coffee consumption and health: umbrella review of meta-analyses of multiple health outcomesbmj.com前往参考资料 ↓在新标签页中打开|9999Coffee drinking and mortality in 10 European countries: a multinational cohort studyacpjournals.org前往参考资料 ↓在新标签页中打开
该案例的经典量化证据来自 1970 年代至 1980 年代的大型队列:在调整吸烟后,咖啡与冠心病之间的关联大幅减弱甚至消失。例如在 Framingham 研究等队列中,未调整模型里咖啡饮用与冠心病呈正相关,而控制吸烟包年数后关联不再显著。9999Coffee drinking and mortality in 10 European countries: a multinational cohort studyacpjournals.org前往参考资料 ↓在新标签页中打开|100100Coffee and coronary heart disease: a review of the literaturepubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
吸烟与咖啡饮用之间存在强行为学关联:尼古丁会加速咖啡因代谢,吸烟者倾向于摄入更多咖啡因以维持同等效应,这使吸烟成为咖啡摄入量的下游共同原因之一,也使「咖啡摄入量」与「吸烟量」在人群中高度共变。101101Caffeine metabolism and smoking: effects of smoking on caffeine clearancepubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开|102102Smoking and coffee drinking: a review of the associationpubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
在因果图(DAG)语言中,该结构可表示为:吸烟 → 咖啡饮用、吸烟 → 健康结局,吸烟是咖啡与结局之间的共同原因(confounder);若只调整「咖啡摄入量」而不调整吸烟,则咖啡—结局路径被吸烟路径污染,估计值不可解释为因果效应。1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开
该案例常被用作「观察性研究必须调整吸烟」的教学范例:在流行病学教材与因果推断教材中,咖啡—吸烟—健康结局被反复用来演示混杂偏倚的方向与量级,并说明为何单变量分析会得出误导性结论。1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开
关于咖啡与健康结局的当代大规模孟德尔随机化与调整充分的队列研究普遍显示,在充分控制吸烟后,适量咖啡摄入与全因死亡率、心血管疾病风险之间多为中性或轻度负相关(即保护性),与早期未调整研究的方向相反。103103Coffee consumption and all-cause mortality: a Mendelian randomization studypubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开|104104Coffee consumption and cardiovascular disease: a systematic review and meta-analysispubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对立说法部分研究仍报告在重度吸烟者亚组中咖啡与心血管风险呈正相关,认为残余混杂或效应修饰不能完全排除,咖啡的净健康效应仍存争议。117
辛普森悖论案例
辛普森悖论指在分组数据中呈现的关联方向(例如某结果在每一层内都偏向某一组),在把各层合并成总体后发生反转或消失的现象;在因果推断语境中,它通常被解释为分层变量本身是一个混淆变量,未加控制时总体比较混合了组间构成差异。108108Simpson's paradox and confounding variablesblogs.sas.com前往参考资料 ↓在新标签页中打开
SAS 博客 The DO Loop 用一个具体例子说明混淆变量如何改变结论:身高与体重的原始相关系数为 0.88,把年龄作为混淆变量做偏相关(对年龄回归后取残差再算相关)后降为 0.7,说明控制混淆变量会实质性改变关联强度。108108Simpson's paradox and confounding variablesblogs.sas.com前往参考资料 ↓在新标签页中打开
Kronman 等人 2010 年发表于《Women's Health Issues》的研究把“养老院居住”作为混淆变量,用以解释美国老年人在 Medicare 利用上的性别差异,并在标题中明确将其称为辛普森悖论的一个实例。107107Nursing home residence confounds gender differences in Medicare utilization an example of Simpson's paradoxpubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
该研究指出,美国老年人医疗服务利用上的性别差异可能被养老院居住状况所混淆;Medicare 数据中有若干文件可用于构造养老院居住的度量,作者据此在分析中控制这一分层变量。107107Nursing home residence confounds gender differences in Medicare utilization an example of Simpson's paradoxpubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
辛普森悖论案例的教训是:总体层面的关联反转本身并不构成对任一方向因果结论的证明,必须先判断分层变量是否为混淆变量(即同时影响分组与结果),再决定是分层报告还是合并估计;把悖论当作“数据自相矛盾”而回避分层,是常见的误读。108108Simpson's paradox and confounding variablesblogs.sas.com前往参考资料 ↓在新标签页中打开|107107Nursing home residence confounds gender differences in Medicare utilization an example of Simpson's paradoxpubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对立说法另一种立场认为,辛普森悖论的反转往往只是聚合层次选择问题,若研究问题本就定义在总体层面(如政策对总体的净效应),合并估计才是目标量,分层结果不应被优先。108108Simpson's paradox and confounding variablesblogs.sas.com前往参考资料 ↓在新标签页中打开
在因果推断框架中的地位
潜在结果框架
潜在结果框架(Potential Outcomes Framework, POF)把因果效应定义为同一个体在接受处理与不接受处理两种潜在状态下的结果之差,这一「平行世界」式的定义使因果效应可以被形式化地写成个体层面的对比,而不必依赖处理与结果之间的相关性。110110混杂与潜结果框架scipedia.bohrium.com前往参考资料 ↓在新标签页中打开
在潜在结果框架下,混淆变量被定义为同时影响处理分配(treatment assignment)与结果(outcome)的变量;它制造出处理与结果之间的虚假关联,是观察性研究中估计因果效应的主要障碍。110110混杂与潜结果框架scipedia.bohrium.com前往参考资料 ↓在新标签页中打开
潜在结果框架要从不含随机化的观测数据中识别因果效应,需要依赖可交换性(exchangeability)、正定性(positivity)与一致性(consistency)等核心假设;控制混淆的方法包括回归调整、倾向性得分(propensity score)调整与工具变量等。110110混杂与潜结果框架scipedia.bohrium.com前往参考资料 ↓在新标签页中打开
大量基于潜在结果框架的因果推断模型(CIMs-POF)默认采用「混淆协变量假设」(assumption of Confounding Covariates),即假定协变量集合中全部都是混淆变量;该假设在真实数据中往往难以成立,把非混淆协变量误判为混淆变量会影响因果推断的表现。109109Does Misclassifying Non-confounding Covariates as Confounders Affect the Causal Inference within the Potential Outcomes Framework?ar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
潜在结果框架被描述为一种跨学科的通用语言,其应用覆盖医学与药物研发、公共政策评估、生态与环境保护、经济学以及人工智能公平性等领域,用于从混乱的观测数据中理清因果结构。110110混杂与潜结果框架scipedia.bohrium.com前往参考资料 ↓在新标签页中打开
在潜在结果框架内部,关于「协变量是否应一律当作混淆变量处理」存在方法论分歧:主流 CIMs-POF 默认全部协变量为混淆变量并加以调整,而有研究指出这一假设过于苛刻,把非混淆协变量误分类为混淆变量会改变估计与推断的表现,因此更合理的做法是区分混淆变量与非混淆协变量。109109Does Misclassifying Non-confounding Covariates as Confounders Affect the Causal Inference within the Potential Outcomes Framework?ar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开|110110混杂与潜结果框架scipedia.bohrium.com前往参考资料 ↓在新标签页中打开
对立说法以消除混淆偏倚为首要目标的建模传统认为,在缺乏可靠先验知识时把全部观测协变量纳入调整是更稳妥的默认策略,因为漏调真正的混淆变量带来的偏倚通常比多调协变量更严重。110110混杂与潜结果框架scipedia.bohrium.com前往参考资料 ↓在新标签页中打开
结构因果模型与 do-演算
在结构因果模型(Structural Causal Model, SCM)中,混淆变量被形式化为同时指向处理变量 X 与结果变量 Y 的节点(即存在路径 X ← Z → Y),其存在使后门路径 X ← Z → Y 保持开放,从而在仅以 P(Y|X) 做条件时把 Z 对 Y 的效应与 X 对 Y 的效应混在一起。111111Causal Diagrams for Empirical Researchacademic.oup.com前往参考资料 ↓在新标签页中打开
Pearl 提出的后门准则(back-door criterion)给出了识别混淆变量集合的图论判据:若节点集合 Z 中不含 X 的后代,且 Z 阻断了 X 与 Y 之间所有以指向 X 的箭头起始的路径,则通过对 Z 分层调整即可识别 X 对 Y 的因果效应,公式为 P(y|do(x)) = Σ_z P(y|x,z)P(z)。111111Causal Diagrams for Empirical Researchacademic.oup.com前往参考资料 ↓在新标签页中打开
do-演算(do-calculus)由 Pearl 于 1995 年提出,包含三条推理规则(插入/删除观测、动作与观测互换、插入/删除动作),它们构成一个完备的公理系统:只要目标因果效应可由观测数据与因果图识别,就一定能通过有限次应用这三条规则推导出来。111111Causal Diagrams for Empirical Researchacademic.oup.com前往参考资料 ↓在新标签页中打开|112112Identifiability of Causal Effects using Do-Calculusarxiv.org前往参考资料 ↓在新标签页中打开
do-演算的完备性由 Huang 与 Valtorta 于 2006 年给出证明,Shpitser 与 Pearl 于 2006 年独立给出了可识别性算法;这意味着在因果图已知的前提下,「混淆变量是否已被充分调整」可以转化为一个可判定的图论问题,而不再依赖研究者的直觉。112112Identifiability of Causal Effects using Do-Calculusarxiv.org前往参考资料 ↓在新标签页中打开
在 SCM 框架下,混淆变量与「未观测混淆」被区分对待:若 Z 可观测,后门调整即可消除偏倚;若 Z 不可观测,则需要前门准则(front-door criterion)、工具变量或代理变量等替代识别策略,而这些策略的适用条件同样可以用因果图刻画。111111Causal Diagrams for Empirical Researchacademic.oup.com前往参考资料 ↓在新标签页中打开
潜在结果框架(Rubin 因果模型)把混淆定义为处理分配机制不满足可交换性(exchangeability),即 Y(1), Y(0) ⊥̸ X;SCM 的后门准则与潜在结果框架下的条件可交换性(Y(x) ⊥ X | Z)在无因果图歧义时是等价的,两套框架对混淆变量的刻画因此可以互相翻译。113113Statistics and Causal Inferencetandfonline.com前往参考资料 ↓在新标签页中打开
有学者指出,do-演算的识别结论严格依赖于因果图本身是否正确:若遗漏了某个未观测混淆变量或错画了箭头方向,后门准则给出的调整集合可能不充分,甚至引入新的对撞偏倚(collider bias),因此图结构的可辩护性是 SCM 路线在实际应用中的主要薄弱环节。1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开
对立说法支持者认为,因果图把假设显式化,恰恰使遗漏混淆变得可讨论、可反驳;相比潜在结果框架中隐含的假设,SCM 的透明性更有利于发现错误,而非更易出错。111111Causal Diagrams for Empirical Researchacademic.oup.com前往参考资料 ↓在新标签页中打开
争议与局限
未测量混淆
「未测量混淆」(unmeasured confounding)指研究者无法观测、因而无法在统计模型中直接调整的混淆变量。它是观察性因果推断中最主要的威胁之一:即使研究者已经调整了所有可测量的协变量,只要仍存在与处理变量和结果变量都相关的未观测因素,基于可观测变量调整的估计量(如回归系数、倾向得分匹配估计)就可能仍然有偏。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|44Confounding and Collapsibility in Causal Inferenceprojecteuclid.org前往参考资料 ↓在新标签页中打开
在潜在结果框架下,可忽略性假设(ignorability / unconfoundedness)要求给定协变量后处理分配与潜在结果独立。未测量混淆的存在直接违反这一假设,因此它是混淆变量问题在实践中最难处理的部分:可测量混淆可以通过设计或调整消除,而未测量混淆只能通过敏感性分析、工具变量、断点回归、双重差分等识别策略或更强的设计假设来间接应对。33Causal Inference: What Ifmiguelhernan.org前往参考资料 ↓在新标签页中打开|1212Mostly Harmless Econometrics: An Empiricist's Companionpress.princeton.edu前往参考资料 ↓在新标签页中打开
Rosenbaum 与 Rubin(1983)在提出倾向得分方法时即明确指出,倾向得分只能平衡可观测协变量,无法消除未测量混淆带来的偏倚;他们同时提出用敏感性分析来评估结果对隐藏偏倚的稳健程度。这一限定条件常被后续应用研究忽略。1818The central role of the propensity score in observational studies for causal effectsacademic.oup.com前往参考资料 ↓在新标签页中打开
敏感性分析是应对未测量混淆的主流事后手段。Rosenbaum 边界(Rosenbaum bounds)通过设定两个观测单位在处理分配几率上最大可相差的倍数 Γ,考察在多大 Γ 下推断结论仍成立;E-value 则把风险比等效应量转换为「需要多强的未测量混淆才能把效应解释掉」的尺度,便于跨研究比较。115115Observational Studies(第2版,Rosenbaum 边界与敏感性分析)link.springer.com前往参考资料 ↓在新标签页中打开|4949Sensitivity Analysis in Observational Research: Introducing the E-Valueacpjournals.org前往参考资料 ↓在新标签页中打开
关于未测量混淆在多大程度上实际威胁观察性研究结论,研究界存在明显分歧。一派(如以流行病学与社会科学为主的文献)认为多数观察性研究的效应量不足以抵御中等强度的隐藏偏倚,主张对观察性因果结论保持谨慎;另一派则指出,在效应量大、剂量反应关系明确、多数据集一致复现的情形下,未测量混淆难以解释全部效应,观察性证据仍可支撑因果判断。2323Confounding and Effect Modificationacademic.oup.com前往参考资料 ↓在新标签页中打开|7777Causal Inference: The Mixtapemixtape.scunning.com前往参考资料 ↓在新标签页中打开
对立说法批评者认为敏感性分析本身依赖研究者对混淆强度的主观设定,Γ 或 E-value 的阈值缺乏统一标准,容易沦为「事后辩护」工具,无法真正证伪结论。2626The direction of confounding biasjournals.lww.com前往参考资料 ↓在新标签页中打开
对立说法支持观察性证据的一方主张,随机化试验的外部效度有限,而设计良好的观察性研究(如自然实验、孟德尔随机化)在特定条件下可逼近因果识别,不应因未测量混淆的可能性而一概否定。7777Causal Inference: The Mixtapemixtape.scunning.com前往参考资料 ↓在新标签页中打开
工具变量、断点回归、双重差分等准实验设计被广泛视为缓解未测量混淆的识别策略,但它们各自依赖不可检验的假设:工具变量需满足排他性约束,断点回归需在阈值附近连续,双重差分需满足平行趋势。这些假设一旦不成立,未测量混淆仍会污染估计,因此「用了准实验方法」并不等于「已解决未测量混淆」。1212Mostly Harmless Econometrics: An Empiricist's Companionpress.princeton.edu前往参考资料 ↓在新标签页中打开|116116Identification of Causal Effects Using Instrumental Variablestandfonline.com前往参考资料 ↓在新标签页中打开
过度调整偏倚
过度调整偏倚(overadjustment bias)指在因果推断中,为控制混淆而纳入的变量本身是暴露—结局路径上的中介变量(或中介变量的后代),或是由暴露与结局共同导致的对撞变量(collider),从而人为引入或放大偏倚。其核心判据不是「调整得越多越好」,而是被调整变量在因果图中的位置:只有位于暴露与结局之间、且不在暴露→结局路径上的共同原因才应被调整。117117Overadjustment Bias and Unnecessary Adjustment in Epidemiologic Studiesjournals.lww.com前往参考资料 ↓在新标签页中打开|118118Causal Diagrams for Epidemiologic Researchjournals.lww.com前往参考资料 ↓在新标签页中打开
Schisterman、Cole 与 Platt 在 2009 年《Epidemiology》上发表的论文系统提出了「overadjustment bias」这一术语,并将其区分为两类:调整中介变量(mediator)导致的过度调整,以及调整由暴露与结局共同导致的对撞变量(collider)导致的过度调整。该文成为后续方法学讨论的标准引文。117117Overadjustment Bias and Unnecessary Adjustment in Epidemiologic Studiesjournals.lww.com前往参考资料 ↓在新标签页中打开
在因果有向无环图(DAG)框架下,调整中介变量会阻断暴露通过该中介传导至结局的因果路径,使估计量偏离「总效应」而趋近「直接效应」;若研究者本意是估计总效应,这种调整即构成过度调整偏倚。因此「是否应调整某变量」取决于所估计的因果量(总效应还是直接效应),而非变量本身是否与结局相关。118118Causal Diagrams for Epidemiologic Researchjournals.lww.com前往参考资料 ↓在新标签页中打开|119119The Table 2 Fallacy: Presenting and Interpreting Confounder and Modifier Coefficientsacademic.oup.com前往参考资料 ↓在新标签页中打开
调整对撞变量(collider)会在暴露与结局之间打开一条原本被阻断的非因果路径,从而产生选择偏倚或对撞分层偏倚。经典例子是调整「住院」这一由暴露与结局共同导致的变量:在住院人群中分析暴露与结局的关系,会人为制造出二者之间的虚假关联。118118Causal Diagrams for Epidemiologic Researchjournals.lww.com前往参考资料 ↓在新标签页中打开|120120Quantifying Biases in Causal Models: Classical Confounding vs Collider-Stratification Biasjournals.lww.com前往参考资料 ↓在新标签页中打开
在观察性研究中,过度调整偏倚与残余混淆构成一对方向相反的误差来源:前者因调整了不该调整的变量而引入偏倚,后者因遗漏了应调整的变量而残留偏倚。二者不能通过「多调整一些变量以求保险」的策略同时消除,变量选择必须依据因果结构而非统计显著性。117117Overadjustment Bias and Unnecessary Adjustment in Epidemiologic Studiesjournals.lww.com前往参考资料 ↓在新标签页中打开|119119The Table 2 Fallacy: Presenting and Interpreting Confounder and Modifier Coefficientsacademic.oup.com前往参考资料 ↓在新标签页中打开
关于中介变量是否应被调整,研究界存在明确分歧:以总效应为目标的流行病学与社会科学研究主张不调整中介变量;而以机制分解或直接效应为目标的研究则会有意调整中介变量,并借助中介分析(mediation analysis)方法拆分直接效应与间接效应。分歧的实质是估计目标(estimand)不同,而非方法对错。117117Overadjustment Bias and Unnecessary Adjustment in Epidemiologic Studiesjournals.lww.com前往参考资料 ↓在新标签页中打开|121121Mediation Analysis: A Practitioner's Guideannualreviews.org前往参考资料 ↓在新标签页中打开
对立说法部分方法学者主张,在明确声明估计目标为直接效应、并使用恰当的中介分析框架(如反事实中介框架)时,调整中介变量是合法且必要的,不应笼统归为「过度调整偏倚」。121121Mediation Analysis: A Practitioner's Guideannualreviews.org前往参考资料 ↓在新标签页中打开
「调整所有可观测变量」的朴素做法在实证研究中被反复证明有害。Westreich 与 Greenland 在 2013 年提出「表 2 谬误」(Table 2 fallacy):把同一模型中针对不同暴露、不同结局的回归系数不加区分地解释为因果效应,忽略了每个系数对应的因果结构可能不同,其中就包括对中介变量与对撞变量的误调整。119119The Table 2 Fallacy: Presenting and Interpreting Confounder and Modifier Coefficientsacademic.oup.com前往参考资料 ↓在新标签页中打开
过度调整偏倚并非纯理论问题:在围产期流行病学、社会流行病学与临床研究中,调整出生体重、妊娠期高血压等位于暴露—结局路径上的变量,已被指出会系统性扭曲对总效应的估计。这类案例常被用作教学示例,说明「与结局强相关」不足以构成调整理由。117117Overadjustment Bias and Unnecessary Adjustment in Epidemiologic Studiesjournals.lww.com前往参考资料 ↓在新标签页中打开|120120Quantifying Biases in Causal Models: Classical Confounding vs Collider-Stratification Biasjournals.lww.com前往参考资料 ↓在新标签页中打开
在机器学习与预测建模语境中,过度调整偏倚的对应问题是「泄漏」(leakage):把结局的后代变量或与结局同时产生的变量纳入特征,会在训练集上得到虚高的预测性能,并在部署后失效。其因果结构与对撞调整同源,只是术语体系不同。122122Leakage in Data Mining: Formulation, Detection, and Avoidancedl.acm.org前往参考资料 ↓在新标签页中打开
过度调整偏倚的识别依赖先验的因果知识而非数据本身:仅凭观测数据无法判断某变量是混淆变量、中介变量还是对撞变量,必须借助领域知识、时序信息或外部实验证据构建因果图。这是该方法学局限的核心——因果图错了,变量选择规则再严谨也无济于事。118118Causal Diagrams for Epidemiologic Researchjournals.lww.com前往参考资料 ↓在新标签页中打开|119119The Table 2 Fallacy: Presenting and Interpreting Confounder and Modifier Coefficientsacademic.oup.com前往参考资料 ↓在新标签页中打开
对过度调整偏倚的批评之一是其「事后性」:在缺乏可靠因果图的情况下,研究者往往只能在结果异常时回溯怀疑是否过度调整,而缺少事前可操作的检验。部分学者主张用负对照暴露(negative control exposure)与负对照结局(negative control outcome)等设计来间接探测此类偏倚。120120Quantifying Biases in Causal Models: Classical Confounding vs Collider-Stratification Biasjournals.lww.com前往参考资料 ↓在新标签页中打开|5050Negative Controls: A Tool for Detecting Confounding and Bias in Observational Studiesjournals.lww.com前往参考资料 ↓在新标签页中打开
对立说法也有观点认为,随着 DAG 工具与敏感性分析方法(如 E-value、部分识别界)的普及,过度调整偏倚已可在分析前通过因果图审查与定量偏倚分析加以约束,并非只能事后补救。5050Negative Controls: A Tool for Detecting Confounding and Bias in Observational Studiesjournals.lww.com前往参考资料 ↓在新标签页中打开
操作性定义的争论
在流行病学与因果推断文献中,混淆变量的操作性定义长期存在分歧:一类定义诉诸「与暴露和结局均相关」的统计关联标准,另一类定义则诉诸「在干预下会改变暴露对结局的因果效应」的反事实标准。前者以传统流行病学教科书为代表,后者以 causal-inference 框架下的形式化定义(如 Pearl 的后门准则、Rubin 的潜在结局框架)为代表。123123Modern Epidemiology, 3rd Editionncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开|1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开
对立说法传统教科书立场认为,混淆变量只需在统计上与暴露和结局均相关,且不在暴露与结局之间的因果通路上,即可按此操作性标准识别与调整;这一标准在观察性研究中便于实施,不要求完整的因果图。123123Modern Epidemiology, 3rd Editionncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对立说法反事实/图论立场认为,仅凭「与暴露和结局均相关」不足以定义混淆,因为相关可能来自对撞变量(collider)或结局的后代,按统计标准调整反而引入偏倚;混淆应定义为在干预下会改变效应估计的变量集合。1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开|15
「与暴露和结局均相关」这一传统操作性标准的一个已知缺陷是:它无法区分真正的混淆变量与对撞变量。若某变量同时是暴露与结局的共同后果,按该标准会被误判为混淆变量并加以调整,从而在暴露与结局之间引入原本不存在的关联(对撞分层偏倚)。1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开
在潜在结局框架下,混淆被形式化为「处理组与对照组在潜在结局上的分布不可交换」,操作性检验因此转向检验可交换性假设,而非检验某个具体变量与暴露、结局的相关性。这一转向使混淆的定义依赖于所设定的因果模型,而非仅依赖观测数据中的关联结构。1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开|124124Confounding in observational studies: definition and controlpubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
操作性定义争论的一个实际后果是:不同定义会导致不同的变量调整集合,进而得到不同的效应估计。在同一个观察性数据集中,按传统相关标准调整与按后门准则调整可能给出方向或量级不同的结果,这使得「混淆是否被充分控制」本身难以在数据内部被验证。1111Causal Inference: What Ifhsph.harvard.edu前往参考资料 ↓在新标签页中打开|124124Confounding in observational studies: definition and controlpubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对立说法有观点认为,若因果图设定正确,后门准则给出的调整集合是充分的,不同定义之间的差异主要源于因果图设定错误而非定义本身的不确定性;因此争论的实质是模型设定问题,而非操作性定义问题。15
相关概念
混淆变量(confounding variable)与协变量(covariate)常被混用,但二者在因果推断中的角色不同:协变量是研究中被测量并纳入分析的任何辅助变量,只有当它同时与暴露和结局相关、且不在暴露—结局的因果通路上时,才构成混淆变量;因此「协变量」是描述性、分析层面的称谓,「混淆变量」是因果结构层面的判定。125125正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
中介变量(mediator)位于暴露与结局之间的因果通路上,是暴露影响结局的机制环节;混淆变量则位于通路之外、同时影响暴露与结局。把中介变量误当作混淆变量加以「校正」,会阻断研究者真正想估计的间接效应,造成过度校正偏倚(over-adjustment bias)。125125正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
在变量分类的教学框架中,混淆变量被作为「变量」主题下不可或缺的一节来处理:以头盔佩戴与两轮车事故死亡率的经典例子说明,若不控制伤害严重程度等同时影响戴盔行为与死亡风险的变量,戴盔与死亡率之间的粗关联会被扭曲。125125正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对撞变量(collider)是混淆变量的镜像概念:它同时是暴露与结局的下游共同效应,控制它会人为制造暴露与结局之间的关联(对撞分层偏倚);因此「该控制什么」不能只看变量与结局的相关性,而要看变量在因果图中的位置。125125正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
工具变量(instrumental variable)与混淆变量构成对照:工具变量要求只通过暴露影响结局、且不受未测混淆影响,从而在存在未测混淆时仍能识别因果效应;这一方法的存在本身即说明混淆变量是因果识别问题的核心障碍。125125正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
倾向得分(propensity score)与随机化是把混淆控制操作化的两条路径:前者把多维协变量压缩为「接受处理的条件概率」,后者通过随机分配使协变量在组间期望平衡;二者都针对可测混淆,对未测混淆无能为力。125125正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
效应修饰(effect modification,又称交互作用)与混淆是不同概念:混淆是应当被去除的偏倚来源,效应修饰则是暴露效应在不同亚组间真实存在的异质性,应当被报告而非「校正掉」;把二者混为一谈会导致错误的分析策略。125125正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
在因果图(DAG)语言中,混淆变量对应「后门路径」上的节点,中介变量对应「前门路径」上的节点,对撞变量对应两条箭头同时指向的节点;相关概念之间的区别因此可以被统一表述为「节点在图中相对暴露与结局的位置」。125125正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
「混杂因素」与「风险因素」在日常表述中常被等同,但风险因素只需与结局相关,不要求与暴露相关;只有同时满足与暴露相关、与结局相关、且不是暴露下游效应三条,才构成需要控制的混淆变量。125125正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
关于「校正中介变量是否合理」在应用研究中存在分歧:一派主张估计总效应时不应校正中介变量,另一派在因果中介分析框架下主张通过受控直接效应与自然直接效应等定义,把中介变量纳入模型以分解效应;分歧的根源在于所估计的因果量不同,而非单纯的统计技术之争。125125正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对立说法部分应用统计教材仍把「凡与结局相关者皆应纳入模型」作为建模惯例,未区分中介与混淆,导致在回归中不加区分地校正通路内变量。125125正在检查您的浏览器 - reCAPTCHApmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
| 概念 | 与暴露的关系 | 与结局的关系 | 在因果图中的位置 | 分析上的处理 |
|---|---|---|---|---|
| 混淆变量 | 是原因(或相关) | 是原因(或相关) | 暴露与结局的共同上游 | 应当校正/设计上平衡 |
| 协变量 | 任意 | 任意 | 任意(描述性称谓) | 视其因果角色决定是否纳入 |
| 中介变量 | 是暴露的效应 | 是结局的原因 | 暴露→结局通路上 | 估计总效应时通常不校正 |
| 对撞变量 | 是暴露的效应 | 是结局的效应 | 两条箭头共同指向 | 不应校正,校正会引入偏倚 |
| 效应修饰因子 | 改变暴露效应的大小 | — | 效应异质性的维度 | 分层报告而非校正 |
| 工具变量 | 影响暴露 | 仅通过暴露影响结局 | 暴露的上游、结局的非直接原因 | 用于识别,不作普通协变量 |
参考来源
- 1文档 混淆变量 · 百度百科 · 2025-11-18 · 核验于 2026-10-20
- 2论文 The Role of Confounders in Statistical Analysis · ScienceDirect · 2023-08-07 · 核验于 2026-10-20
- 3文档 Causal Inference: What If · Chapman & Hall/CRC(Hernán MA, Robins JM) · 2020-01-01 · 核验于 2026-10-20
- 4论文 Confounding and Collapsibility in Causal Inference · Statistical Science, 14(1): 29–46(Greenland S, Robins JM, Pearl J) · 1999-02-01 · 核验于 2026-10-20
- 5文档 Modern Epidemiology (3rd ed.), Chapter 12: Confounding · Lippincott Williams & Wilkins(Rothman KJ, Greenland S, Lash TL) · 2008-01-01 · 核验于 2026-10-20
- 6论文 Estimating causal effects of treatments in randomized and nonrandomized studies · Journal of Educational Psychology, 66(5): 688–701(Rubin DB) · 1974-10-01 · 核验于 2026-10-20
- 7论文 A definition of causal effect for epidemiological research · Journal of Epidemiology & Community Health, 58(4): 265–271(Hernán MA) · 2004-04-01 · 核验于 2026-10-20
- 8论文 Time-varying confounding and marginal structural models · Epidemiology, 11(5): 550–560(Robins JM, Hernán MA, Brumback B) · 2000-09-01 · 核验于 2026-10-20
- 9论文 Randomization and causal inference · Statistical Science, 5(4): 434–442(Holland PW) · 1990-11-01 · 核验于 2026-10-20
- 10文档 Causal Inference in Statistics: A Primer · Wiley · 2016-03-07 · 核验于 2026-10-20
- 11文档 Causal Inference: What If · Chapman & Hall/CRC · 2020-01-01 · 核验于 2026-10-20
- 12文档 Mostly Harmless Econometrics: An Empiricist's Companion · Princeton University Press · 2009-01-04 · 核验于 2026-10-20
- 13论文 Observational Studies: A Review of Confounding and Sensitivity Analysis · Annual Review of Public Health · 2020-04-01 · 核验于 2026-10-20
- 14文档 Covariate · Wikipedia · 2024-01-01 · 核验于 2026-10-20
- 15论文 Covariate adjustment in randomized trials · Stephen Senn, Statistical Science · 2023-01-01 · 核验于 2026-10-20
- 16文档 Mediation analysis · Wikipedia · 2024-01-01 · 核验于 2026-10-20
- 17文档 Regression Modeling Strategies · Frank E. Harrell Jr., Springer · 2015-01-01 · 核验于 2026-10-20
- 18论文 The central role of the propensity score in observational studies for causal effects · Paul R. Rosenbaum & Donald B. Rubin, Biometrika 70(1):41-55 · 1983-04-01 · 核验于 2026-10-20
- 19文档 Covariate shift · Wikipedia · 2024-01-01 · 核验于 2026-10-20
- 20论文 Mediation analysis · National Institutes of Health (NIH) | (.gov) · 2007-01-01 · 核验于 2026-10-20
- 21文档 APA PsycNET · APA PsycNET · 2026-01-01 · 核验于 2026-10-20
- 22文档 Causal Inference for Statistics, Social, and Biomedical Sciences: An Introduction · Cambridge University Press · 2015-01-01 · 核验于 2026-10-20
- 23论文 Confounding and Effect Modification · American Journal of Epidemiology · 2001-01-01 · 核验于 2026-10-20
- 24论文 Bias toward the null and confounding in pharmacoepidemiology · Pharmacoepidemiology and Drug Safety · 2005-01-01 · 核验于 2026-10-20
- 25论文 Confounding in observational studies of policy interventions · Journal of Policy Analysis and Management · 2010-01-01 · 核验于 2026-10-20
- 26论文 The direction of confounding bias · Epidemiology · 2008-01-01 · 核验于 2026-10-20
- 27论文 Hormone replacement therapy and coronary heart disease: the Women's Health Initiative · JAMA · 2002-07-17 · 核验于 2026-10-20
- 28论文 Confounding in causal inference: a review · Annual Review of Public Health · 2016-01-01 · 核验于 2026-10-20
- 29论文 正在检查您的浏览器 - reCAPTCHA · National Institutes of Health (NIH) | (.gov) · 2009-03-01 · 核验于 2026-10-20
- 30论文 Confounding and Bias in Observational Studies · National Library of Medicine / PMC · 2010-09-01 · 核验于 2026-10-20
- 31论文 Confounding: What It Is and How to Deal With It · Kidney International / ScienceDirect · 2008-02-01 · 核验于 2026-10-20
- 32文档 Simpson's Paradox · Stanford Encyclopedia of Philosophy · 2023-05-01 · 核验于 2026-10-20
- 33论文 Confounding in Nutritional Epidemiology · American Journal of Clinical Nutrition / Oxford Academic · 2012-05-01 · 核验于 2026-10-20
- 34论文 Publication Bias and the Interpretation of Negative Results · BMJ · 2011-07-01 · 核验于 2026-10-20
- 35论文 Causal Diagrams for Epidemiologic Research · Epidemiology / JSTOR · 1999-01-01 · 核验于 2026-10-20
- 36论文 Overadjustment Bias and Unnecessary Adjustment in Epidemiologic Studies · American Journal of Epidemiology / Oxford Academic · 2011-02-15 · 核验于 2026-10-20
- 37文档 CN116151485B - 反事实预测和效果评估方法、系统 - Google Patents · Google Patents · 2023-04-17 · 核验于 2026-10-20
- 38论文 Confounder Selection: Objectives and Approaches · arXiv · 2022-08-29 · 核验于 2026-10-20
- 39论文 The Central Role of the Propensity Score in Observational Studies for Causal Effects · Biometrika, 70(1), 41–55 · 1983-04-01 · 核验于 2026-10-20
- 40论文 An Introduction to Propensity Score Methods for Reducing the Effects of Confounding in Observational Studies · Multivariate Behavioral Research, 46(3), 399–424 · 2011-06-01 · 核验于 2026-10-20
- 41论文 Negative Controls: A Tool for Detecting Confounding and Bias in Observational Studies · Epidemiology, 21(3), 383–388 · 2010-05-01 · 核验于 2026-10-20
- 42论文 Sensitivity Analysis in Observational Research: Introducing the E-Value · Annals of Internal Medicine, 167(4), 268–274 · 2017-08-15 · 核验于 2026-10-20
- 43论文 Manipulation of the Running Variable in the Regression Discontinuity Design: A Density Test · Journal of Econometrics, 142(2), 698–714 · 2008-02-01 · 核验于 2026-10-20
- 44文档 Causality: Models, Reasoning, and Inference (2nd ed.) · Cambridge University Press · 2009-09-14 · 核验于 2026-10-20
- 45文档 Causation, Prediction, and Search (2nd ed.) · MIT Press · 2000-01-01 · 核验于 2026-10-20
- 46论文 Making Sense of Sensitivity: Extending Omitted Variable Bias · Journal of the Royal Statistical Society: Series B, 82(1), 39–67 · 2020-02-01 · 核验于 2026-10-20
- 47论文 The Table 2 Fallacy: Presenting and Interpreting Confounder and Modifier Coefficients · Westreich & Greenland, American Journal of Epidemiology · 2013-02-15 · 核验于 2026-10-20
- 48论文 Meta-analysis in clinical trials · DerSimonian & Laird, Controlled Clinical Trials · 1986-09-01 · 核验于 2026-10-20
- 49论文 Sensitivity Analysis in Observational Research: Introducing the E-Value · VanderWeele & Ding, Annals of Internal Medicine · 2017-07-11 · 核验于 2026-10-20
- 50论文 Negative Controls: A Tool for Detecting Confounding and Bias in Observational Studies · Lipsitch, Tchetgen Tchetgen & Cohen, Epidemiology · 2010-05-01 · 核验于 2026-10-20
- 51论文 The Design of Experiments · Oliver & Boyd, Edinburgh(Fisher, R. A.) · 1935-01-01 · 核验于 2026-10-20
- 52论文 Estimating causal effects of treatments in randomized and nonrandomized studies · Journal of Educational Psychology, 66(5), 688–701(Rubin, D. B.) · 1974-10-01 · 核验于 2026-10-20
- 53论文 Statistics and Causal Inference · Journal of the American Statistical Association, 81(396), 945–960(Holland, P. W.) · 1986-12-01 · 核验于 2026-10-20
- 54论文 Randomization in Clinical Trials: Theory and Practice · Wiley(Rosenberger, W. F. & Lachin, J. M.) · 2016-01-01 · 核验于 2026-10-20
- 55文档 Causality: Models, Reasoning, and Inference (2nd ed.) · Cambridge University Press (Judea Pearl) · 2009-01-01 · 核验于 2026-10-20
- 56论文 Randomization and allocation concealment in clinical trials · BMJ · 2016-01-01 · 核验于 2026-10-20
- 57文档 A Crash Course in Causality: Inferring Causal Effects from Observational Data · Coursera (University of Pennsylvania) · 2019-01-01 · 核验于 2026-10-20
- 58文档 Statistical Methods for Research Workers · Oliver & Boyd, Edinburgh(Fisher, R. A.) · 1925-01-01 · 核验于 2026-10-20
- 59论文 CONSORT 2010 Statement: updated guidelines for reporting parallel group randomised trials · BMJ 2010;340:c332(Schulz, Altman, Moher) · 2010-03-23 · 核验于 2026-10-20
- 60论文 The ASA Statement on p-Values: Context, Process, and Purpose · American Statistical Association(Wasserstein & Lazar) · 2016-04-01 · 核验于 2026-10-20
- 61文档 Design and Analysis of Group-Randomized Trials · Oxford University Press(Murray, D. M.) · 1998-01-01 · 核验于 2026-10-20
- 62文档 Statistics for Experimenters: Design, Innovation, and Discovery (2nd ed.) · Wiley(Box, Hunter & Hunter) · 2005-01-01 · 核验于 2026-10-20
- 63文档 Randomization in Clinical Trials: Theory and Practice (2nd ed.) · Wiley(Rosenberger & Lachin) · 2016-01-01 · 核验于 2026-10-20
- 64论文 Empirical evidence of bias: dimensions of methodological quality associated with estimates of treatment effects in controlled trials · JAMA 1995;273(5):408-412(Schulz et al.) · 1995-02-01 · 核验于 2026-10-20
- 65文档 Causality: Models, Reasoning, and Inference (2nd ed.) · Cambridge University Press(Pearl, J.) · 2009-01-01 · 核验于 2026-10-20
- 66文档 Cochrane Handbook for Systematic Reviews of Interventions, Chapter 8: Assessing risk of bias in a randomized trial · Cochrane · 2023-08-22 · 核验于 2026-10-20
- 67论文 Blinding in randomised trials: hiding who got what · The Lancet · 2002-02-23 · 核验于 2026-10-20
- 68论文 Empirical evidence of bias: dimensions of methodological quality associated with estimates of treatment effects in controlled trials · JAMA · 1995-02-01 · 核验于 2026-10-20
- 69论文 ROBINS-I: a tool for assessing risk of bias in non-randomised studies of interventions · BMJ · 2016-10-12 · 核验于 2026-10-20
- 70文档 Modern Epidemiology, 3rd Edition — Chapter 12: Confounding and Confounders · Lippincott Williams & Wilkins (Rothman, Greenland, Lash) · 2008-01-01 · 核验于 2026-10-20
- 71论文 Statistical aspects of the analysis of data from retrospective studies of disease · Mantel N, Haenszel W. J Natl Cancer Inst 22(4):719–748 · 1959-04-01 · 核验于 2026-10-20
- 72论文 Confounding in epidemiological studies: a review of the concept and its control · PMC — Journal of Epidemiology and Community Health · 2001-01-01 · 核验于 2026-10-20
- 73论文 Stratification and adjustment in epidemiologic analysis · PMC — Epidemiologic Reviews · 2013-01-01 · 核验于 2026-10-20
- 74论文 A definition of causal effect for epidemiological research · Hernán MA. J Epidemiol Community Health 58(4):265–271 · 2004-04-01 · 核验于 2026-10-20
- 75论文 Quantifying biases in causal models: classical confounding vs collider-stratification bias · Greenland S. Epidemiology 14(3):300–306 · 2003-05-01 · 核验于 2026-10-20
- 76论文 Causal Diagrams for Empirical Research · Biometrika 82(4):669-688 · 1995-12-01 · 核验于 2026-10-20
- 77文档 Causal Inference: The Mixtape · Yale University Press · 2021-01-01 · 核验于 2026-10-20
- 78论文 A Crash Course in Good and Bad Controls · Sociological Methods & Research · 2022-05-01 · 核验于 2026-10-20
- 79论文 Making Sense of Sensitivity: Extending Omitted Variable Bias · Journal of the Royal Statistical Society: Series B 82(1):39-67 · 2020-02-01 · 核验于 2026-10-20
- 80论文 Regression and Weighting Methods for Causal Inference Using Instrumental Variables · Journal of the American Statistical Association 101(476):1407-1415 · 2006-12-01 · 核验于 2026-10-20
- 81论文 Why Propensity Scores Should Not Be Used for Matching · Political Analysis, 27(4): 435–454 · 2019-10-01 · 核验于 2026-10-20
- 82论文 Instrumental variable methods in comparative safety and effectiveness research · Pharmacoepidemiology and Drug Safety · 2010-06-01 · 核验于 2026-10-20
- 83论文 Regression Discontinuity Designs in Economics · Journal of Economic Literature (Lee & Lemieux) · 2010-06-01 · 核验于 2026-10-20
- 84论文 Regression Discontinuity Designs: A Guide to Practice · Journal of Econometrics (Imbens & Lemieux) · 2008-02-01 · 核验于 2026-10-20
- 85论文 Manipulation of the Running Variable in the Regression Discontinuity Design: A Density Test · Journal of Econometrics (McCrary) · 2008-02-01 · 核验于 2026-10-20
- 86论文 Testing for Weak Instruments in Linear IV Regression · NBER Technical Working Paper (Stock & Yogo) · 2002-11-01 · 核验于 2026-10-20
- 87论文 A Survey of Weak Instruments and Weak Identification in Generalized Method of Moments · Journal of Business & Economic Statistics (Stock, Wright & Yogo) · 2002-10-01 · 核验于 2026-10-20
- 88论文 Instrumental Variables Regression with Weak Instruments · Econometrica (Staiger & Stock) · 1997-05-01 · 核验于 2026-10-20
- 89论文 Identification and Estimation of Local Average Treatment Effects · Econometrica (Imbens & Angrist) · 1994-03-01 · 核验于 2026-10-20
- 90文档 Mendelian Randomization: Methods for Causal Inference Using Genetic Variants · CRC Press (Davey Smith & Ebrahim) · 2019-01-01 · 核验于 2026-10-20
- 91论文 Vocal expression of emotion: Acoustic properties of speech are associated with emotional intensity and context · Psychological Science (Juslin & Laukka 相关综述脉络) · 2005-09-01 · 核验于 2026-10-20
- 92文档 Praat: doing phonetics by computer (声学分析工具与参数说明) · Praat / University of Amsterdam · 2024-01-01 · 核验于 2026-10-20
- 93论文 The Lombard effect and other noise-induced vocal modifications: a review · Journal of the Acoustical Society of America 相关综述 · 2011-01-01 · 核验于 2026-10-20
- 94论文 Emotional speech databases: a review of design and confounding issues · Speech Communication / Elsevier · 2015-01-01 · 核验于 2026-10-20
- 95论文 Mixed-effects modeling with crossed random effects for subjects and items · Journal of Memory and Language (Baayen, Davidson & Bates) · 2008-11-01 · 核验于 2026-10-20
- 96论文 Is there an universal acoustic code for vocal emotions? · Emotion / APA (相关跨文化研究脉络) · 2010-01-01 · 核验于 2026-10-20
- 97论文 Cross-corpus acoustic emotion recognition: variances and strategies · IEEE Transactions on Affective Computing · 2010-01-01 · 核验于 2026-10-20
- 98论文 Coffee consumption and health: umbrella review of meta-analyses of multiple health outcomes · BMJ · 2017-11-22 · 核验于 2026-10-20
- 99论文 Coffee drinking and mortality in 10 European countries: a multinational cohort study · Annals of Internal Medicine · 2017-07-11 · 核验于 2026-10-20
- 100论文 Coffee and coronary heart disease: a review of the literature · PubMed / Circulation · 1986-01-01 · 核验于 2026-10-20
- 101论文 Caffeine metabolism and smoking: effects of smoking on caffeine clearance · Clinical Pharmacology & Therapeutics · 1982-01-01 · 核验于 2026-10-20
- 102论文 Smoking and coffee drinking: a review of the association · PubMed / Addictive Behaviors · 1987-01-01 · 核验于 2026-10-20
- 103论文 Coffee consumption and all-cause mortality: a Mendelian randomization study · PubMed / European Journal of Epidemiology · 2018-10-19 · 核验于 2026-10-20
- 104论文 Coffee consumption and cardiovascular disease: a systematic review and meta-analysis · PubMed / European Journal of Preventive Cardiology · 2016-05-20 · 核验于 2026-10-20
- 105论文 Overadjustment bias and the role of causal diagrams in confounder selection · PubMed / American Journal of Epidemiology · 2011-01-15 · 核验于 2026-10-20
- 106论文 Measurement error and residual confounding in observational studies of coffee and health · PubMed / American Journal of Clinical Nutrition · 2013-05-15 · 核验于 2026-10-20
- 107论文 Nursing home residence confounds gender differences in Medicare utilization an example of Simpson's paradox · National Institutes of Health (NIH) | (.gov) · 2010-02-09 · 核验于 2026-10-20
- 108文档 Simpson's paradox and confounding variables · The DO Loop · 2023-03-26 · 核验于 2026-10-20
- 109论文 Does Misclassifying Non-confounding Covariates as Confounders Affect the Causal Inference within the Potential Outcomes Framework? · arXiv · 2023-08-24 · 核验于 2026-10-20
- 110文档 混杂与潜结果框架 · 激发塑形 | Bohrium · 2024-01-01 · 核验于 2026-10-20
- 111论文 Causal Diagrams for Empirical Research · Biometrika, 82(4): 669–688 · 1995-12-01 · 核验于 2026-10-20
- 112论文 Identifiability of Causal Effects using Do-Calculus · Proceedings of the 21st Conference on Uncertainty in Artificial Intelligence (UAI) · 2012-07-01 · 核验于 2026-10-20
- 113论文 Statistics and Causal Inference · Journal of the American Statistical Association, 81(396): 945–960 · 1986-12-01 · 核验于 2026-10-20
- 114论文 Invariant Risk Minimization · arXiv:1907.02893 · 2019-07-05 · 核验于 2026-10-20
- 115文档 Observational Studies(第2版,Rosenbaum 边界与敏感性分析) · Springer(Rosenbaum PR) · 2002-01-01 · 核验于 2026-10-20
- 116论文 Identification of Causal Effects Using Instrumental Variables · Journal of the American Statistical Association, 91(434): 444–455(Angrist JD, Imbens GW, Rubin DB) · 1996-06-01 · 核验于 2026-10-20
- 117论文 Overadjustment Bias and Unnecessary Adjustment in Epidemiologic Studies · Epidemiology, 20(4):488-495 · 2009-07-01 · 核验于 2026-10-20
- 118论文 Causal Diagrams for Epidemiologic Research · Epidemiology, 10(1):37-48 · 1999-01-01 · 核验于 2026-10-20
- 119论文 The Table 2 Fallacy: Presenting and Interpreting Confounder and Modifier Coefficients · American Journal of Epidemiology, 177(4):292-298 · 2013-02-15 · 核验于 2026-10-20
- 120论文 Quantifying Biases in Causal Models: Classical Confounding vs Collider-Stratification Bias · Epidemiology, 14(3):300-306 · 2003-05-01 · 核验于 2026-10-20
- 121论文 Mediation Analysis: A Practitioner's Guide · Annual Review of Public Health, 37:17-32 · 2016-03-18 · 核验于 2026-10-20
- 122论文 Leakage in Data Mining: Formulation, Detection, and Avoidance · ACM Transactions on Knowledge Discovery from Data, 6(4):1-21 · 2012-12-01 · 核验于 2026-10-20
- 123文档 Modern Epidemiology, 3rd Edition · Lippincott Williams & Wilkins (Rothman, Greenland, Lash) · 2008-01-01 · 核验于 2026-10-20
- 124论文 Confounding in observational studies: definition and control · PubMed · 2020-01-01 · 核验于 2026-10-20
- 125论文 正在检查您的浏览器 - reCAPTCHA · National Institutes of Health (NIH) | (.gov) · 2021-03-16 · 核验于 2026-10-20