机器学习
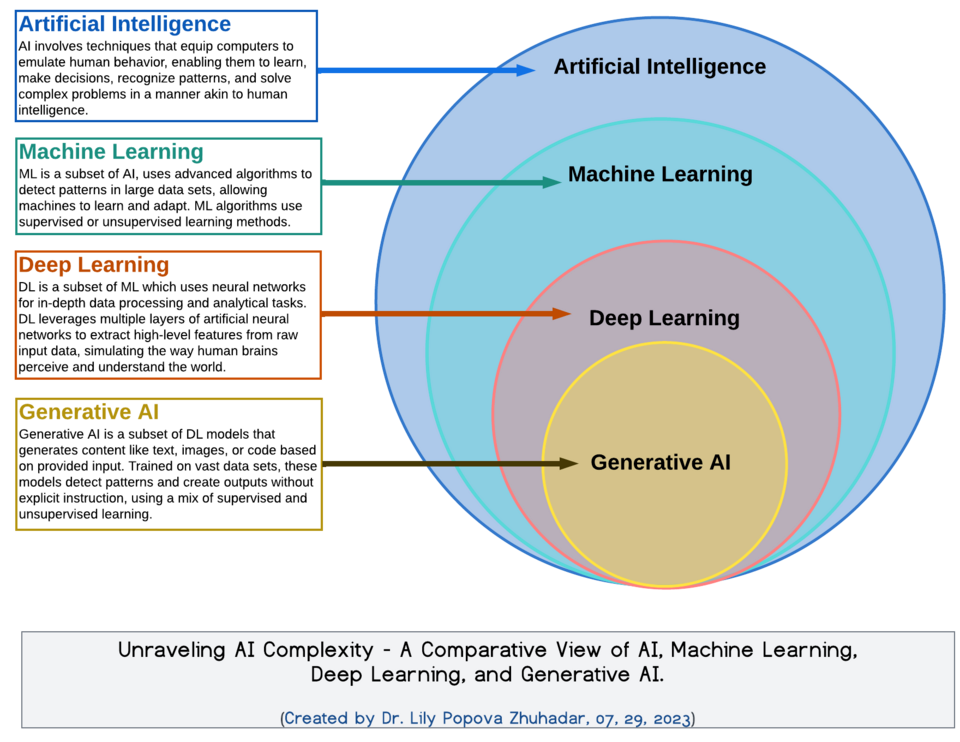
- 英文名
- Machine Learning
- 缩写
- ML
- 上位领域
- 人工智能
- 核心范式
- 监督学习、无监督学习、强化学习
- 典型任务
- 分类、回归、聚类、生成
- 关键要素
- 数据、模型、损失函数、优化算法
机器学习是人工智能的一个子集,指利用计算机算法通过经验自动完成特定任务,即从数据中学习模式而非依赖显式编程规则。11General Machine Learning - Chapters and Articlessciencedirect.com前往参考资料 ↓在新标签页中打开
按学习信号的不同,机器学习方法通常分为监督学习、无监督学习和强化学习三大类;监督学习向算法提供带输出标签的训练样本,无监督学习则在没有标签的数据中寻找结构。22Table 1 Categories of ML modelsembargoed.www.cell.com前往参考资料 ↓在新标签页中打开
定义与定位
与人工智能、深度学习的关系
在通行的学科层级划分中,人工智能是范围最广的领域,机器学习被视为人工智能的一个子集,而深度学习又被视为机器学习的子集,三者构成逐层包含的关系。44深度学习----科学智慧火花idea.cas.cn前往参考资料 ↓在新标签页中打开|55Cornell Virtual Workshop > An Overview of AI > Machine Learning and Deep Learning > Functionality and Implementationcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开
人工智能并不等同于机器学习:人工智能领域包含许多不涉及机器学习的方面,例如知识表示、演绎推理与问题求解、运动与控制等,机器学习只是其中的主要组成部分之一。44深度学习----科学智慧火花idea.cas.cn前往参考资料 ↓在新标签页中打开|55Cornell Virtual Workshop > An Overview of AI > Machine Learning and Deep Learning > Functionality and Implementationcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开
机器学习指使用能够从数据中学习模式与结构的算法,而无需就这些模式的细节被逐条显式指定;这一定位把它与依赖人工编写规则的传统程序区分开来。55Cornell Virtual Workshop > An Overview of AI > Machine Learning and Deep Learning > Functionality and Implementationcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开
与传统编程的区别
传统编程的基本形态是:程序员把完成任务所需的规则与步骤显式写成算法,算法再被翻译成程序,程序接收输入数据后按既定指令产出结果;规则本身不随数据改变。66AI 说(AI Speak):机器学习 – 面向教师的人工智能教程: 一本开放式教科书aiopentext.itd.cnr.it前往参考资料 ↓在新标签页中打开
机器学习与传统编程的关键区别在于规则的来源:传统编程由人预先设定全部参数与动作,机器学习则由算法分析数据、寻找模式,从数据中把参数(模型中的系数或权重)学出来,再用训练好的模型做预测。66AI 说(AI Speak):机器学习 – 面向教师的人工智能教程: 一本开放式教科书aiopentext.itd.cnr.it前往参考资料 ↓在新标签页中打开|77AI4K12 邮件列表讨论:传统编程与人工智能的区别lists.aaai.org前往参考资料 ↓在新标签页中打开
由于规则不是人逐条写死的,机器学习方法适合处理复杂、不完整的数据,并在运行中依据自身表现的反馈继续调整改进;而指令无法随数据自适应调整的传统程序,在预测不完整信息、自然语言处理等任务上表现不佳。66AI 说(AI Speak):机器学习 – 面向教师的人工智能教程: 一本开放式教科书aiopentext.itd.cnr.it前往参考资料 ↓在新标签页中打开
机器学习与传统编程的差别常被类比为人类学习:观察、重复、测试并改进;但这种类比只是表面相似,人类的“学习”比机器学习微妙、复杂得多,二者不可等同。66AI 说(AI Speak):机器学习 – 面向教师的人工智能教程: 一本开放式教科书aiopentext.itd.cnr.it前往参考资料 ↓在新标签页中打开
发展简史
早期符号主义与统计学习
现代机器学习的思想源头之一可追溯到 1943 年 McCulloch 与 Pitts 提出的形式化神经元模型:他们把神经活动抽象为二值阈值单元,并证明由这类单元组成的网络可以实现命题逻辑运算。88A Logical Calculus of the Ideas Immanent in Nervous Activitylink.springer.com前往参考资料 ↓在新标签页中打开
1949 年 Hebb 在《行为的组织》中提出突触可塑性假说,即后来所称的 Hebb 学习规则:当两个神经元同时兴奋时,它们之间的连接会被加强。这一规则成为早期神经网络学习算法的生物学依据。99The Organization of Behavior: A Neuropsychological Theoryarchive.org前往参考资料 ↓在新标签页中打开
1958 年 Rosenblatt 提出感知机(perceptron),它是一种通过误差修正规则训练的单层线性分类器,并在硬件 Mark I Perceptron 上实现,用于图像识别实验。1010The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brainpsycnet.apa.org前往参考资料 ↓在新标签页中打开
1969 年 Minsky 与 Papert 出版《Perceptrons》,严格证明单层感知机无法表示异或(XOR)等非线性可分函数,并指出多层网络的训练缺乏有效算法。该书常被视为神经网络研究在 1970 年代进入低潮的重要诱因。1111Perceptrons: An Introduction to Computational Geometrymitpress.mit.edu前往参考资料 ↓在新标签页中打开
1986 年 Rumelhart、Hinton 与 Williams 在《Nature》发表反向传播算法用于多层网络训练的工作,使含隐藏层的网络可以通过梯度下降学习,重新激活了连接主义研究。1212Learning Representations by Back-Propagating Errorsnature.com前往参考资料 ↓在新标签页中打开
反向传播的数学基础并非 1986 年首创:Werbos 在 1974 年的博士论文中已提出类似的反向求导方法,Parker 与 LeCun 也在 1980 年代中期独立提出了相近算法。1313Beyond Regression: New Tools for Prediction and Analysis in the Behavioral Sciencessemanticscholar.org前往参考资料 ↓在新标签页中打开
与神经网络并行,符号主义在 1950—1980 年代占据主流:1956 年达特茅斯会议确立了「人工智能」这一名称,Newell 与 Simon 的 Logic Theorist(1956)和通用问题求解器(GPS)以符号搜索与启发式规则模拟推理。1414A Proposal for the Dartmouth Summer Research Project on Artificial Intelligencejmc.stanford.edu前往参考资料 ↓在新标签页中打开
符号主义专家系统在 1980 年代进入商业应用,例如用于医疗诊断的 MYCIN 和用于计算机配置的 XCON;但知识获取瓶颈、规则维护困难与推理的组合爆炸,使专家系统在 1980 年代末遭遇挫折。1515Rule-Based Expert Systems: The MYCIN Experiments of the Stanford Heuristic Programming Projectsciencedirect.com前往参考资料 ↓在新标签页中打开
统计学习在 1960—1990 年代逐步成型:Vapnik 与 Chervonenkis 在 1960—1970 年代提出 VC 维与经验风险最小化的一致性理论,为学习算法的泛化能力提供了理论框架。1616On the Uniform Convergence of Relative Frequencies of Events to Their Probabilitiesepubs.siam.org前往参考资料 ↓在新标签页中打开
1995 年 Cortes 与 Vapnik 发表支持向量机(SVM)的软间隔版本,结合核技巧在高维空间中构造最大间隔分类器,成为 1990 年代至 2000 年代统计学习的主流方法之一。1717Support-Vector Networkslink.springer.com前往参考资料 ↓在新标签页中打开
1980 年代至 1990 年代,决策树与集成方法也相继成熟:Quinlan 的 ID3(1986)与 C4.5(1993)推动了决策树的实用化,Breiman 等人在 1984 年提出 CART,Freund 与 Schapire 在 1997 年提出 AdaBoost。1818Induction of Decision Treeslink.springer.com前往参考资料 ↓在新标签页中打开
神经网络的复兴
1986年,鲁梅尔哈特(Rumelhart)、辛顿(Hinton)等人提出反向传播算法用于训练多层神经网络,使具备非线性学习能力的多层感知机成为可能,被视为神经网络复兴的关键转折点。2323机器学习wapbaike.baidu.com前往参考资料 ↓在新标签页中打开|2424(图解)类神经网络的复兴:深度学习简史-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
1980年,福岛邦彦提出神经认知机(Neocognitron),被视为最早的卷积神经网络雏形,模拟人类视觉机制用于图像识别。2323机器学习wapbaike.baidu.com前往参考资料 ↓在新标签页中打开
1982年,约翰·霍普费尔德(John Hopfield)提出霍普费尔德网络(Hopfield network),被视为循环神经网络的雏形,具备处理序列数据的记忆能力,后被应用于自然语言处理、语音识别和时间序列预测。2323机器学习wapbaike.baidu.com前往参考资料 ↓在新标签页中打开
早期单层感知机是线性模型,无法解决线性不可分问题,这导致感知机神经网络在早期未受重视;反向传播算法使多层感知机具备非线性学习能力,才让神经网络重新受到关注。2424(图解)类神经网络的复兴:深度学习简史-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
深度学习时代
深度学习时代的标志性起点通常被追溯到 2012 年的 AlexNet:它在 ImageNet 大规模视觉识别竞赛中以显著优势夺冠,使深度卷积神经网络从长期边缘化的方法变成计算机视觉的主流路线。2525图文详情——科普中国资源服务cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
深度学习并非 2012 年凭空出现,其技术谱系可上溯到 1943 年 McCulloch-Pitts 神经元模型、1957 年 Rosenblatt 的感知机,以及 20 世纪 60 年代的多层感知机(MLP)研究;这些早期工作确立了「加权求和加非线性激活」的基本计算单元。2626Key Steps Forwardccrma.stanford.edu前往参考资料 ↓在新标签页中打开
反向传播所依赖的梯度下降思想早在 1847 年即由柯西提出,而 1960 年前后最优控制与自适应滤波(LMS 算法)领域对梯度法的独立发展,为后来神经网络的可训练化提供了数学工具。2626Key Steps Forwardccrma.stanford.edu前往参考资料 ↓在新标签页中打开
主要范式
监督学习
监督学习是机器学习的一种范式,其基本设定是:给定由输入对象与对应期望输出(标签)组成的成对训练样本,算法从这些样本中学习一个从输入到输出的映射(模型),并希望该映射能对未见过的输入给出正确预测。2727监督学习 - 维基百科,自由的百科全书zh.wikipedia.org前往参考资料 ↓在新标签页中打开
在监督学习中,训练数据中的每个样本都带有标签,标签可以是离散的类别(对应分类任务),也可以是连续的数值(对应回归任务);这一「有标签」的特征是监督学习区别于无监督学习(训练数据无标签)的核心标志。2727监督学习 - 维基百科,自由的百科全书zh.wikipedia.org前往参考资料 ↓在新标签页中打开
监督学习的目标不是记住训练样本,而是获得泛化能力:模型在训练集上表现好并不保证在新数据上表现好,因此实践中通常把数据划分为训练集与测试集(或验证集),用未参与训练的样本来评估模型的泛化性能。2727监督学习 - 维基百科,自由的百科全书zh.wikipedia.org前往参考资料 ↓在新标签页中打开
监督学习是机器学习中应用最广泛、研究最成熟的范式之一,分类与回归两类任务覆盖了从垃圾邮件识别、图像识别到房价预测、销量预测等大量实际问题。2727监督学习 - 维基百科,自由的百科全书zh.wikipedia.org前往参考资料 ↓在新标签页中打开
无监督学习
无监督学习(unsupervised learning)指训练数据不含人工标注标签、模型直接对数据本身进行建模的一类机器学习方法;它与监督学习的核心区别在于训练样本是否带有标签。2222[科普中国]-无监督训练- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
按训练样本标签的有无,机器学习常被划分为监督学习与无监督学习两大类;在分类任务中,若全部训练数据都带标签则为监督学习,若数据没有标签则归入无监督学习。2222[科普中国]-无监督训练- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
聚类是无监督学习最典型的代表任务:在没有标签的情况下,依据数据自身的特征结构把样本分组,使同组样本彼此相似、不同组样本差异较大。2222[科普中国]-无监督训练- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
自动编码器是无监督训练的一类实现模型,其基本思路是重建输入:网络学习把输入压缩为低维表示再还原,以重建误差作为训练信号,且可以堆叠成多层。2222[科普中国]-无监督训练- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
在逐层贪婪预训练的做法中,各层被依次单独训练,训练第 i 层时固定其前面所有层,且每一层所用的都是无监督表征学习算法;这一路线常被用于深度网络的预训练阶段。2222[科普中国]-无监督训练- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
强化学习
强化学习(Reinforcement Learning, RL)是机器学习的主要范式之一,与监督学习、无监督学习并列;其核心特征是智能体(agent)在动态环境中通过试错交互获得反馈信号,目标是找到能带来最佳长期结果的动作序列,而非对静态数据集做聚类或打标签。2828探索自主智能技术 - Traininglearn.microsoft.com前往参考资料 ↓在新标签页中打开|2929机器学习三大范式再定义:监督、无监督、强化-机器学习算法原子解构-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开|3030第四章 机器学习原理raw.githubusercontent.com前往参考资料 ↓在新标签页中打开
在强化学习中,智能体可被形式化为一个从环境交互中获得的状态观测到动作的映射函数,这一函数称为策略(policy);给定一组观测(即状态),策略决定采取哪种行动。2828探索自主智能技术 - Traininglearn.microsoft.com前往参考资料 ↓在新标签页中打开
与监督学习和无监督学习依赖静态数据集不同,强化学习处理来自动态环境的数据,其反馈往往是延迟且稀疏的奖励信号(例如成功送达得正奖励、撞墙得负奖励),智能体必须通过试错学习长期策略以最大化累积奖励。2828探索自主智能技术 - Traininglearn.microsoft.com前往参考资料 ↓在新标签页中打开|2929机器学习三大范式再定义:监督、无监督、强化-机器学习算法原子解构-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
有工程视角的论述主张,监督、无监督、强化三大范式的根本区别不在于「有没有标签」,而在于系统与环境的交互协议(Interaction Contract),并建议从数据流、反馈信号、目标函数与失败模式四个维度来区分范式。2929机器学习三大范式再定义:监督、无监督、强化-机器学习算法原子解构-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
半监督与自监督学习
半监督学习与自监督学习共享同一个现实前提:可获取的数据量很大,但人工标注成本高、标签稀缺,因此两者都试图从无标签数据中挖掘信息;区别在于半监督学习仍需要少量真实标签,并把无标签数据与标签数据联合优化以提升特定任务的预测性能,而自监督学习完全不需要人工标签,通过构造前置任务(pretext task)从数据本身生成伪监督信号,目标是学到通用特征表示。3131人工智能之核心基础 机器学习 第十四章 半监督与自监督学习总结归纳-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
在输出形态上,半监督学习通常直接产出一个可用于分类或回归的模型,而自监督学习的典型产物是一个特征提取器,需要在下游任务上微调后才能使用;因此工程实践中常见的组合方式是先用自监督在海量无标签数据上预训练得到通用特征提取器,再用半监督方法在少量标签数据上微调,形成高性能的下游模型。3131人工智能之核心基础 机器学习 第十四章 半监督与自监督学习总结归纳-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
半监督学习与自监督学习都依赖数据的内在结构假设,例如样本的聚类性与流形性,即相似样本在表示空间中应当彼此接近、高维数据近似分布在一个低维流形上;这类假设是二者能够利用无标签数据的基本依据。3131人工智能之核心基础 机器学习 第十四章 半监督与自监督学习总结归纳-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
典型算法
线性模型与逻辑回归
线性模型是一类以输入特征的线性组合作为预测基础的模型:给定特征 x1…xn 与对应权重 w1…wn,模型先计算加权和再加上偏置项 b,得到预测值 y′ = b + w1x1 + w2x2 + … + wnxn。Google 的机器学习词汇表以 b=7、w1=-2.5、w2=-1.2、w3=1.4、x1=4、x2=-10、x3=5 为例,算出 y′=16。3232機器學習詞彙表:機器學習基礎知識 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开
线性回归是线性模型用于回归任务的形态:它借助数理统计中的回归分析,确定两种或两种以上变量之间相互依赖的定量关系,输出连续数值,常见应用场景包括异常指标监控、农业贷款预测等。3434机器学习PAI平台简单实现的笔记developer.aliyun.com前往参考资料 ↓在新标签页中打开
逻辑回归(Logistic Regression,LR)是在线性回归基础上加入非线性变换(如 sigmoid 函数)的广义线性模型,其输出被映射为离散取值,因此主要承担分类任务,典型应用包括学生考试成绩预测、雾霾天气预测等。3434机器学习PAI平台简单实现的笔记developer.aliyun.com前往参考资料 ↓在新标签页中打开
在判别式模型的谱系中,线性回归、逻辑斯谛回归与支持向量机常被并列介绍:三者都属于判别模型,区别在于线性回归输出连续值、逻辑回归输出类别概率并用于分类、支持向量机则以间隔最大化为准则做分类。3333机器学习常见算法在建模中的对比-电子制作2018年20期-知网阅读read.cnki.net前往参考资料 ↓在新标签页中打开
逻辑回归原生用于二分类,但可通过策略扩展到多分类:一对多法(one-vs-rest)为每个类别训练一个「该类对其余类」的二分类器,预测时取输出最大的类别;一对一法(one-vs-one)对 K 个类别两两组合训练 K(K-1)/2 个二分类器,预测时以得票最多者为准;此外还可用 softmax 函数直接做多分类归一化。3434机器学习PAI平台简单实现的笔记developer.aliyun.com前往参考资料 ↓在新标签页中打开
决策树与集成方法
决策树是一种以树形结构表示分类或回归规则的监督学习模型:内部节点按某个特征做测试,分支对应测试结果,叶节点给出预测值;从根到叶的一条路径即一条合取规则,因此模型本身可被直接阅读和解释。3535Decision tree learningen.wikipedia.org前往参考资料 ↓在新标签页中打开|3636Decision Treesscikit-learn.org前往参考资料 ↓在新标签页中打开
经典决策树归纳算法包括 ID3、C4.5 与 CART:ID3 以信息增益为分裂准则且只处理离散特征,C4.5 改用信息增益率以缓解偏向多值特征的缺陷并支持连续特征与缺失值,CART 则用基尼指数构建二叉树,可同时用于分类与回归。3535Decision tree learningen.wikipedia.org前往参考资料 ↓在新标签页中打开|3636Decision Treesscikit-learn.org前往参考资料 ↓在新标签页中打开|1818Induction of Decision Treeslink.springer.com前往参考资料 ↓在新标签页中打开
决策树生长时若不加约束会不断分裂直至叶节点纯净,从而对训练数据过拟合;实践中通过预剪枝(限制最大深度、最小叶样本数、最小分裂增益)与后剪枝(如代价复杂度剪枝)控制树规模,剪枝是决策树泛化能力的关键环节。3535Decision tree learningen.wikipedia.org前往参考资料 ↓在新标签页中打开|3636Decision Treesscikit-learn.org前往参考资料 ↓在新标签页中打开
单棵决策树方差大、对训练数据扰动敏感,这一不稳定性是集成方法在树模型上特别有效的原因之一:Breiman 提出的 Bagging 通过对训练集有放回重采样训练多棵树再投票或平均,主要降低方差。3737Bagging predictorslink.springer.com前往参考资料 ↓在新标签页中打开|3838Random Forestslink.springer.com前往参考资料 ↓在新标签页中打开
随机森林由 Breiman 于 2001 年正式提出,它在 Bagging 的基础上进一步在每次节点分裂时只从随机抽取的特征子集中选择最优分裂,从而降低树之间的相关性;其泛化误差可用袋外样本估计,并随森林中树的数量增加而收敛。3838Random Forestslink.springer.com前往参考资料 ↓在新标签页中打开|3939Random Forestsscikit-learn.org前往参考资料 ↓在新标签页中打开
提升(boosting)方法按序列训练弱学习器,每一轮更关注前一轮被错分的样本,最终加权组合;AdaBoost 由 Freund 与 Schapire 提出,是这一思路的代表性算法,并在理论上给出了训练误差随轮数指数下降的保证。4040A Decision-Theoretic Generalization of On-Line Learning and an Application to Boostingsciencedirect.com前往参考资料 ↓在新标签页中打开|4141Boosting (machine learning)en.wikipedia.org前往参考资料 ↓在新标签页中打开
梯度提升(Gradient Boosting)把提升视为在函数空间中的梯度下降:每一轮拟合当前模型损失函数的负梯度(对平方损失即残差),再以学习率收缩每棵树的贡献;Friedman 的论文奠定了这一框架,并给出 TreeBoost 等具体形式。4242Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开
XGBoost 在梯度提升框架上引入对目标函数的二阶泰勒展开、显式的正则化项(叶数与叶权重的惩罚)、列采样与加权分位数草图分裂点搜索,并以稀疏感知方式处理缺失值;Chen 与 Guestrin 的论文报告其在多个基准上以更少资源取得优于既有方案的精度。4343XGBoost: A Scalable Tree Boosting Systemarxiv.org前往参考资料 ↓在新标签页中打开
LightGBM 采用基于直方图的分裂点查找与带深度限制的叶子生长(leaf-wise)策略,并引入单边梯度采样(GOSS)与互斥特征捆绑(EFB)以降低训练开销;其作者报告在大规模数据上训练速度显著快于当时的梯度提升实现,同时保持相近精度。4444LightGBM: A Highly Efficient Gradient Boosting Decision Treepapers.nips.cc前往参考资料 ↓在新标签页中打开
CatBoost 针对梯度提升中的目标泄漏(预测偏移)问题提出有序提升(ordered boosting),并对类别特征采用有序目标统计编码,作者报告其在多个数据集上以较少调参即可取得有竞争力的结果。4545CatBoost: unbiased boosting with categorical featuresarxiv.org前往参考资料 ↓在新标签页中打开
在表格型数据的实证比较中,梯度提升树类模型(如 XGBoost、LightGBM、CatBoost)常被报告为整体表现最强的通用方法之一;Grinsztajn 等人的基准研究进一步指出,在中等规模表格数据上,树基模型优于当时评测的神经网络,原因与数据的不规则性和无旋转不变性有关。4646Why do tree-based models still outperform deep learning on typical tabular data?arxiv.org前往参考资料 ↓在新标签页中打开|4747Benchmarking and Optimization of Gradient Boosting Decision Tree Algorithmsarxiv.org前往参考资料 ↓在新标签页中打开
树集成模型的特征重要性可通过不纯度减少(如基尼重要性)或置换重要性估计,前者在特征尺度或类别数不同时存在偏差,后者在相关特征之间会分摊重要性;因此基于树集成的特征重要性应谨慎解读,不能直接当作因果效应。4848Beware Default Random Forest Importancesexplained.ai前往参考资料 ↓在新标签页中打开|4949Permutation feature importancescikit-learn.org前往参考资料 ↓在新标签页中打开
梯度提升树在训练中持续拟合残差或梯度,若轮数过多会逐渐记忆训练数据中的噪声,因此需要早停、学习率与树复杂度联合调参;这一过拟合风险是提升类方法相对 Bagging 类方法更依赖正则与验证的原因。4242Greedy Function Approximation: A Gradient Boosting Machineprojecteuclid.org前往参考资料 ↓在新标签页中打开|4343XGBoost: A Scalable Tree Boosting Systemarxiv.org前往参考资料 ↓在新标签页中打开
关于随机森林与梯度提升树孰优孰劣,文献中并无统一定论:随机森林调参少、对噪声与过拟合更稳健,梯度提升树在调参得当时通常精度更高但更易受超参数与数据噪声影响;二者的相对表现依数据集与调参预算而变。4646Why do tree-based models still outperform deep learning on typical tabular data?arxiv.org前往参考资料 ↓在新标签页中打开|5050The Elements of Statistical Learning (2nd ed.), Ch. 15: Random Forestshastie.su.domains前往参考资料 ↓在新标签页中打开
支持向量机
支持向量机(Support Vector Machine, SVM)是一类基于监督学习的模式识别模型,其基本思想是构造一个线性输入单元,把样本映射到特征空间后寻找一个能把两类样本分开的判别边界,从而形成二类分类器。5151Table 2 Brief schema of the machine learning methods applied in this study. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
支持向量机的核心是间隔最大化:在能把训练样本正确分开的众多超平面中,选取使两类样本到超平面最小距离(间隔)最大的那一个,落在间隔边界上的样本即所谓支持向量,最终判别函数只由这些支持向量决定。5151Table 2 Brief schema of the machine learning methods applied in this study. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
对线性不可分的数据,支持向量机通过核技巧(kernel trick)隐式地把样本映射到高维特征空间,在那里构造线性判别边界,从而在不显式计算高维坐标的情况下实现非线性分类;常用核包括多项式核、径向基(RBF)核与 Sigmoid 核。5151Table 2 Brief schema of the machine learning methods applied in this study. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
支持向量机的计算量与样本数量的平方成正比,因此当训练样本规模很大时计算开销显著,这是该方法在数据量急剧增长场景下的主要限制之一。5151Table 2 Brief schema of the machine learning methods applied in this study. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
在乳腺癌诊断等医学分类任务的对比实验中,支持向量机与逻辑回归、决策树被放在同一基准上比较训练集与测试集得分、标准差和计算时间,结果显示模型复杂度并不必然带来更好的泛化表现,简单线性模型在部分指标上可与更复杂的模型相当甚至更优。5252The Power of Simplicity: Why Simple Linear Models Outperform Complex Machine Learning Techniques - Case of Breast Cancer Diagnosisar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
k近邻
k近邻(k-Nearest Neighbors,简称 kNN)是一种基于实例的学习方法:它不显式训练参数化模型,而是把训练样本原样保存,预测时在特征空间中找出与查询样本距离最近的 k 个训练样本,再按这些邻居的标签做多数投票(分类)或取均值(回归)。5050The Elements of Statistical Learning (2nd ed.), Ch. 15: Random Forestshastie.su.domains前往参考资料 ↓在新标签页中打开|5353Pattern Recognition and Machine Learning, Chapter 2link.springer.com前往参考资料 ↓在新标签页中打开
kNN 最早由 Cover 与 Hart 在 1967 年的论文《Nearest Neighbor Pattern Classification》中系统分析;该文证明,当样本量趋于无穷时,最近邻规则的渐近错误率不超过贝叶斯最优错误率的两倍,这一结果通常被称为最近邻规则错误率的上界。5454Nearest Neighbor Pattern Classificationieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
kNN 的决策完全由距离度量决定,常用的有欧氏距离、曼哈顿距离和闵可夫斯基距离;对高维或尺度差异大的特征,通常需要先做标准化,否则量纲大的特征会主导距离计算。5050The Elements of Statistical Learning (2nd ed.), Ch. 15: Random Forestshastie.su.domains前往参考资料 ↓在新标签页中打开|5353Pattern Recognition and Machine Learning, Chapter 2link.springer.com前往参考资料 ↓在新标签页中打开
k 的取值对 kNN 的偏差—方差权衡影响显著:k 过小(如 k=1)时模型方差大、对噪声敏感,容易过拟合;k 过大时决策边界过于平滑、偏差增大,可能欠拟合。实践中常通过交叉验证选择 k,并多取奇数以避免二分类投票平票。5050The Elements of Statistical Learning (2nd ed.), Ch. 15: Random Forestshastie.su.domains前往参考资料 ↓在新标签页中打开|5353Pattern Recognition and Machine Learning, Chapter 2link.springer.com前往参考资料 ↓在新标签页中打开
kNN 属于“懒惰学习”(lazy learning):训练阶段几乎不计算,主要开销推迟到预测阶段,每次查询都要与全部(或经索引筛选后的部分)训练样本计算距离,因此在大规模数据集上预测延迟较高。5050The Elements of Statistical Learning (2nd ed.), Ch. 15: Random Forestshastie.su.domains前往参考资料 ↓在新标签页中打开|5353Pattern Recognition and Machine Learning, Chapter 2link.springer.com前往参考资料 ↓在新标签页中打开
为加速最近邻检索,实践中常用 KD 树、球树等空间划分结构,以及近似最近邻(ANN)方法如局部敏感哈希(LSH);但这些结构在维度较高时效果会明显退化,即所谓“维度灾难”。5050The Elements of Statistical Learning (2nd ed.), Ch. 15: Random Forestshastie.su.domains前往参考资料 ↓在新标签页中打开|5555Locality-Sensitive Hashing Scheme Based on p-Stable Distributionsdl.acm.org前往参考资料 ↓在新标签页中打开
神经网络与深度学习
人工神经网络是一类受生物神经系统启发的计算模型,由多层相互连接的人工神经元(节点)组成,每个连接带有可学习的权重,节点对输入的加权和施加非线性激活函数后输出到下一层。5757Deep learningnature.com前往参考资料 ↓在新标签页中打开
深度学习指使用含多个隐藏层(通常不止一层)的深层神经网络进行表示学习的方法族;其核心思想是通过多层非线性变换自动从原始数据中逐层抽取由低到高的抽象特征,从而减少对手工特征工程的依赖。5757Deep learningnature.com前往参考资料 ↓在新标签页中打开|5858Deep Learning (Adaptive Computation and Machine Learning series)deeplearningbook.org前往参考资料 ↓在新标签页中打开
反向传播算法(backpropagation)是训练神经网络的核心方法:它利用链式法则从输出层向输入层逐层计算损失函数对各参数的梯度,再配合梯度下降类优化器更新权重。Rumelhart、Hinton 与 Williams 在 1986 年发表于《Nature》的论文系统展示了用反向传播让多层神经网络学习内部表示,被广泛视为现代深度学习训练的奠基性工作之一。1212Learning Representations by Back-Propagating Errorsnature.com前往参考资料 ↓在新标签页中打开
卷积神经网络(CNN)通过局部感受野、权重共享和空间池化来利用图像的平移不变性与局部相关性,显著减少参数数量。LeCun 等人 1998 年提出的 LeNet-5 用于手写数字识别,是早期成功落地的卷积网络架构。5959Gradient-based learning applied to document recognitionieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
2012 年 ImageNet 大规模视觉识别挑战赛(ILSVRC)中,Krizhevsky、Sutskever 与 Hinton 提出的 AlexNet 以显著优势夺冠,把 top-5 错误率从上一年最佳约 26% 降到约 15.3%,被普遍视为深度学习在计算机视觉领域全面兴起的标志性事件。6060ImageNet Classification with Deep Convolutional Neural Networkspapers.nips.cc前往参考资料 ↓在新标签页中打开
循环神经网络(RNN)通过沿时间步共享参数并维护隐状态来处理变长序列,但标准 RNN 在长序列上存在梯度消失/爆炸问题;长短期记忆网络(LSTM)引入门控与细胞状态以缓解该问题,Hochreiter 与 Schmidhuber 1997 年的论文给出了其原始形式。6161Long Short-Term Memorydirect.mit.edu前往参考资料 ↓在新标签页中打开
Transformer 架构由 Vaswani 等人于 2017 年提出,完全以自注意力机制替代循环与卷积结构,支持高度并行训练并能建模长距离依赖,成为此后大规模语言模型与多模态模型的主流骨干架构。6262Attention Is All You Needpapers.nips.cc前往参考资料 ↓在新标签页中打开
残差连接(ResNet)由 He 等人于 2016 年提出,通过让网络层学习残差映射并加入恒等捷径,使训练上百层甚至更深的网络成为可能,是深层网络设计中被广泛采用的基础构件。6363Deep Residual Learning for Image Recognitionopenaccess.thecvf.com前往参考资料 ↓在新标签页中打开
深度学习的有效性依赖大规模数据与算力:模型参数量、训练数据规模与计算量在 2010 年代后呈数量级增长,OpenAI 在 2018 年的分析中指出,2012 年以来深度学习训练所用算力约每 3.4 个月翻一番,远快于摩尔定律。6464AI and Computeopenai.com前往参考资料 ↓在新标签页中打开
学习过程与优化
损失函数
在机器学习中,损失函数(loss function)用来度量模型预测值与训练数据中真实目标值之间的差距,即模型误差的大小;训练过程就是通过优化算法迭代调整模型参数,使这个损失函数的值尽可能小。6767Cornell Virtual Workshop > Scientific Machine Learning (SciML) > Multi-Layer Perceptron > Training a neural networkcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开
均方误差(mean squared error, MSE)取预测值与真实值之差的平方的平均值,是回归任务中最常用的损失函数之一。6767Cornell Virtual Workshop > Scientific Machine Learning (SciML) > Multi-Layer Perceptron > Training a neural networkcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开
交叉熵损失(cross-entropy loss)度量预测的类别概率分布与真实分布之间的差异,常用于分类任务,并且会对“高置信度却判错”的预测施加较大惩罚。6767Cornell Virtual Workshop > Scientific Machine Learning (SciML) > Multi-Layer Perceptron > Training a neural networkcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开
合页损失(hinge loss)常用于支持向量机(SVM)一类分类器,它对落在决策边界错误一侧的预测施加惩罚。6767Cornell Virtual Workshop > Scientific Machine Learning (SciML) > Multi-Layer Perceptron > Training a neural networkcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开
梯度下降与反向传播
在神经网络中,边的权重与节点的偏置共同构成一组可调数值参数,训练的本质就是依据数据估计这些参数,使输入到输出的映射发生改变。6868Cornell Virtual Workshop > AI with Deep Learning > Introduction to Deep Learning > Parameters and Trainingcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开
训练通常被表述为一个最优化问题:先指定一个损失函数(也称目标函数),再通过调整参数使其在训练数据上最小化;回归问题常用均方误差,分类问题常用交叉熵。6868Cornell Virtual Workshop > AI with Deep Learning > Introduction to Deep Learning > Parameters and Trainingcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开
参数估计采用迭代方式:每一轮对参数值做修改,使当前参数下的损失总体下降,而不是一次求解出闭式解。6868Cornell Virtual Workshop > AI with Deep Learning > Introduction to Deep Learning > Parameters and Trainingcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开
反向传播是训练神经网络时计算梯度的核心机制:它利用链式法则,把损失对输出的误差信号从输出层逐层回传,从而得到损失对每一层权重与偏置的偏导数。6868Cornell Virtual Workshop > AI with Deep Learning > Introduction to Deep Learning > Parameters and Trainingcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开
正则化与泛化
正则化指在经验风险最小化的目标上加入对模型复杂度的惩罚项,使学习算法偏向更简单的假设,从而抑制过拟合。其一般形式可写为最小化「训练损失 + λ·复杂度惩罚」,λ 控制两者权衡。6969Deep Learning (Chapter 7: Regularization for Deep Learning)deeplearningbook.org前往参考资料 ↓在新标签页中打开|5050The Elements of Statistical Learning (2nd ed.), Ch. 15: Random Forestshastie.su.domains前往参考资料 ↓在新标签页中打开
L2 正则化(权重衰减)在目标函数中加入权重向量的平方范数,等价于对权重施加高斯先验下的最大后验估计;它使解偏向权重整体偏小、分布更平滑的方向,是岭回归与多数神经网络训练中的默认正则手段之一。6969Deep Learning (Chapter 7: Regularization for Deep Learning)deeplearningbook.org前往参考资料 ↓在新标签页中打开|7070Regularization and variable selection via the elastic netdoi.org前往参考资料 ↓在新标签页中打开
L1 正则化在目标中加入权重绝对值之和,倾向于产生稀疏解,即把部分权重压到恰好为零,因而常被用作特征选择手段(如 Lasso)。6969Deep Learning (Chapter 7: Regularization for Deep Learning)deeplearningbook.org前往参考资料 ↓在新标签页中打开|7070Regularization and variable selection via the elastic netdoi.org前往参考资料 ↓在新标签页中打开
弹性网络(elastic net)把 L1 与 L2 惩罚线性组合,在特征高度相关时比纯 Lasso 更稳定,同时保留一定的稀疏性。7070Regularization and variable selection via the elastic netdoi.org前往参考资料 ↓在新标签页中打开
Dropout 在训练时以一定概率随机将神经元输出置零,可被视为一种对指数多个子网络进行隐式集成的近似,是深度学习中广泛使用的正则化手段。7171Dropout: A Simple Way to Prevent Neural Networks from Overfittingjmlr.org前往参考资料 ↓在新标签页中打开
早停(early stopping)在验证集误差开始上升时终止训练,是一种隐式的正则化:它限制参数从初始化点出发的移动距离,效果与 L2 正则化有相似之处。6969Deep Learning (Chapter 7: Regularization for Deep Learning)deeplearningbook.org前往参考资料 ↓在新标签页中打开|7272Early Stopping — But When?doi.org前往参考资料 ↓在新标签页中打开
数据增强通过对训练样本施加保持标签不变的变换(如图像的翻转、裁剪、颜色扰动)扩充有效训练分布,被视为一种不改变模型结构的正则化形式。7373A survey on Image Data Augmentation for Deep Learningjournalofbigdata.springeropen.com前往参考资料 ↓在新标签页中打开
批归一化(batch normalization)通过在小批量上对激活做标准化来稳定和加速训练;原论文指出其允许使用更高的学习率并降低对初始化的敏感度,实践中也常被认为带来一定的正则化效果。7474Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shiftarxiv.org前往参考资料 ↓在新标签页中打开
泛化指模型在未参与训练的分布内数据上的表现;泛化误差通常被分解为偏差、方差与不可约噪声三部分,正则化通过牺牲部分偏差来换取方差下降,从而降低总体期望误差。6969Deep Learning (Chapter 7: Regularization for Deep Learning)deeplearningbook.org前往参考资料 ↓在新标签页中打开|5050The Elements of Statistical Learning (2nd ed.), Ch. 15: Random Forestshastie.su.domains前往参考资料 ↓在新标签页中打开
经典统计学习理论用假设空间复杂度(如 VC 维、Rademacher 复杂度)给出泛化误差上界,认为容量过大导致过拟合;但这一框架难以解释现代过参数化深度网络在训练误差为零时仍能良好泛化的现象。6666Understanding deep learning requires rethinking generalizationarxiv.org前往参考资料 ↓在新标签页中打开|7575Reconciling modern machine learning practice and the classical bias-variance trade-offpnas.org前往参考资料 ↓在新标签页中打开
「双下降」现象表明:随着模型容量增大,测试误差先按经典 U 形曲线下降后上升,但在插值阈值附近再次上升后会转入下降,即过参数化区域反而可能获得更低的测试误差。7575Reconciling modern machine learning practice and the classical bias-variance trade-offpnas.org前往参考资料 ↓在新标签页中打开|7676Deep Double Descent: Where Bigger Models and More Data Hurtarxiv.org前往参考资料 ↓在新标签页中打开
关于深度网络为何能泛化,学界存在不同解释路径:一种强调隐式正则化(如随机梯度下降的偏好、平坦极小值),另一种强调显式正则化与数据分布的作用;这些解释之间尚未形成统一结论。6666Understanding deep learning requires rethinking generalizationarxiv.org前往参考资料 ↓在新标签页中打开|7777Implicit Regularization in Deep Learningarxiv.org前往参考资料 ↓在新标签页中打开
数据与特征
训练集、验证集与测试集
在传统机器学习中,训练集、验证集与测试集通常由同一份原始数据集按比例切分而来:训练集用于拟合模型参数,验证集用于调整超参数与选择模型,测试集只在最后用于评估训练完成的模型。7979資料集:分割原始資料集 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开|8080準備資料以建置模型 - ML.NETlearn.microsoft.com前往参考资料 ↓在新标签页中打开
Google 的机器学习速成课程指出,只把数据分成训练集与测试集两部分(例如约 80% 训练、20% 测试)并非最佳分配比例,因为缺少独立的验证集会使超参数与特征选择过程直接接触到测试集。7979資料集:分割原始資料集 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开
如果反复用同一个测试集的结果来指导超参数和特征集的更新,模型会隐式地拟合测试集的特性;使用同一测试集的次数越多,模型与测试集贴合得越紧,从而削弱其对真实新数据的泛化能力。7979資料集:分割原始資料集 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开
ML.NET 文档把训练集与测试集的划分作为识别和缓解过拟合与欠拟合的手段:过拟合表现为训练损失低而测试集上的损失或评分变差,欠拟合则表现为训练期间损失就很高、测试集指标同样偏低。8080準備資料以建置模型 - ML.NETlearn.microsoft.com前往参考资料 ↓在新标签页中打开
特征工程
特征工程指从原始数据出发构造、变换与筛选出可供模型使用的输入变量的过程,其产物是特征矩阵;在自动化机器学习(AutoML)语境下,这一过程被称为数据特征化(data featurization),由系统按列类型自动施加相应的变换。8282Data Featurization in Automated Machine Learning - Azure Machine Learninglearn.microsoft.com前往参考资料 ↓在新标签页中打开
数据标注与质量
在机器学习中,数据质量被普遍视为决定模型能力上限的关键因素:训练数据若存在噪声、偏差或标注错误,模型会把这些缺陷当作规律学进去,即所谓「垃圾进,垃圾出」(Garbage In, Garbage Out)。8585别让烂数据毁了你的AI!一份人人能懂的数据集入门与避坑指南-阿里云开发者社区developer.aliyun.com前往参考资料 ↓在新标签页中打开
数据标注是为原始样本赋予监督信号的过程,常见形态包括分类标签、边界框、分割掩码、实体与关系标注、成对偏好比较等;标注质量直接决定监督学习任务中模型可达到的性能水平。8585别让烂数据毁了你的AI!一份人人能懂的数据集入门与避坑指南-阿里云开发者社区developer.aliyun.com前往参考资料 ↓在新标签页中打开
标注一致性(inter-annotator agreement)是衡量标注质量的核心指标之一:让多名标注者对同一批样本独立标注,再计算一致率或 Kappa 类统计量,可以估计标签噪声水平并暴露标注指南中的歧义。8585别让烂数据毁了你的AI!一份人人能懂的数据集入门与避坑指南-阿里云开发者社区developer.aliyun.com前往参考资料 ↓在新标签页中打开
对机器学习从业者的调查显示,数据相关工作(收集、清洗、标注、校验)在真实项目中占据相当大的工作量比例,数据质量问题被从业者列为项目失败或延期的主要来源之一。8484Machine Learning Application Development: Practitioners’ Insightsar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
从业者调查还指出,专门用于数据分析与质量检查的工具在实际开发中使用率偏低,许多团队仍依赖通用脚本与手工检查来保证数据质量。8484Machine Learning Application Development: Practitioners’ Insightsar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
欧盟《人工智能法案》采取基于风险的分级监管思路,对高风险人工智能系统提出包括数据治理、数据质量与代表性在内的严格要求,这使得数据标注与质量控制在合规层面具有了明确的法律意义。8383Machine Learning Practitioners’ Views on Data Quality in Light of EU Regulatory Requirements: A European Online Surveyar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
一项面向欧洲机器学习从业者的在线调查考察了从业者对数据质量的认知与欧盟监管要求之间的契合程度,结果显示实践中的数据质量做法与法规所期待的数据治理要求之间仍存在差距。8383Machine Learning Practitioners’ Views on Data Quality in Light of EU Regulatory Requirements: A European Online Surveyar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
标注质量问题的典型来源包括:标注指南表述含糊导致标注者理解不一致、标注者疲劳与注意力衰减、领域专业知识不足、以及类别边界本身存在主观性(如情感极性、有害内容判定)。8585别让烂数据毁了你的AI!一份人人能懂的数据集入门与避坑指南-阿里云开发者社区developer.aliyun.com前往参考资料 ↓在新标签页中打开
提升标注质量的常见工程手段包括:编写并迭代标注手册、先做小规模试点标注再全量铺开、多人重复标注与仲裁、抽样复核与黄金标准题嵌入、以及对标注者进行培训与反馈。8585别让烂数据毁了你的AI!一份人人能懂的数据集入门与避坑指南-阿里云开发者社区developer.aliyun.com前往参考资料 ↓在新标签页中打开
随着模型规模扩大,人工标注成本成为瓶颈,自动化标注、模型辅助预标注与合成数据被业界视为缓解标注压力的方向,但这些方式本身会引入新的偏差与误差传播风险。8585别让烂数据毁了你的AI!一份人人能懂的数据集入门与避坑指南-阿里云开发者社区developer.aliyun.com前往参考资料 ↓在新标签页中打开
数据质量并不存在脱离任务的绝对标准:同一份数据在一个任务上可能足够干净,在另一个对细粒度或长尾分布敏感的任务上则可能严重不足,因此质量评估需要与具体任务目标和评估指标绑定。8383Machine Learning Practitioners’ Views on Data Quality in Light of EU Regulatory Requirements: A European Online Surveyar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开|8585别让烂数据毁了你的AI!一份人人能懂的数据集入门与避坑指南-阿里云开发者社区developer.aliyun.com前往参考资料 ↓在新标签页中打开
评估与模型选择
分类指标
分类指标用于衡量分类模型在给定数据集上的预测质量,通常由混淆矩阵的四个计数(真正例 TP、假正例 FP、真负例 TN、假负例 FN)派生而来;准确率、精确率、召回率(灵敏度)、特异度、F1 分数等都可以写成这些计数的函数。8686Table 2 Per-class performance metrics for eight ML algorithms. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
准确率(Accuracy)是正确预测样本数占总样本数的比例,即 (TP+TN)/(TP+FP+TN+FN);它在类别分布均衡时直观易读,但在类别严重不平衡时会被多数类主导,从而高估模型对少数类的实际识别能力。8686Table 2 Per-class performance metrics for eight ML algorithms. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
精确率(Precision,又称阳性预测值 PPV)为 TP/(TP+FP),衡量模型判为正例的样本中真正为正例的比例;召回率(Recall,又称灵敏度 Sensitivity)为 TP/(TP+FN),衡量真实正例中被模型找出的比例。两者分别对应“报得准”与“找得全”,通常此消彼长。8686Table 2 Per-class performance metrics for eight ML algorithms. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
特异度(Specificity)为 TN/(TN+FP),衡量真实负例中被正确判为负例的比例;阴性预测值(NPV)为 TN/(TN+FN),衡量模型判为负例的样本中真正为负例的比例。在医学筛查等场景中,特异度与 NPV 常与灵敏度、PPV 并列报告。8686Table 2 Per-class performance metrics for eight ML algorithms. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
F1 分数是精确率与召回率的调和平均数,即 2·P·R/(P+R);由于调和平均对较小值更敏感,F1 在精确率与召回率任一偏低时都会显著下降,因此常被用作不平衡分类任务中兼顾两者的单一汇总指标。8686Table 2 Per-class performance metrics for eight ML algorithms. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
在二分类模型评估中,同一模型在不同判定阈值下会得到不同的精确率、召回率与 F1,因此报告这些指标时必须同时说明所用阈值(cutoff);跨模型比较若阈值不一致,指标数值不可直接对比。8787Table 5 Performance metrics of machine learning models in the validation set. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
ROC 曲线以假正例率(FPR=FP/(FP+TN))为横轴、真正例率(TPR=TP/(TP+FN))为纵轴,描绘阈值从高到低移动时两者的权衡轨迹;ROC 曲线下面积(AUC)可解释为随机抽取一个正例与一个负例时,模型给正例打分高于负例的概率,取值 0.5 相当于随机猜测、1.0 为完美排序。8787Table 5 Performance metrics of machine learning models in the validation set. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
AUC 只依赖模型输出的排序而不依赖具体阈值,因而适合在阈值尚未确定时比较模型的整体判别能力;但它对类别不平衡不敏感,在正例极少的场景下高 AUC 未必对应可用的精确率与召回率,此时精确率-召回率曲线(PR 曲线)及其下面积更能反映实际表现。8787Table 5 Performance metrics of machine learning models in the validation set. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
Cohen's kappa 系数衡量模型预测与真实标签之间的一致性,并扣除了随机一致所能带来的部分,取值通常在 0 到 1 之间(0 表示与随机猜测相当,1 表示完全一致);它常与准确率一同报告,用于说明模型表现超出偶然水平的程度。8787Table 5 Performance metrics of machine learning models in the validation set. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
多分类任务中,精确率、召回率与 F1 通常按类别分别计算(宏平均对各类等权、微平均按样本数加权、加权平均按各类支持度加权),单看总体准确率会掩盖少数类上的严重失败;按类报告指标是识别这种失败的必要做法。8686Table 2 Per-class performance metrics for eight ML algorithms. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
回归指标
回归任务的评估指标用于量化模型预测的连续值与真实值之间的偏离程度,常见指标包括均方误差(MSE)、均方根误差(RMSE)、平均绝对误差(MAE)、平均相对偏差百分比(MRD%)以及决定系数(R²)。在已发表的回归建模研究中,这些指标通常并列报告,以从绝对误差、相对误差和解释方差等不同角度刻画模型表现。8888Table 1 Metrics for evaluating ML models: analysis of model effectiveness across training, validation, and testing phases.nature.com前往参考资料 ↓在新标签页中打开|8989Table 2 Summary of Statistical Performance Metrics for the Developed Models Across Training, Validation, and Test Datasets.nature.com前往参考资料 ↓在新标签页中打开
均方误差(MSE)是预测误差平方的平均值,对大误差给予更高权重;均方根误差(RMSE)是 MSE 的平方根,量纲与目标变量一致,因而更便于解释。在回归模型对比表中,MSE 与 RMSE 常同时出现,例如某研究在测试集上报告线性回归的 MSE 为 55.9884、RMSE 为 7.4825,而梯度提升的 MSE 为 2.9378、RMSE 为 1.714。8989Table 2 Summary of Statistical Performance Metrics for the Developed Models Across Training, Validation, and Test Datasets.nature.com前往参考资料 ↓在新标签页中打开
平均绝对误差(MAE)是预测误差绝对值的平均,相比 MSE 对异常值不那么敏感;在回归评估中常与 RMSE 并列报告,以反映误差的典型幅度。例如某研究在测试集上报告线性回归的 MAE 为 5.4852,随机森林的 MAE 为 1.252。8989Table 2 Summary of Statistical Performance Metrics for the Developed Models Across Training, Validation, and Test Datasets.nature.com前往参考资料 ↓在新标签页中打开
决定系数 R² 衡量模型解释的目标变量方差比例,取值上限为 1,越接近 1 表示拟合越好;在回归模型评估中,R² 常分别在训练集、验证集和测试集上报告,以观察过拟合或泛化差异。例如某研究显示决策树在训练集上 R² 为 1.0000,而在验证集和测试集上分别降至 0.7578 和 0.8659。8888Table 1 Metrics for evaluating ML models: analysis of model effectiveness across training, validation, and testing phases.nature.com前往参考资料 ↓在新标签页中打开
平均相对偏差百分比(MRD%)以百分比形式表达预测值相对真实值的平均偏离程度,便于跨不同量纲的数据集比较误差大小;在回归评估表中,MRD% 常与 MSE、R² 并列,作为相对误差的汇总指标。8888Table 1 Metrics for evaluating ML models: analysis of model effectiveness across training, validation, and testing phases.nature.com前往参考资料 ↓在新标签页中打开|8989Table 2 Summary of Statistical Performance Metrics for the Developed Models Across Training, Validation, and Test Datasets.nature.com前往参考资料 ↓在新标签页中打开
回归指标需在训练集、验证集和测试集上分别计算并对比,以评估模型的泛化能力与过拟合程度;仅报告训练集指标可能掩盖模型在新数据上的性能下降。已发表的回归研究普遍采用这种分阶段报告方式。8888Table 1 Metrics for evaluating ML models: analysis of model effectiveness across training, validation, and testing phases.nature.com前往参考资料 ↓在新标签页中打开|8989Table 2 Summary of Statistical Performance Metrics for the Developed Models Across Training, Validation, and Test Datasets.nature.com前往参考资料 ↓在新标签页中打开
不同回归指标对同一模型的评价可能给出不一致的排序:例如某研究中梯度提升在测试集上的 R² 为 0.9578、MSE 为 0.0021,表现优于随机森林(R²=0.9221、MSE=0.0038),但其测试集 MRD% 高达 348.03,远高于随机森林的 25.49,说明相对误差指标可能揭示绝对误差指标未反映的偏差问题。8888Table 1 Metrics for evaluating ML models: analysis of model effectiveness across training, validation, and testing phases.nature.com前往参考资料 ↓在新标签页中打开
在回归模型选择中,通常需要综合多个指标而非依赖单一指标:MSE/RMSE 关注大误差,MAE 关注典型误差幅度,R² 关注解释方差比例,MRD% 关注相对偏差;不同指标的组合能更全面地反映模型在不同误差分布下的表现。8888Table 1 Metrics for evaluating ML models: analysis of model effectiveness across training, validation, and testing phases.nature.com前往参考资料 ↓在新标签页中打开|8989Table 2 Summary of Statistical Performance Metrics for the Developed Models Across Training, Validation, and Test Datasets.nature.com前往参考资料 ↓在新标签页中打开
交叉验证
交叉验证是一种重采样评估方法:把数据集划分为若干折,轮流以其中一折作验证集、其余折作训练集,重复训练与评估后对结果取平均,从而得到比单次留出法更稳定的泛化性能估计。9191第2章: 模型评估与选择 / Model Evaluation and Selectionraw.githubusercontent.com前往参考资料 ↓在新标签页中打开
k 折交叉验证把数据集 D 分成 k 个大小相近的互斥子集,每次用 k−1 个子集的并集训练、剩下一个子集验证,共进行 k 次训练与测试,最终返回 k 次测试结果的均值;k 的常用取值为 5 或 10。9191第2章: 模型评估与选择 / Model Evaluation and Selectionraw.githubusercontent.com前往参考资料 ↓在新标签页中打开
留一法(Leave-One-Out,LOO)是 k 折交叉验证在 k 等于样本数 m 时的特例:每次只留一个样本作验证集,其余全部用于训练。其评估结果通常被认为最接近在全体数据上训练所得模型的真实泛化表现,但需要训练 m 个模型,计算开销极大,样本量大时往往不可行。9191第2章: 模型评估与选择 / Model Evaluation and Selectionraw.githubusercontent.com前往参考资料 ↓在新标签页中打开
交叉验证与留出法各有取舍:留出法实现简单,但单次划分的结果受划分方式影响、不够稳定;k 折交叉验证对数据的利用更充分、方差更小,代价是需要重复训练 k 次,计算量随 k 增大而上升。9191第2章: 模型评估与选择 / Model Evaluation and Selectionraw.githubusercontent.com前往参考资料 ↓在新标签页中打开
在规范的模型选择流程中,交叉验证应只在训练集内部进行,用于超参数调优与模型选择;最终的性能估计必须在从未参与过任何训练或选择的独立测试集上完成,否则测试集信息会泄漏进模型选择过程,导致评估结果偏乐观。9090scikit-learn 邮件列表讨论:模型选择与训练/验证/测试划分mail.python.org前往参考资料 ↓在新标签页中打开|9191第2章: 模型评估与选择 / Model Evaluation and Selectionraw.githubusercontent.com前往参考资料 ↓在新标签页中打开
数据划分通常采用训练集、验证集、测试集三层结构:训练集用于拟合模型参数,验证集(实践中常由训练集上的交叉验证代替)用于超参数调优和模型选择,测试集仅用于最终评估一次。9090scikit-learn 邮件列表讨论:模型选择与训练/验证/测试划分mail.python.org前往参考资料 ↓在新标签页中打开|9191第2章: 模型评估与选择 / Model Evaluation and Selectionraw.githubusercontent.com前往参考资料 ↓在新标签页中打开
过拟合与欠拟合
在机器学习中,模型在训练集上的误差称为训练误差或经验误差,在新样本上的误差称为泛化误差;学习的目标是使泛化误差尽可能小,但新样本的分布未知,实际可操作的只有最小化经验误差。9292模型评估与选择raw.githubusercontent.com前往参考资料 ↓在新标签页中打开|9393机器学习》二刷超详细笔记| 第二章 模型评估与选择-云社区-华为云bbs.huaweicloud.com前往参考资料 ↓在新标签页中打开
过拟合指学习器把训练样本自身的一些特点当作所有潜在样本都具有的一般性质,因而在训练集上经验误差很小,但泛化性能下降;欠拟合则指学习器对训练样本的一般性质尚未学好,连训练集上的表现都不够好。9292模型评估与选择raw.githubusercontent.com前往参考资料 ↓在新标签页中打开|9191第2章: 模型评估与选择 / Model Evaluation and Selectionraw.githubusercontent.com前往参考资料 ↓在新标签页中打开|9393机器学习》二刷超详细笔记| 第二章 模型评估与选择-云社区-华为云bbs.huaweicloud.com前往参考资料 ↓在新标签页中打开
过拟合与欠拟合的成因方向相反:模型相对于训练数据过于复杂、容量过大时容易过拟合;模型复杂度不足或训练不充分时容易欠拟合。因此缓解过拟合的常见手段是降低模型复杂度或增加训练数据,缓解欠拟合的常见手段是适当提高模型复杂度(例如增加神经网络层数)。9292模型评估与选择raw.githubusercontent.com前往参考资料 ↓在新标签页中打开|9191第2章: 模型评估与选择 / Model Evaluation and Selectionraw.githubusercontent.com前往参考资料 ↓在新标签页中打开
在经典教材的表述中,欠拟合相对容易避免,只要适当增加模型复杂度即可;而过拟合无法彻底避免,只能缓解,这被视为机器学习发展中的一个关键阻碍。9292模型评估与选择raw.githubusercontent.com前往参考资料 ↓在新标签页中打开
由于经验误差存在过拟合风险,不能直接用作模型评估标准,实践中用测试集上的误差来近似泛化误差;因此需要把数据划分为训练集、验证集与测试集:训练集用于拟合模型,验证集用于超参数调优与模型选择,测试集只用于最终评估。9292模型评估与选择raw.githubusercontent.com前往参考资料 ↓在新标签页中打开|9191第2章: 模型评估与选择 / Model Evaluation and Selectionraw.githubusercontent.com前往参考资料 ↓在新标签页中打开
留出法、k 折交叉验证、留一法与自助法是常用的评估方法,它们在数据利用充分程度与计算开销之间各有取舍:留出法简单但单次划分结果不稳定,k 折交叉验证数据利用更充分但计算量更大,留一法(k 等于样本数)最接近真实分布但开销极大,自助法适合小数据集但会改变数据分布。9191第2章: 模型评估与选择 / Model Evaluation and Selectionraw.githubusercontent.com前往参考资料 ↓在新标签页中打开
应用领域
计算机视觉
图像处理与基于机器学习的视觉方法已成为工业自动化的关键技术,支撑质量控制、机器人操作与过程监控等任务。9494Image Processing: a Review on Industrial Applications - Repository of the Academy's Libraryreal.mtak.hu前往参考资料 ↓在新标签页中打开
在工厂现场部署基于深度学习的视觉系统仍面临现实障碍,工业场景对可靠性、实时性与可维护性的要求高于实验室环境,这是该领域综述讨论的核心问题之一。9494Image Processing: a Review on Industrial Applications - Repository of the Academy's Libraryreal.mtak.hu前往参考资料 ↓在新标签页中打开
自然语言处理
自然语言处理是机器学习最活跃的应用领域之一,其核心任务是把文本与语音等语言数据转化为可计算的特征表示,并在此基础上完成分类、预测、序列标注与生成等操作;主流机器学习工具链已为文本与音频数据提供专用处理管道。9595机器学习—Wolfram Documentationreference.wolfram.com前往参考资料 ↓在新标签页中打开
在工程实现层面,自然语言处理任务通常被归入监督学习与无监督学习两类范式:文本分类、情感判定、命名实体识别等属于监督学习,借助标注语料训练分类器;而词聚类、主题发现、文本相似度检索等则依赖聚类与特征提取等无监督方法。9595机器学习—Wolfram Documentationreference.wolfram.com前往参考资料 ↓在新标签页中打开
文本数据在进入机器学习模型前必须经过特征提取,把变长的词序列映射为定长向量;特征提取函数与分类、聚类、预测等函数共同构成自然语言处理流水线的基本构件。9595机器学习—Wolfram Documentationreference.wolfram.com前往参考资料 ↓在新标签页中打开
语音与情感计算
语音情感分析被视为人机交互的一项核心技术,在智能客服、医疗监测等场景中有迫切的应用需求;这一判断在中文语音情感分析的近期系统实现研究中被明确表述。9696计算机与网络publish.cnki.net前往参考资料 ↓在新标签页中打开
在中文语音情感分析中,现有模型对声学特征的挖掘深度不足,分类稳定性与泛化能力有待提升,这在一定程度上制约了技术的实际落地效果。9696计算机与网络publish.cnki.net前往参考资料 ↓在新标签页中打开
面向中文场景的语音情感分析系统常以 CASIA 中文语音数据集为基础,用梅尔频率倒谱系数(MFCC)提取声学特征,并以支持向量机(SVM)作为核心分类器、随机森林作为对比验证模型。9696计算机与网络publish.cnki.net前往参考资料 ↓在新标签页中打开
推荐系统
推荐系统是机器学习在信息过载场景下最典型的应用之一,其核心任务是根据用户历史行为与物品属性,预测用户对未接触物品的偏好,从而完成内容、商品或服务的个性化分发。9797Recommender Systems: An Introductioncambridge.org前往参考资料 ↓在新标签页中打开
协同过滤是推荐系统最早成体系的方法族,分为基于内存的邻域方法与基于模型的矩阵分解方法;矩阵分解通过将用户-物品评分矩阵分解为低维隐向量,显著提升了稀疏数据下的预测精度。9898Matrix Factorization Techniques for Recommender Systemsieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
2009年Netflix Prize竞赛中,BellKor's Pragmatic Chaos团队凭借融合矩阵分解与邻域模型的集成方案获得冠军,将RMSE相对Cinematch基线降低约10%,这一结果推动了隐因子模型在工业界的普及。9999The Netflix Prizenetflixprize.com前往参考资料 ↓在新标签页中打开
基于内容的推荐依赖物品特征与用户画像的匹配,早期多使用TF-IDF等文本特征;深度学习兴起后,双塔模型(two-tower)成为工业界主流的召回架构,用户塔与物品塔分别编码后通过内积或余弦相似度计算匹配分数。100100Sampling-Bias-Corrected Neural Modeling for Large Corpus Item Recommendationsdl.acm.org前往参考资料 ↓在新标签页中打开
工业级推荐系统通常采用“召回—粗排—精排—重排”的多级漏斗架构:召回阶段从百万级候选集中快速筛选数千条,精排阶段用复杂模型对数百条候选精细打分,重排阶段再考虑多样性与业务规则。101101Deep Learning based Recommender System: A Survey and New Perspectivesdl.acm.org前往参考资料 ↓在新标签页中打开
YouTube于2016年公开的深度推荐架构将候选生成与排序分离,排序模型使用深度神经网络融合用户观看历史、视频特征与上下文特征,这一工作成为大规模深度学习推荐系统的代表性工程实践。102102Deep Neural Networks for YouTube Recommendationsdl.acm.org前往参考资料 ↓在新标签页中打开
阿里巴巴提出的Deep Interest Network(DIN)引入注意力机制对用户历史行为进行加权建模,使模型能够根据候选商品动态调整历史行为的贡献权重,在电商场景的CTR预估中取得显著提升。103103Deep Interest Network for Click-Through Rate Predictiondl.acm.org前往参考资料 ↓在新标签页中打开
推荐系统的评估通常分为离线评估与在线A/B测试:离线常用AUC、NDCG、Recall@K等指标,但在线指标(点击率、停留时长、转化率)与离线指标常出现不一致,因此工业界以在线实验为最终判据。104104Evaluating Recommendation Systemslink.springer.com前往参考资料 ↓在新标签页中打开
科学与工程
在科学与工程领域,一个日益增长的共识是:解决复杂科学与工程问题需要能够把传统的基于物理的建模方法与前沿机器学习技术相结合的新方法,而不是单纯用数据驱动模型替代物理模型。107107NSTL国家科技图书文献中心cs.nstl.gov.cn前往参考资料 ↓在新标签页中打开|108108NSTL国家科技图书文献中心gz.nstl.gov.cn前往参考资料 ↓在新标签页中打开
将科学知识与机器学习相融合的研究已形成结构化的方法体系,相关综述按应用中心的方式梳理了工程与环境系统中的这类技术,说明该方向已从零散尝试走向系统化整理。107107NSTL国家科技图书文献中心cs.nstl.gov.cn前往参考资料 ↓在新标签页中打开|108108NSTL国家科技图书文献中心gz.nstl.gov.cn前往参考资料 ↓在新标签页中打开
工具与框架
开源库与平台
scikit-learn 是面向经典机器学习算法的单节点开源库,被广泛用于传统监督与无监督学习任务,并被 Microsoft Fabric 的 Apache Spark 运行时列为随附的机器学习库之一。110110使用 Apache Spark 訓練機器學習模型 - Microsoft Fabriclearn.microsoft.com前往参考资料 ↓在新标签页中打开
Apache Spark 是统一的开放源代码并行数据处理框架,采用内存内处理加速大数据分析,其内存内分布式计算特性适合迭代式机器学习与图算法。110110使用 Apache Spark 訓練機器學習模型 - Microsoft Fabriclearn.microsoft.com前往参考资料 ↓在新标签页中打开
Spark 生态中提供两个可扩展的机器学习库:MLlib 提供基于 RDD 的原始 API,SparkML 则是较新的、基于 DataFrame 的高层 API,用于构建机器学习流水线。110110使用 Apache Spark 訓練機器學習模型 - Microsoft Fabriclearn.microsoft.com前往参考资料 ↓在新标签页中打开
SparkML 尚未支持 MLlib 的全部功能,但官方定位是取代 MLlib 成为 Spark 的标准机器学习库。110110使用 Apache Spark 訓練機器學習模型 - Microsoft Fabriclearn.microsoft.com前往参考资料 ↓在新标签页中打开
SynapseML 是与 Apache Spark MLlib 并列、可在 Microsoft Fabric 中用于训练模型的开源库之一。110110使用 Apache Spark 訓練機器學習模型 - Microsoft Fabriclearn.microsoft.com前往参考资料 ↓在新标签页中打开
云计算与分布式训练
分布式训练并非默认更优:Azure Databricks 的官方文档明确建议尽量在单台计算机上训练神经网络,理由是分布式代码涉及节点间通信开销,实现比单机代码更复杂,且训练与推理速度可能更慢;只有当模型或数据大到无法装入单机内存时,才应考虑分布式训练与推理。111111分布式训练 - Azure Databrickslearn.microsoft.com前往参考资料 ↓在新标签页中打开
在云平台上,分布式训练通常以托管运行时组件的形式提供。Databricks Runtime ML 内置了 TorchDistributor、DeepSpeed 分发服务器和 Ray 三类组件,用于承载需要跨节点扩展的 PyTorch 与强化学习类负载;对 Spark ML 模型则通过 pyspark.ml.connect 模块提供分布式训练能力。111111分布式训练 - Azure Databrickslearn.microsoft.com前往参考资料 ↓在新标签页中打开
DeepSpeed 分发服务器构建在 TorchDistributor 之上,被 Azure Databricks 文档列为「模型需要更高算力但受内存约束」场景的推荐方案;DeepSpeed 本身是微软开源的库,提供优化的内存占用、更低的通信开销以及高级流水线并行能力。111111分布式训练 - Azure Databrickslearn.microsoft.com前往参考资料 ↓在新标签页中打开
云上多节点训练的实际瓶颈常常是节点间网络而非 GPU 算力:Azure Databricks 文档指出,由于节点间网络性能低,不建议使用 NC 系列虚拟机运行多节点分布式训练,而应改用单台多 GPU 节点,或选择支持加速网络的 VM 规格(如 NCasT4_v3 系列)。111111分布式训练 - Azure Databrickslearn.microsoft.com前往参考资料 ↓在新标签页中打开
挑战与争议
可解释性
深度学习的兴起使大量高性能模型成为不透明的“黑箱”:其内部决策过程难以被人类直接理解,这一特性在医疗、金融、刑事司法等高风险场景中引发伦理、信任与监管层面的关切。113113Research Exploration of Artificial Intelligence: The Black Boxieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
可解释人工智能(XAI)领域已发展出 LIME、SHAP 与反事实推理等代表性技术,用以对黑箱模型的决策给出局部或事后解释;这些方法在多大程度上真正解决了不透明性问题,仍是持续评估与争论的对象。113113Research Exploration of Artificial Intelligence: The Black Boxieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
围绕“可解释性是否必要”存在明确的公开争论:一种立场认为,在临床等场景中,使用灵敏度、特异度或精确度低于现有替代方案的模型会带来可避免的发病与死亡风险,因此不应为可解释性而牺牲准确性;另一种立场则强调,降低不透明度可能需要在准确性与可解释性之间做出权衡,并主张可解释性对问责与信任不可替代。114114Table 5.pmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对立说法支持可解释性必要性的一方则认为:准确性与可解释性之间可能存在权衡,降低不透明度会促使采用更可解释的模型,而这对高风险决策的问责与信任是必要的。113113Research Exploration of Artificial Intelligence: The Black Boxieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
数据偏见与公平性
机器学习模型的公平性问题通常被表述为:模型在少数群体或代表性不足的子群上性能更差,其上游成因包括训练数据中的代表性不足、差异化的服务可及性以及测量误差等。115115Paradoxical inflation of prediction model performance measures in minority patient subgroups: the role of upstream biasnature.com前往参考资料 ↓在新标签页中打开
在一项预测术后持续性阿片类药物使用的医疗 AI 模型研究中,研究者观察到一个与常规预期相反的现象:在样本中占比不足 5% 的黑人患者子群上,模型性能反而显著高于白人患者子群。115115Paradoxical inflation of prediction model performance measures in minority patient subgroups: the role of upstream biasnature.com前往参考资料 ↓在新标签页中打开
隐私与安全
机器学习模型被证实会在生成阶段无意记忆并泄露训练数据中的敏感信息,包括个人可识别信息(PII);这一现象已在多个公开报道的事件中得到印证,说明隐私泄露是模型训练与部署中的系统性风险,而非个别实现缺陷。116116Technical and Ethical Strategies to Prevent Machine Learning Models from Exploiting Personally Identifiable Information (PII)ieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
传统的隐私保护手段(如匿名化、去标识化)在面对更先进的 AI 驱动攻击时已被证明不足:攻击者可以借助辅助信息与模型输出进行重识别或成员推断,使仅靠删除姓名等直接标识符的做法无法可靠保护个人数据。116116Technical and Ethical Strategies to Prevent Machine Learning Models from Exploiting Personally Identifiable Information (PII)ieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
对抗样本
对抗样本(adversarial examples)指在输入上施加人眼或人类感知难以察觉的微小扰动后,使机器学习模型给出错误输出的样本;这一现象在图像分类任务上被系统展示后成为机器学习安全研究的核心议题之一。117117Position: Certified Robustness Does Not (Yet) Imply Model Securityar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对抗样本的威胁并不限于分类错误:在自动驾驶感知、人脸识别、恶意软件检测等部署场景中,攻击者可通过精心构造的输入诱导模型做出对攻击者有利的判断,因此它被视为机器学习系统在真实环境中部署时的安全性问题,而不仅是精度问题。117117Position: Certified Robustness Does Not (Yet) Imply Model Securityar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对抗鲁棒性研究大致分为经验鲁棒性与可认证鲁棒性两条路线:前者以对抗训练等手段提升模型在已知攻击下的表现,后者试图对一类扰动给出数学上的保证。可认证鲁棒性被广泛宣传为对抗样本问题的解决方案。117117Position: Certified Robustness Does Not (Yet) Imply Model Securityar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
有立场论文指出,可认证鲁棒性并不(尚不)意味着模型安全:认证所依据的范数与攻击者实际使用的范数可能不一致,从而给实践者带来没有根据的安全感。117117Position: Certified Robustness Does Not (Yet) Imply Model Securityar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
该立场论文还指出当前研究存在若干关键缺口,包括“检测而不区分”(detection without distinction)的悖论、实践者缺乏评估认证方案的明确标准,以及认证方案本身可能引入的安全风险。117117Position: Certified Robustness Does Not (Yet) Imply Model Securityar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对抗样本的迁移性使威胁进一步放大:针对一个模型构造的对抗扰动,往往也能使结构不同、训练数据不同的另一个模型出错,这意味着攻击者无需访问目标模型的参数即可实施攻击,也意味着仅靠隐藏模型细节难以构成有效防御。117117Position: Certified Robustness Does Not (Yet) Imply Model Securityar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
社会影响与治理
伦理与法规
欧盟《通用数据保护条例》(GDPR)第22条赋予数据主体在“仅基于自动化处理(包括画像)”且该处理对其产生法律效力或类似重大影响时,不受此类决定约束的权利,并要求控制者提供人工干预、表达观点和质疑决定的途径。这一条款构成机器学习系统在欧盟境内用于信贷、招聘、保险等高风险决策时的直接法律约束。118118Regulation (EU) 2016/679 (General Data Protection Regulation), Articles 13–15, 17, 22eur-lex.europa.eu前往参考资料 ↓在新标签页中打开
GDPR第13至15条要求数据控制者在收集个人数据时告知数据主体自动化决策的存在、逻辑的有意义信息以及预期后果,这被普遍解读为机器学习模型需要具备一定程度的可解释性,尽管条文本身未使用“可解释性”一词。118118Regulation (EU) 2016/679 (General Data Protection Regulation), Articles 13–15, 17, 22eur-lex.europa.eu前往参考资料 ↓在新标签页中打开
欧盟《人工智能法案》于2024年由欧洲议会和欧盟理事会正式通过(Regulation (EU) 2024/1689),采用基于风险的分级监管框架,将AI系统分为不可接受风险、高风险、有限风险和最小风险四类,并对高风险系统规定风险管理、数据治理、技术文档、透明度、人类监督和准确性鲁棒性等合规义务。119119Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act)eur-lex.europa.eu前往参考资料 ↓在新标签页中打开
欧盟《人工智能法案》对“通用目的人工智能模型”(GPAI)设定了单独的透明度与版权合规义务,并要求对具有系统性风险的模型进行模型评估、对抗性测试和事件报告;该法案的相关义务自2025年起分阶段适用。119119Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act)eur-lex.europa.eu前往参考资料 ↓在新标签页中打开
美国国家标准与技术研究院(NIST)于2023年发布《人工智能风险管理框架》(AI RMF 1.0),提出“治理、映射、测量、管理”四个核心功能,作为自愿性框架供组织在机器学习系统全生命周期中识别、评估和缓解风险。120120Artificial Intelligence Risk Management Framework (AI RMF 1.0), NIST AI 100-1doi.org前往参考资料 ↓在新标签页中打开
NIST AI RMF 强调风险管理应是持续、迭代的过程,并配套发布了生成式人工智能风险管理剖面(AI 600-1),针对生成式模型特有的信息完整性、有害内容、数据隐私和知识产权等风险给出具体行动建议。120120Artificial Intelligence Risk Management Framework (AI RMF 1.0), NIST AI 100-1doi.org前往参考资料 ↓在新标签页中打开|121121Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile, NIST AI 600-1doi.org前往参考资料 ↓在新标签页中打开
经济合作与发展组织(OECD)于2019年通过《人工智能原则》,提出以人为中心、透明可解释、稳健安全、问责等五项原则,成为多国AI政策制定的参考基准,并随后被二十国集团采纳。122122OECD Recommendation of the Council on Artificial Intelligence, OECD/LEGAL/0449legalinstruments.oecd.org前往参考资料 ↓在新标签页中打开
联合国教科文组织(UNESCO)于2021年通过《人工智能伦理建议书》,这是首个由全球多数国家共同通过的AI伦理规范性文件,涵盖教育、科学、文化、传播等领域的伦理原则与政策行动建议。123123Recommendation on the Ethics of Artificial Intelligenceunesdoc.unesco.org前往参考资料 ↓在新标签页中打开
中国于2023年施行《生成式人工智能服务管理暂行办法》,要求提供生成式AI服务应尊重知识产权、不得歧视、不得生成虚假有害信息,并对具有舆论属性或社会动员能力的服务进行安全评估和算法备案。124124生成式人工智能服务管理暂行办法cac.gov.cn前往参考资料 ↓在新标签页中打开
中国《互联网信息服务算法推荐管理规定》自2022年3月1日起施行,要求算法推荐服务提供者向用户提供关闭算法推荐服务的选项,并不得利用算法实施不合理的差别待遇。125125互联网信息服务算法推荐管理规定cac.gov.cn前往参考资料 ↓在新标签页中打开
机器学习模型的公平性度量之间存在数学上的不相容性:在基础率不同的群体间,无法同时满足校准(calibration)与均等化几率(equalized odds)等常用公平性定义,这一不可能性结果由Chouldechova与Kleinberg等人分别独立证明,意味着公平性目标的选择本质上是价值判断而非纯技术问题。126126Fair prediction with disparate impact: A study of bias in recidivism prediction instrumentsarxiv.org前往参考资料 ↓在新标签页中打开|127127Inherent Trade-Offs in the Fair Determination of Risk Scoresarxiv.org前往参考资料 ↓在新标签页中打开
关于机器学习公平性应追求“群体公平”还是“个体公平”,以及是否应通过去除敏感属性来实现“盲视公平”,研究界存在持续争论;有研究指出去除敏感属性并不能消除代理变量带来的歧视,而另一些工作则主张在特定法律语境下盲视仍是必要基线。128128Fairness and Machine Learning: Limitations and Opportunitiesfairmlbook.org前往参考资料 ↓在新标签页中打开|129129The Measure and Mismeasure of Fairness: A Critical Review of Fair Machine Learningarxiv.org前往参考资料 ↓在新标签页中打开
机器学习模型的可解释性要求与模型性能之间存在张力:高复杂度模型(如深度神经网络)通常难以提供忠实的事后解释,而本身可解释的模型(如线性模型、决策树)在部分任务上性能受限;这一权衡在需要监管审计的高风险场景中尤为突出。130130Stop Explaining Black Box Machine Learning Models for High Stakes Decisions and Use Interpretable Models Insteadarxiv.org前往参考资料 ↓在新标签页中打开
关于事后解释方法(如LIME、SHAP)是否“忠实”反映模型真实决策依据,学界存在争论:部分研究指出这些方法在特定条件下不稳定或可被操纵,另一些工作则主张在合理假设下其近似解释具有实用价值。131131The (Im)possibility of Fairness: Different Value Systems Require Different Mechanisms For Fair Decision Makingarxiv.org前往参考资料 ↓在新标签页中打开|132132A Unified Approach to Interpreting Model Predictions (SHAP)arxiv.org前往参考资料 ↓在新标签页中打开
机器学习系统的问责治理面临“多手问题”(many hands problem):模型由数据提供者、标注者、开发者、部署者和用户等多方共同塑造,责任链条分散,使得在损害发生时难以将责任归属到单一主体,现有产品责任与侵权法框架对此应对不足。133133The Many Hands Problem in AI Accountabilityarxiv.org前往参考资料 ↓在新标签页中打开
欧盟《人工智能责任指令》提案(AI Liability Directive)试图通过引入证据披露义务和可反驳的过错推定,减轻受害者在机器学习系统致害案件中的举证负担,但该提案的立法进程在2025年前后出现停滞或撤回讨论。134134Proposal for a Directive on adapting non-contractual civil liability rules to artificial intelligence (AI Liability Directive), COM(2022) 496 finaleur-lex.europa.eu前往参考资料 ↓在新标签页中打开
机器学习模型的训练数据可能包含个人数据,GDPR下的“被遗忘权”(第17条)与模型参数中难以定位和删除特定数据的技术现实之间存在冲突,学界提出机器遗忘(machine unlearning)作为潜在技术回应,但其在大规模模型上的有效性与可验证性仍在研究中。135135Machine Unlearningarxiv.org前往参考资料 ↓在新标签页中打开
就业与经济影响
机器学习与人工智能的引入正在对工作场所产生剧烈改造,其对社会与经济的影响体现在工作的性质与劳动力结构两个层面,而不只是岗位数量的增减。138138Understanding the Societal Impacts of Artificial Intelligence and Machine Learning on Employment and Workforce Dynamicsxplorestaging.ieee.org前往参考资料 ↓在新标签页中打开
世界经济论坛的统计被引用为:机器已承担约 34% 的企业任务;相关研究据此判断,常规性、尤其是信息处理类工作将加速自动化,而创造性与需要共情的工作仍被视为人类相对占优的领域。139139Artificial Intelligence and Machine Learning in Our Everyday Life: Uses, Problems and Futuremrt.greatlakes.edu.in前往参考资料 ↓在新标签页中打开
研究界普遍认为,理解技术与劳动力市场之间的关系需要跨方法的研究框架,把多种探究路径与实验设计整合起来,才能刻画自动化对就业的复杂影响。138138Understanding the Societal Impacts of Artificial Intelligence and Machine Learning on Employment and Workforce Dynamicsxplorestaging.ieee.org前往参考资料 ↓在新标签页中打开
关于机器学习究竟在净量上消灭还是创造就业,公开文献中存在明显分歧:一派强调岗位替代与劳动份额下降,另一派强调生产率提升与新职业生成,双方各有独立来源支撑,尚无一致的经验结论。138138Understanding the Societal Impacts of Artificial Intelligence and Machine Learning on Employment and Workforce Dynamicsxplorestaging.ieee.org前往参考资料 ↓在新标签页中打开
对立说法另一类研究强调,自动化在替代常规任务的同时会通过生产率效应与需求扩张生成新的任务与职业,因而净就业效应未必为负。139139Artificial Intelligence and Machine Learning in Our Everyday Life: Uses, Problems and Futuremrt.greatlakes.edu.in前往参考资料 ↓在新标签页中打开
参考来源
- 1文档 General Machine Learning - Chapters and Articles · ScienceDirect · 2026-01-01 · 核验于 2026-10-21
- 2论文 Table 1 Categories of ML models · Cell Reports Physical Science · 2023-01-01 · 核验于 2026-10-21
- 3文档 机器学习与人工智能 - 课程简介 · 国家高等教育智慧教育平台 · 2021-04-05 · 核验于 2026-10-21
- 4文档 深度学习----科学智慧火花 · 科学智慧火花 · 2023-07-21 · 核验于 2026-10-21
- 5文档 Cornell Virtual Workshop > An Overview of AI > Machine Learning and Deep Learning > Functionality and Implementation · Cornell Virtual Workshop · 2023-01-01 · 核验于 2026-10-21
- 6文档 AI 说(AI Speak):机器学习 – 面向教师的人工智能教程: 一本开放式教科书 · Consiglio Nazionale delle Ricerche (CNR) · 2024-01-17 · 核验于 2026-10-21
- 7文档 AI4K12 邮件列表讨论:传统编程与人工智能的区别 · The Association for the Advancement of Artificial Intelligence · 2019-09-22 · 核验于 2026-10-21
- 8论文 A Logical Calculus of the Ideas Immanent in Nervous Activity · Bulletin of Mathematical Biophysics, 5(4):115–133 · 1943-12-01 · 核验于 2026-10-21
- 9文档 The Organization of Behavior: A Neuropsychological Theory · Wiley · 1949-01-01 · 核验于 2026-10-21
- 10论文 The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain · Psychological Review, 65(6):386–408 · 1958-11-01 · 核验于 2026-10-21
- 11文档 Perceptrons: An Introduction to Computational Geometry · MIT Press · 1969-01-01 · 核验于 2026-10-21
- 12论文 Learning Representations by Back-Propagating Errors · Nature, 323:533–536 · 1986-10-09 · 核验于 2026-10-21
- 13论文 Beyond Regression: New Tools for Prediction and Analysis in the Behavioral Sciences · Harvard University PhD Thesis · 1974-01-01 · 核验于 2026-10-21
- 14文档 A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence · Dartmouth College · 1955-08-31 · 核验于 2026-10-21
- 15文档 Rule-Based Expert Systems: The MYCIN Experiments of the Stanford Heuristic Programming Project · Addison-Wesley · 1984-01-01 · 核验于 2026-10-21
- 16论文 On the Uniform Convergence of Relative Frequencies of Events to Their Probabilities · Theory of Probability & Its Applications, 16(2):264–280 · 1971-01-01 · 核验于 2026-10-21
- 17论文 Support-Vector Networks · Machine Learning, 20:273–297 · 1995-09-01 · 核验于 2026-10-21
- 18论文 Induction of Decision Trees · Machine Learning, 1:81–106 · 1986-03-01 · 核验于 2026-10-21
- 19文档 Probabilistic Reasoning in Intelligent Systems: Networks of Plausible Inference · Morgan Kaufmann · 1988-01-01 · 核验于 2026-10-21
- 20报道 The Third Wave of Artificial Intelligence · Communications of the ACM · 2019-01-01 · 核验于 2026-10-21
- 21论文 Symbolic vs. Statistical AI: A False Dichotomy? · AI Magazine · 2020-06-01 · 核验于 2026-10-21
- 22文档 [科普中国]-无监督训练- · 科普中国网 · 科普中国 · 2021-12-30 · 核验于 2026-10-21
- 23文档 机器学习 · 百度百科 · 2026-04-23 · 核验于 2026-10-21
- 24文档 (图解)类神经网络的复兴:深度学习简史-腾讯云开发者社区-腾讯云 · tencent.cn · 2018-04-01 · 核验于 2026-10-21
- 25文档 图文详情——科普中国资源服务 · 科普中国 · 2019-08-12 · 核验于 2026-10-21
- 26文档 Key Steps Forward · Stanford University · 2019-01-01 · 核验于 2026-10-21
- 27文档 监督学习 - 维基百科,自由的百科全书 · Wikipedia · 2008-07-12 · 核验于 2026-10-21
- 28文档 探索自主智能技术 - Training · Learn Microsoft · 2024-09-23 · 核验于 2026-10-21
- 29文档 机器学习三大范式再定义:监督、无监督、强化-机器学习算法原子解构-腾讯云开发者社区-腾讯云 · tencent.cn · 2026-03-16 · 核验于 2026-10-21
- 30文档 第四章 机器学习原理 · GitHub · 2024-01-01 · 核验于 2026-10-21
- 31文档 人工智能之核心基础 机器学习 第十四章 半监督与自监督学习总结归纳-腾讯云开发者社区-腾讯云 · tencent.cn · 2026-01-14 · 核验于 2026-10-21
- 32文档 機器學習詞彙表:機器學習基礎知識 | Machine Learning | Google for Developers · Google for Developers · 2024-01-01 · 核验于 2026-10-21
- 33文档 机器学习常见算法在建模中的对比-电子制作2018年20期-知网阅读 · CNKI · 2018-10-01 · 核验于 2026-10-21
- 34文档 机器学习PAI平台简单实现的笔记 · 阿里云开发者社区 · 2026-01-11 · 核验于 2026-10-21
- 35文档 Decision tree learning · Wikipedia · 2024-06-01 · 核验于 2026-10-21
- 36文档 Decision Trees · scikit-learn User Guide · 2024-01-01 · 核验于 2026-10-21
- 37论文 Bagging predictors · Machine Learning, 24(2), L. Breiman · 1996-08-01 · 核验于 2026-10-21
- 38论文 Random Forests · Machine Learning, 45(1), L. Breiman · 2001-10-01 · 核验于 2026-10-21
- 39文档 Random Forests · scikit-learn User Guide · 2024-01-01 · 核验于 2026-10-21
- 40论文 A Decision-Theoretic Generalization of On-Line Learning and an Application to Boosting · Journal of Computer and System Sciences, 55(1), Y. Freund, R. E. Schapire · 1997-08-01 · 核验于 2026-10-21
- 41文档 Boosting (machine learning) · Wikipedia · 2024-05-01 · 核验于 2026-10-21
- 42论文 Greedy Function Approximation: A Gradient Boosting Machine · Annals of Statistics, 29(5), J. H. Friedman · 2001-10-01 · 核验于 2026-10-21
- 43论文 XGBoost: A Scalable Tree Boosting System · KDD 2016, T. Chen, C. Guestrin · 2016-03-09 · 核验于 2026-10-21
- 44论文 LightGBM: A Highly Efficient Gradient Boosting Decision Tree · NeurIPS 2017, G. Ke et al. · 2017-12-04 · 核验于 2026-10-21
- 45论文 CatBoost: unbiased boosting with categorical features · NeurIPS 2018, L. Prokhorenkova et al. · 2018-01-01 · 核验于 2026-10-21
- 46论文 Why do tree-based models still outperform deep learning on typical tabular data? · NeurIPS 2022 Datasets and Benchmarks, L. Grinsztajn et al. · 2022-07-18 · 核验于 2026-10-21
- 47论文 Benchmarking and Optimization of Gradient Boosting Decision Tree Algorithms · arXiv, A. Bentéjac et al. · 2018-09-12 · 核验于 2026-10-21
- 48文档 Beware Default Random Forest Importances · explained.ai, T. Parr et al. · 2018-03-26 · 核验于 2026-10-21
- 49文档 Permutation feature importance · scikit-learn User Guide · 2024-01-01 · 核验于 2026-10-21
- 50文档 The Elements of Statistical Learning (2nd ed.), Ch. 15: Random Forests · Springer, T. Hastie, R. Tibshirani, J. Friedman · 2009-01-01 · 核验于 2026-10-21
- 51论文 Table 2 Brief schema of the machine learning methods applied in this study. | Scientific Reports · Nature · 2021-03-03 · 核验于 2026-10-21
- 52论文 The Power of Simplicity: Why Simple Linear Models Outperform Complex Machine Learning Techniques - Case of Breast Cancer Diagnosis · arXiv · 2023-06-05 · 核验于 2026-10-21
- 53文档 Pattern Recognition and Machine Learning, Chapter 2 · Springer · 2006-08-01 · 核验于 2026-10-21
- 54论文 Nearest Neighbor Pattern Classification · IEEE Transactions on Information Theory, Vol. 13, No. 1, pp. 21–27 · 1967-01-01 · 核验于 2026-10-21
- 55论文 Locality-Sensitive Hashing Scheme Based on p-Stable Distributions · Proceedings of the 20th Annual Symposium on Computational Geometry (SoCG), ACM · 2004-06-08 · 核验于 2026-10-21
- 56文档 scikit-learn: Nearest Neighbors — user guide · scikit-learn developers · 2024-01-01 · 核验于 2026-10-21
- 57论文 Deep learning · Nature 521, 436–444(LeCun, Bengio & Hinton) · 2015-05-27 · 核验于 2026-10-21
- 58文档 Deep Learning (Adaptive Computation and Machine Learning series) · MIT Press(Goodfellow, Bengio & Courville) · 2016-11-18 · 核验于 2026-10-21
- 59论文 Gradient-based learning applied to document recognition · Proceedings of the IEEE 86(11)(LeCun et al.) · 1998-11-01 · 核验于 2026-10-21
- 60论文 ImageNet Classification with Deep Convolutional Neural Networks · NeurIPS 2012(Krizhevsky, Sutskever & Hinton) · 2012-12-03 · 核验于 2026-10-21
- 61论文 Long Short-Term Memory · Neural Computation 9(8)(Hochreiter & Schmidhuber) · 1997-11-15 · 核验于 2026-10-21
- 62论文 Attention Is All You Need · NeurIPS 2017(Vaswani et al.) · 2017-12-04 · 核验于 2026-10-21
- 63论文 Deep Residual Learning for Image Recognition · CVPR 2016(He et al.) · 2016-06-27 · 核验于 2026-10-21
- 64文档 AI and Compute · OpenAI(Amodei & Hernandez) · 2018-05-16 · 核验于 2026-10-21
- 65论文 “Why Should I Trust You?”: Explaining the Predictions of Any Classifier · KDD 2016(Ribeiro, Singh & Guestrin) · 2016-02-16 · 核验于 2026-10-21
- 66论文 Understanding deep learning requires rethinking generalization · ICLR 2017(Zhang et al.) · 2016-11-10 · 核验于 2026-10-21
- 67文档 Cornell Virtual Workshop > Scientific Machine Learning (SciML) > Multi-Layer Perceptron > Training a neural network · Cornell Virtual Workshop · 2024-01-01 · 核验于 2026-10-21
- 68文档 Cornell Virtual Workshop > AI with Deep Learning > Introduction to Deep Learning > Parameters and Training · Cornell Virtual Workshop · 2024-01-01 · 核验于 2026-10-21
- 69文档 Deep Learning (Chapter 7: Regularization for Deep Learning) · MIT Press · 2016-11-18 · 核验于 2026-10-21
- 70论文 Regularization and variable selection via the elastic net · Journal of the Royal Statistical Society: Series B, 67(2):301-320 · 2005-04-01 · 核验于 2026-10-21
- 71论文 Dropout: A Simple Way to Prevent Neural Networks from Overfitting · Journal of Machine Learning Research, 15:1929-1958 · 2014-06-01 · 核验于 2026-10-21
- 72论文 Early Stopping — But When? · Neural Networks: Tricks of the Trade, Springer · 2012-01-01 · 核验于 2026-10-21
- 73论文 A survey on Image Data Augmentation for Deep Learning · Journal of Big Data, 6:60 · 2019-07-06 · 核验于 2026-10-21
- 74论文 Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift · arXiv:1502.03167 · 2015-02-11 · 核验于 2026-10-21
- 75论文 Reconciling modern machine learning practice and the classical bias-variance trade-off · PNAS, 116(32):15849-15854 · 2019-07-15 · 核验于 2026-10-21
- 76论文 Deep Double Descent: Where Bigger Models and More Data Hurt · arXiv:1912.02292 · 2019-12-05 · 核验于 2026-10-21
- 77论文 Implicit Regularization in Deep Learning · arXiv:1706.08947 · 2017-06-27 · 核验于 2026-10-21
- 78论文 Decoupled Weight Decay Regularization · arXiv:1711.05101 · 2017-11-14 · 核验于 2026-10-21
- 79文档 資料集:分割原始資料集 | Machine Learning | Google for Developers · Google for Developers · 2024-01-01 · 核验于 2026-10-21
- 80文档 準備資料以建置模型 - ML.NET · Learn Microsoft · 2022-11-05 · 核验于 2026-10-21
- 81论文 Machine learning, statistical learning and the future of biological research in psychiatry · National Institutes of Health (NIH) | (.gov) · 2016-07-12 · 核验于 2026-10-21
- 82文档 Data Featurization in Automated Machine Learning - Azure Machine Learning · Learn Microsoft · 2025-04-01 · 核验于 2026-10-21
- 83论文 Machine Learning Practitioners’ Views on Data Quality in Light of EU Regulatory Requirements: A European Online Survey · arXiv · 2026-02-01 · 核验于 2026-10-21
- 84论文 Machine Learning Application Development: Practitioners’ Insights · arXiv · 2021-12-30 · 核验于 2026-10-21
- 85文档 别让烂数据毁了你的AI!一份人人能懂的数据集入门与避坑指南-阿里云开发者社区 · 阿里云开发者社区 · 2026-02-03 · 核验于 2026-10-21
- 86论文 Table 2 Per-class performance metrics for eight ML algorithms. | Scientific Reports · Nature · 2026-03-05 · 核验于 2026-10-21
- 87论文 Table 5 Performance metrics of machine learning models in the validation set. | Scientific Reports · Nature · 2025-07-11 · 核验于 2026-10-21
- 88论文 Table 1 Metrics for evaluating ML models: analysis of model effectiveness across training, validation, and testing phases. · Nature · 2025-08-27 · 核验于 2026-10-21
- 89论文 Table 2 Summary of Statistical Performance Metrics for the Developed Models Across Training, Validation, and Test Datasets. · Nature · 2026-05-05 · 核验于 2026-10-21
- 90文档 scikit-learn 邮件列表讨论:模型选择与训练/验证/测试划分 · Python.org · 2017-01-25 · 核验于 2026-10-21
- 91文档 第2章: 模型评估与选择 / Model Evaluation and Selection · GitHub · 2024-01-01 · 核验于 2026-10-21
- 92文档 模型评估与选择 · GitHub · 2024-01-01 · 核验于 2026-10-21
- 93文档 机器学习》二刷超详细笔记| 第二章 模型评估与选择-云社区-华为云 · 华为云社区 · 2022-01-14 · 核验于 2026-10-21
- 94文档 Image Processing: a Review on Industrial Applications - Repository of the Academy's Library · Repository of the Academy's Library · 2026-10-18 · 核验于 2026-10-21
- 95文档 机器学习—Wolfram Documentation · Wolfram: Computation Meets Knowledge · 2024-01-01 · 核验于 2026-10-21
- 96文档 计算机与网络 · CNKI · 2026-02-08 · 核验于 2026-10-21
- 97文档 Recommender Systems: An Introduction · Cambridge University Press · 2010-11-30 · 核验于 2026-10-21
- 98论文 Matrix Factorization Techniques for Recommender Systems · IEEE Computer, vol. 42, no. 8 · 2009-08-01 · 核验于 2026-10-21
- 99报道 The Netflix Prize · Netflix Prize Official Site · 2009-09-21 · 核验于 2026-10-21
- 100论文 Sampling-Bias-Corrected Neural Modeling for Large Corpus Item Recommendations · RecSys 2019 · 2019-09-10 · 核验于 2026-10-21
- 101论文 Deep Learning based Recommender System: A Survey and New Perspectives · ACM Computing Surveys, vol. 52, no. 1 · 2019-02-01 · 核验于 2026-10-21
- 102论文 Deep Neural Networks for YouTube Recommendations · RecSys 2016 · 2016-09-15 · 核验于 2026-10-21
- 103论文 Deep Interest Network for Click-Through Rate Prediction · KDD 2018 · 2018-07-19 · 核验于 2026-10-21
- 104文档 Evaluating Recommendation Systems · Recommender Systems Handbook, Springer · 2010-10-01 · 核验于 2026-10-21
- 105文档 The Filter Bubble: What the Internet Is Hiding from You · Penguin Press · 2011-05-12 · 核验于 2026-10-21
- 106报道 TikTok Recommendation Engine: How It Works · TikTok Newsroom · 2020-06-18 · 核验于 2026-10-21
- 107文档 NSTL国家科技图书文献中心 · NSTL国家科技图书文献中心 · 2022-01-01 · 核验于 2026-10-21
- 108文档 NSTL国家科技图书文献中心 · NSTL国家科技图书文献中心 · 2022-01-01 · 核验于 2026-10-21
- 109文档 DeepSklearn · PyPI · 2026-06-08 · 核验于 2026-10-21
- 110文档 使用 Apache Spark 訓練機器學習模型 - Microsoft Fabric · Learn Microsoft · 2025-09-24 · 核验于 2026-10-21
- 111文档 分布式训练 - Azure Databricks · Learn Microsoft · 2026-09-10 · 核验于 2026-10-21
- 112文档 Trainer SDK (PyPI) · PyPI · 2026-04-19 · 核验于 2026-10-21
- 113文档 Research Exploration of Artificial Intelligence: The Black Box · IEEE Xplore · 2025-12-04 · 核验于 2026-10-21
- 114论文 Table 5. · National Institutes of Health (NIH) | (.gov) · 2025-03-04 · 核验于 2026-10-21
- 115论文 Paradoxical inflation of prediction model performance measures in minority patient subgroups: the role of upstream bias · Nature · 2026-10-20 · 核验于 2026-10-21
- 116文档 Technical and Ethical Strategies to Prevent Machine Learning Models from Exploiting Personally Identifiable Information (PII) · IEEE Xplore · 2025-06-30 · 核验于 2026-10-21
- 117论文 Position: Certified Robustness Does Not (Yet) Imply Model Security · arXiv · 2025-06-16 · 核验于 2026-10-21
- 118文档 Regulation (EU) 2016/679 (General Data Protection Regulation), Articles 13–15, 17, 22 · EUR-Lex, European Union · 2016-04-27 · 核验于 2026-10-21
- 119文档 Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act) · EUR-Lex, European Union · 2024-07-12 · 核验于 2026-10-21
- 120标准 Artificial Intelligence Risk Management Framework (AI RMF 1.0), NIST AI 100-1 · National Institute of Standards and Technology · 2023-01-26 · 核验于 2026-10-21
- 121标准 Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile, NIST AI 600-1 · National Institute of Standards and Technology · 2024-07-26 · 核验于 2026-10-21
- 122标准 OECD Recommendation of the Council on Artificial Intelligence, OECD/LEGAL/0449 · OECD · 2019-05-22 · 核验于 2026-10-21
- 123标准 Recommendation on the Ethics of Artificial Intelligence · UNESCO · 2021-11-23 · 核验于 2026-10-21
- 124文档 生成式人工智能服务管理暂行办法 · 国家互联网信息办公室等七部门 · 2023-07-13 · 核验于 2026-10-21
- 125文档 互联网信息服务算法推荐管理规定 · 国家互联网信息办公室等四部门 · 2022-01-04 · 核验于 2026-10-21
- 126论文 Fair prediction with disparate impact: A study of bias in recidivism prediction instruments · Big Data, 5(2), 153–163; arXiv:1703.00056 · 2017-02-28 · 核验于 2026-10-21
- 127论文 Inherent Trade-Offs in the Fair Determination of Risk Scores · ITCS 2017; arXiv:1609.05807 · 2016-09-19 · 核验于 2026-10-21
- 128文档 Fairness and Machine Learning: Limitations and Opportunities · MIT Press (fairmlbook.org) · 2023-11-01 · 核验于 2026-10-21
- 129论文 The Measure and Mismeasure of Fairness: A Critical Review of Fair Machine Learning · arXiv:1808.00023 · 2018-07-31 · 核验于 2026-10-21
- 130论文 Stop Explaining Black Box Machine Learning Models for High Stakes Decisions and Use Interpretable Models Instead · Nature Machine Intelligence, 1, 206–215; arXiv:1811.10154 · 2018-11-26 · 核验于 2026-10-21
- 131论文 The (Im)possibility of Fairness: Different Value Systems Require Different Mechanisms For Fair Decision Making · Communications of the ACM, 64(4); arXiv:1904.07843 · 2019-04-16 · 核验于 2026-10-21
- 132论文 A Unified Approach to Interpreting Model Predictions (SHAP) · NeurIPS 2017; arXiv:1705.07874 · 2017-05-22 · 核验于 2026-10-21
- 133论文 The Many Hands Problem in AI Accountability · arXiv:2302.10819 · 2023-02-21 · 核验于 2026-10-21
- 134文档 Proposal for a Directive on adapting non-contractual civil liability rules to artificial intelligence (AI Liability Directive), COM(2022) 496 final · European Commission · 2022-09-28 · 核验于 2026-10-21
- 135论文 Machine Unlearning · IEEE Symposium on Security and Privacy 2021; arXiv:1912.03817 · 2019-12-09 · 核验于 2026-10-21
- 136文档 Colorado Artificial Intelligence Act (SB24-205) · Colorado General Assembly · 2024-05-17 · 核验于 2026-10-21
- 137文档 Directive on Automated Decision-Making · Government of Canada, Treasury Board of Canada Secretariat · 2019-06-05 · 核验于 2026-10-21
- 138文档 Understanding the Societal Impacts of Artificial Intelligence and Machine Learning on Employment and Workforce Dynamics · ieee.org · 2024-11-11 · 核验于 2026-10-21
- 139文档 Artificial Intelligence and Machine Learning in Our Everyday Life: Uses, Problems and Future · GLIMS Journal of Management Review and Transformation · 2025-12-08 · 核验于 2026-10-21