机器学习
- 英文名
- Machine Learning
- 缩写
- ML
- 上位领域
- 人工智能
- 核心要素
- 数据、模型、损失函数、优化算法
- 主要范式
- 监督学习、无监督学习、强化学习
- 典型任务
- 分类、回归、聚类、降维、生成
- 代表方法
- k-NN、决策树、线性/逻辑回归、支持向量机、随机森林、提升、神经网络、高斯过程
机器学习是人工智能的一个子集,其基本思想是让计算机算法通过经验(数据)自动完成特定任务,而不是由人逐条编写规则。11General Machine Learning — A brief introduction of machine learningsciencedirect.com前往参考资料 ↓在新标签页中打开
定义与定位
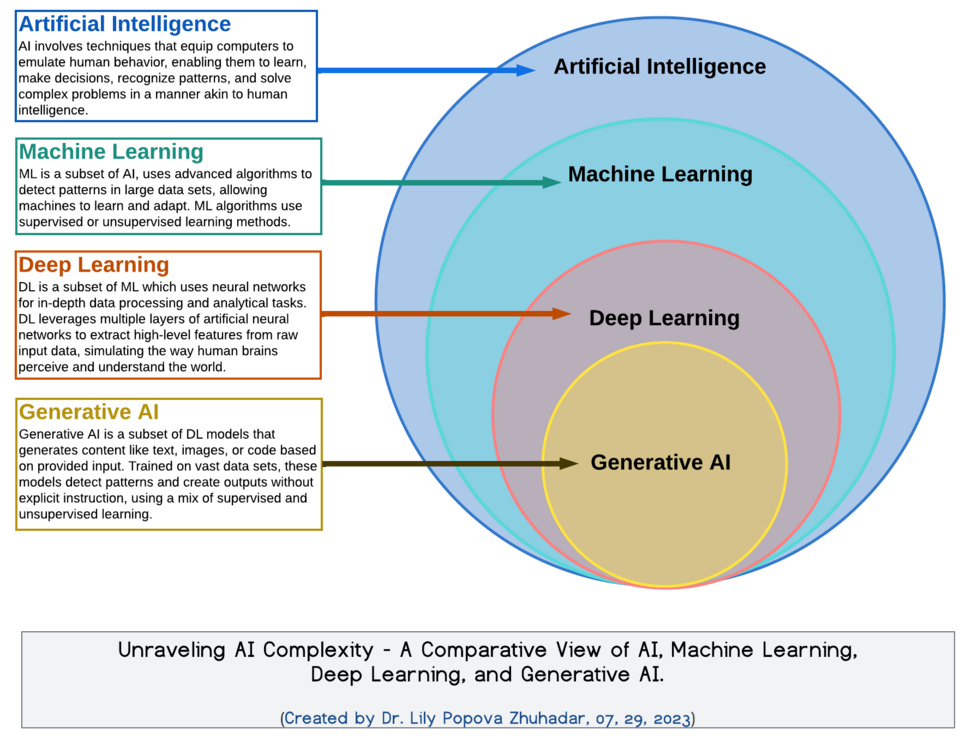
与人工智能、深度学习的关系
在通行的学科层级划分中,人工智能是范围最广的领域,机器学习被视为人工智能的一个子集,而深度学习又被视为机器学习的子集,三者构成层层包含的关系。66深度学习----科学智慧火花idea.cas.cn前往参考资料 ↓在新标签页中打开|77Cornell Virtual Workshop > An Overview of AI > Machine Learning and Deep Learning > Functionality and Implementationcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开
人工智能并不等同于机器学习:人工智能领域包含许多不涉及机器学习的研究方向,例如演绎、推理与问题求解、知识表示、运动与控制、数据挖掘等,机器学习只是其中的一个主要组成部分。66深度学习----科学智慧火花idea.cas.cn前往参考资料 ↓在新标签页中打开|77Cornell Virtual Workshop > An Overview of AI > Machine Learning and Deep Learning > Functionality and Implementationcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开
人工智能被理解为一种愿景或目标——用机器特别是计算机系统模拟人类的智能过程,使机器能够像人一样思考与行动;机器学习则是实现这一目标的算法性手段之一,二者在性质上一个是目标、一个是方法。66深度学习----科学智慧火花idea.cas.cn前往参考资料 ↓在新标签页中打开
机器学习指使用能够从数据中学习模式与结构的算法,而不需要被明确告知这些模式的细节;深度学习则是在此基础上进一步以多层表示学习为特征的方法族,因此常被描述为机器学习的一个子领域。77Cornell Virtual Workshop > An Overview of AI > Machine Learning and Deep Learning > Functionality and Implementationcvw.cac.cornell.edu前往参考资料 ↓在新标签页中打开|66深度学习----科学智慧火花idea.cas.cn前往参考资料 ↓在新标签页中打开
发展简史
早期符号主义与感知机
1950 年,图灵在《计算机器与智能》一文中提出了机器能否思考的问题,并讨论了让机器通过学习获得智能的可能性,这被视为机器学习思想的早期源头之一。99【《机器学习》周志华学习笔记1.5】~机器学习的“发展历程”-云社区-华为云bbs.huaweicloud.com前往参考资料 ↓在新标签页中打开
二十世纪五十年代中后期,基于神经网络的“连接主义”学习开始兴起,其代表性成果是感知机(Perceptron)。99【《机器学习》周志华学习笔记1.5】~机器学习的“发展历程”-云社区-华为云bbs.huaweicloud.com前往参考资料 ↓在新标签页中打开
二十世纪六七十年代,基于逻辑表示的“符号主义”学习得到发展,出现了归纳学习系统、概念学习系统等代表性工作。99【《机器学习》周志华学习笔记1.5】~机器学习的“发展历程”-云社区-华为云bbs.huaweicloud.com前往参考资料 ↓在新标签页中打开
统计学习时期
统计学习时期通常指 20 世纪 80 年代中后期至 90 年代中后期,机器学习从以符号规则为主的专家系统范式转向以概率统计和优化为基础的方法论,标志性事件包括 1986 年反向传播算法被重新发现并系统化、1988 年《Machine Learning》期刊创刊、以及 1990 年代支持向量机与核方法的兴起。1010Learning representations by back-propagating errorsnature.com前往参考资料 ↓在新标签页中打开|1111Support-vector networkslink.springer.com前往参考资料 ↓在新标签页中打开|1212A training algorithm for optimal margin classifiersdl.acm.org前往参考资料 ↓在新标签页中打开
1986 年,Rumelhart、Hinton 与 Williams 在《Nature》发表论文,系统阐述了通过反向传播误差来学习多层神经网络内部表示的方法,使多层感知机的训练在实践上可行,成为连接主义在统计学习时期复兴的关键技术基础。1010Learning representations by back-propagating errorsnature.com前往参考资料 ↓在新标签页中打开
1995 年,Corinna Cortes 与 Vladimir Vapnik 在《Machine Learning》期刊发表支持向量机(SVM)论文,提出软间隔(soft margin)方法,使支持向量机能够处理线性不可分数据,并借助核技巧在高维特征空间中构造分类超平面。1111Support-vector networkslink.springer.com前往参考资料 ↓在新标签页中打开
1992 年,Boser、Guyon 与 Vapnik 在计算学习理论会议(COLT)上提出核技巧用于最优间隔分类器,将支持向量机从线性可分情形推广到非线性决策边界,这是统计学习时期核方法兴起的早期关键文献。1212A training algorithm for optimal margin classifiersdl.acm.org前往参考资料 ↓在新标签页中打开
统计学习理论在这一时期形成较完整的框架,Vapnik 与 Chervonenkis 提出的 VC 维(Vapnik–Chervonenkis dimension)和结构风险最小化原则,为有限样本下的泛化能力提供了理论解释,与传统的经验风险最小化形成对照。1313The Nature of Statistical Learning Theorylink.springer.com前往参考资料 ↓在新标签页中打开
1997 年,Freund 与 Schapire 提出 AdaBoost 算法,通过组合多个弱分类器构造强分类器,成为统计学习时期集成方法(boosting)的代表性成果,并推动了此后关于间隔理论与泛化误差的研究。1414A decision-theoretic generalization of on-line learning and an application to boostingsciencedirect.com前往参考资料 ↓在新标签页中打开
1990 年代,统计学习时期的方法论强调模型复杂度控制与泛化性能,支持向量机、核方法、正则化与集成学习等成为主流,神经网络研究相对降温,直到 2006 年前后深度学习复兴才重新成为焦点。1515A few useful things to know about machine learningdl.acm.org前往参考资料 ↓在新标签页中打开
1988 年,Kluwer Academic Publishers(后并入 Springer)创刊《Machine Learning》期刊,为统计学习时期的方法研究提供了专门的发表平台,Cortes 与 Vapnik 的 SVM 论文即发表于该刊。1616Machine Learning (journal) — 期刊主页与创刊信息link.springer.com前往参考资料 ↓在新标签页中打开|1111Support-vector networkslink.springer.com前往参考资料 ↓在新标签页中打开
统计学习时期与连接主义复兴并非简单的替代关系:反向传播网络在 1980 年代中后期已展示出学习内部表示的能力,而 1990 年代支持向量机等方法的兴起部分源于对神经网络训练不稳定和缺乏泛化保证的回应,两者在时间上重叠并相互影响。1010Learning representations by back-propagating errorsnature.com前往参考资料 ↓在新标签页中打开|1111Support-vector networkslink.springer.com前往参考资料 ↓在新标签页中打开|1515A few useful things to know about machine learningdl.acm.org前往参考资料 ↓在新标签页中打开
深度学习兴起
深度学习在2010年代初取得突破性进展,2012年的AlexNet是这一进程中被广泛引用的标志性事件;科普中国在梳理机器学习发展历程时,把2012年的AlexNet与深度学习的实际应用并列为2000年初以来机器学习重大进展的代表。1717图文详情——科普中国资源服务cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
深度学习并非凭空出现,而是机器学习自20世纪50年代起长期演进的结果;科普中国将20世纪50年代中叶以来的机器学习研究划分为四个阶段,并指出不同时期的研究途径和目标并不相同,深度学习兴起属于这一长期进程中的后期阶段。1717图文详情——科普中国资源服务cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
大模型时代
2017年,Google 团队发表论文提出 Transformer 架构,其核心的自注意力机制能够建模序列中任意位置之间的依赖关系,摆脱了循环神经网络逐步递推的串行结构,成为此后 GPT、BERT 等大规模预训练模型的基础架构。1818大模型应用之:人工智能技术演进-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
Transformer 提出后,预训练加微调的两阶段范式迅速确立:先在大量无标注文本上以自监督目标预训练通用模型,再针对下游任务微调。BERT 与 GPT 系列分别代表了「双向编码器」与「自回归解码器」两条技术路线,使「基础模型(foundation model)」成为机器学习的新组织方式。1818大模型应用之:人工智能技术演进-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
2022年底 ChatGPT 发布,把大语言模型从研究圈推向公众视野,被广泛视为人工智能技术演进中的一个标志性节点;此后以对话式交互为入口的大模型应用迅速扩散,机器学习的产品形态从「为单一任务训练专用模型」转向「以一个通用模型服务多种任务」。1818大模型应用之:人工智能技术演进-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
基本要素
数据与特征
数据是机器学习的推动力:它以表格中的字词和数字、图片中的像素、音频文件中的波形等形式存在,并被组织成数据集供模型使用。2020监督式学习 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开
数据集由一个个示例组成,每个示例相当于表格中的一行;示例中用于预测的输入值称为特征,希望模型预测的目标值称为标签。2020监督式学习 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开
同时包含特征和标签的示例称为有标签示例;只包含特征、没有标签的示例称为无标签示例,模型训练完成后依据特征预测标签。2020监督式学习 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开
在数学记号中,特征通常用 x 表示、标签用 y 表示;一次观察往往包含多个特征值,因此 x 实际是一个向量,写作 [x1, x2, x3, …]。2121机器学习模型 - Traininglearn.microsoft.com前往参考资料 ↓在新标签页中打开
训练数据由过去的观察结果构成,观察一般包括所观察对象的属性(特征)以及要训练模型预测的已知值(标签);训练即把算法应用于数据,寻找特征与标签之间的关系,并使其泛化到新的 x 上计算 y。2121机器学习模型 - Traininglearn.microsoft.com前往参考资料 ↓在新标签页中打开
模型假设空间
在统计学习框架下,一个学习算法的性能由三部分共同决定:假设空间(hypothesis space)的容量、从假设空间中选出一个假设所依据的归纳偏好(inductive bias),以及可用于搜索该空间的样本数据量。假设空间规定了算法“能表示什么”,是模型表达能力的上界。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|2323Pattern Recognition and Machine Learninglink.springer.com前往参考资料 ↓在新标签页中打开
假设空间是学习算法允许输出的所有候选模型(假设)构成的集合。例如,线性回归的假设空间是全部线性函数,决策树的假设空间是全部可由该树结构表达的划分函数,而 k 近邻的假设空间则随训练集变化,属于“基于实例”的表示。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|2424Machine Learning: A Probabilistic Perspectivemitpress.mit.edu前往参考资料 ↓在新标签页中打开
归纳偏好(inductive bias)是学习算法在假设空间中偏好某些假设、排斥另一些假设的机制。没有归纳偏好,算法无法在训练集上表现相同的众多假设中做出选择;因此任何有效的学习算法都必须带有某种偏好。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|2525Pattern Recognition and Machine Learning, Chapter 1: Introductionlink.springer.com前往参考资料 ↓在新标签页中打开
假设空间的容量与泛化能力之间存在权衡:容量过小(如线性模型拟合非线性数据)会导致欠拟合,容量过大(如高次多项式或深度过深的树)则容易过拟合。这一权衡通常用偏差—方差分解(bias-variance decomposition)来刻画:模型复杂度上升时偏差下降、方差上升。2323Pattern Recognition and Machine Learninglink.springer.com前往参考资料 ↓在新标签页中打开
VC 维(Vapnik–Chervonenkis dimension)是刻画二分类假设空间容量的经典度量:若一个假设空间能打散(shatter)某个大小为 d 的样本集,但不能打散任何大小为 d+1 的样本集,则其 VC 维为 d。VC 维有限是假设空间具有一致收敛性、从而可用经验风险最小化保证泛化的充分条件。1313The Nature of Statistical Learning Theorylink.springer.com前往参考资料 ↓在新标签页中打开|2626Foundations of Machine Learning (2nd ed.)mitpress.mit.edu前往参考资料 ↓在新标签页中打开
Rademacher 复杂度与增长函数(growth function)是比 VC 维更精细的容量度量,可用于给出依赖数据分布的泛化误差界;这些工具把“假设空间有多大”从纯组合计数推进到与样本分布相关的分析。2626Foundations of Machine Learning (2nd ed.)mitpress.mit.edu前往参考资料 ↓在新标签页中打开|2727Rademacher Complexitylink.springer.com前往参考资料 ↓在新标签页中打开
在深度学习中,经典容量度量与泛化之间的对应关系被削弱:过参数化网络(参数量远大于训练样本数)的 VC 维可以极大,却仍能泛化。这一现象促使研究者转向基于范数、间隔(margin)和隐式正则化的容量分析。2828Understanding deep learning requires rethinking generalizationarxiv.org前往参考资料 ↓在新标签页中打开|2929Exploring Generalization in Deep Learningarxiv.org前往参考资料 ↓在新标签页中打开
对立说法有研究认为,经典统计学习理论中的容量度量(VC 维、Rademacher 复杂度)在过参数化情形下仍能通过更精细的范数或间隔界给出有意义的泛化保证,深度网络并非完全脱离经典框架。31
假设空间的选择直接决定模型可表达的函数族:线性模型只能表达输入特征的线性组合,核方法通过核函数隐式地把假设空间扩展到高维(甚至无穷维)再生核希尔伯特空间,而神经网络通过多层非线性变换表达高度复合的函数。2424Machine Learning: A Probabilistic Perspectivemitpress.mit.edu前往参考资料 ↓在新标签页中打开|3030Learning with Kernels: Support Vector Machines, Regularization, Optimization, and Beyondmitpress.mit.edu前往参考资料 ↓在新标签页中打开
在贝叶斯视角下,假设空间对应先验分布所支撑的模型集合,学习过程是在该空间上做后验推断;先验即一种显式的归纳偏好,而最大后验估计可视为带正则化的经验风险最小化。2525Pattern Recognition and Machine Learning, Chapter 1: Introductionlink.springer.com前往参考资料 ↓在新标签页中打开|3131Bayesian Reasoning and Machine Learningcs.ucl.ac.uk前往参考资料 ↓在新标签页中打开
损失函数
损失函数(loss function)是机器学习中用来衡量模型预测值与真实值之间差异的函数,它为学习算法提供了优化目标,训练过程通常被表述为最小化损失函数(或等价地最大化似然)。3535Deep Learningdeeplearningbook.org前往参考资料 ↓在新标签页中打开|2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开
在统计学习框架下,损失函数与风险函数紧密相关:期望风险是损失函数在数据分布上的期望,而经验风险是损失函数在训练样本上的平均值,经验风险最小化(ERM)是许多学习算法的基本原则。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|3636Pattern Recognition and Machine Learningmicrosoft.com前往参考资料 ↓在新标签页中打开
常见的损失函数包括:用于回归的平方损失(均方误差)、绝对损失;用于分类的 0-1 损失、合页损失(hinge loss)、交叉熵损失(对数损失);以及用于概率模型的负对数似然损失。3535Deep Learningdeeplearningbook.org前往参考资料 ↓在新标签页中打开|2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|1111Support-vector networkslink.springer.com前往参考资料 ↓在新标签页中打开
合页损失(hinge loss)是支持向量机(SVM)的核心损失函数,定义为 max(0, 1 - y·f(x)),它惩罚被错误分类或位于间隔内的样本,从而鼓励最大间隔分类。1111Support-vector networkslink.springer.com前往参考资料 ↓在新标签页中打开|3737A Tutorial on Support Vector Machines for Pattern Recognitionlink.springer.com前往参考资料 ↓在新标签页中打开
交叉熵损失(cross-entropy loss)常用于分类任务,等价于对模型输出的概率分布与真实标签分布之间的交叉熵进行最小化,在深度学习中与 softmax 激活函数配合使用非常普遍。3535Deep Learningdeeplearningbook.org前往参考资料 ↓在新标签页中打开|3838CS231n: Convolutional Neural Networks for Visual Recognition — Loss Functionscs231n.github.io前往参考资料 ↓在新标签页中打开
0-1 损失直接对应分类错误率,但由于其非凸、不连续,优化困难,实践中常使用其凸替代损失(如合页损失、逻辑损失)进行优化。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|1111Support-vector networkslink.springer.com前往参考资料 ↓在新标签页中打开
损失函数的选择会影响模型的鲁棒性:平方损失对异常值敏感,而绝对损失和 Huber 损失对异常值更稳健。3939Robust Regression and Outlier Detectiononlinelibrary.wiley.com前往参考资料 ↓在新标签页中打开|4040Huber loss — Wikipediaen.wikipedia.org前往参考资料 ↓在新标签页中打开
在贝叶斯视角下,许多损失函数可以解释为负对数似然:例如,平方损失对应于高斯噪声假设下的负对数似然,交叉熵损失对应于多项分布假设下的负对数似然。3535Deep Learningdeeplearningbook.org前往参考资料 ↓在新标签页中打开|3636Pattern Recognition and Machine Learningmicrosoft.com前往参考资料 ↓在新标签页中打开
损失函数与正则化项共同构成目标函数:正则化项(如 L1、L2 正则)用于控制模型复杂度,防止过拟合,而损失函数衡量数据拟合程度。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|4141Regularization and variable selection via the elastic netrss.onlinelibrary.wiley.com前往参考资料 ↓在新标签页中打开
在深度学习中,损失函数的设计需考虑梯度特性:例如,交叉熵损失与 softmax 结合时梯度形式简洁,而均方误差与 sigmoid 结合时可能出现梯度消失问题。3838CS231n: Convolutional Neural Networks for Visual Recognition — Loss Functionscs231n.github.io前往参考资料 ↓在新标签页中打开|4242Why are deep neural networks hard to train? — Neural Networks and Deep Learningneuralnetworksanddeeplearning.com前往参考资料 ↓在新标签页中打开
优化算法
在机器学习中,优化算法负责调整模型参数以最小化(或最大化)一个目标函数,通常写作经验风险或损失函数;训练过程本质上是在参数空间中求解一个优化问题。4343Deep Learning (Adaptive Computation and Machine Learning series), Chapter 8: Optimization for Training Deep Modelsdeeplearningbook.org前往参考资料 ↓在新标签页中打开
梯度下降法是最基础的优化算法:它沿目标函数梯度的反方向迭代更新参数,更新规则为 θ ← θ − η∇θL(θ),其中 η 为学习率。4343Deep Learning (Adaptive Computation and Machine Learning series), Chapter 8: Optimization for Training Deep Modelsdeeplearningbook.org前往参考资料 ↓在新标签页中打开|4444Convex Optimizationweb.stanford.edu前往参考资料 ↓在新标签页中打开
随机梯度下降(SGD)每次仅用一个小批量(mini-batch)样本估计梯度,从而大幅降低单次迭代的计算成本,并使算法可扩展到大规模数据集;小批量大小的选择在梯度估计方差与计算效率之间权衡。4343Deep Learning (Adaptive Computation and Machine Learning series), Chapter 8: Optimization for Training Deep Modelsdeeplearningbook.org前往参考资料 ↓在新标签页中打开|4444Convex Optimizationweb.stanford.edu前往参考资料 ↓在新标签页中打开
动量法(Momentum)在参数更新中累积过去梯度的指数加权平均,用以抑制震荡并加速沿一致方向的移动;Nesterov 加速梯度则是在预估的下一步位置计算梯度,具有不同的收敛性质。4343Deep Learning (Adaptive Computation and Machine Learning series), Chapter 8: Optimization for Training Deep Modelsdeeplearningbook.org前往参考资料 ↓在新标签页中打开|4545ADADELTA: An Adaptive Learning Rate Methodarxiv.org前往参考资料 ↓在新标签页中打开
AdaGrad 为每个参数维护独立的学习率,按历史梯度平方和的平方根进行缩放,使频繁更新的参数学习率衰减更快;其累积量单调增长会导致学习率过早过小,这一缺陷在后续算法中被修正。4545ADADELTA: An Adaptive Learning Rate Methodarxiv.org前往参考资料 ↓在新标签页中打开|4646Lecture 6.5 - rmsprop: Divide the gradient by a running average of its recent magnitude (Neural Networks for Machine Learning, Coursera)cs.toronto.edu前往参考资料 ↓在新标签页中打开
RMSProp 用梯度平方的指数移动平均替代 AdaGrad 中的累加和,从而在非平稳目标上维持可用的学习率;该方法是 Hinton 在 Coursera 课程讲义中提出的,未正式发表于同行评议论文。4646Lecture 6.5 - rmsprop: Divide the gradient by a running average of its recent magnitude (Neural Networks for Machine Learning, Coursera)cs.toronto.edu前往参考资料 ↓在新标签页中打开
Adam 结合了动量(梯度一阶矩的指数移动平均)与 RMSProp(梯度二阶矩的指数移动平均),并引入偏差校正,其默认超参数(β1=0.9、β2=0.999、ε=1e-8)在大量任务上表现稳健,成为深度学习中应用最广的优化器之一。4747Adam: A Method for Stochastic Optimizationarxiv.org前往参考资料 ↓在新标签页中打开
关于 Adam 的收敛性存在公开争论:原始论文声称其适用于非凸优化,而 Reddi 等人指出原始 Adam 在某些凸问题上不收敛,并提出了修正版本 AMSGrad。4747Adam: A Method for Stochastic Optimizationarxiv.org前往参考资料 ↓在新标签页中打开|4848On the Convergence of Adam and Beyondarxiv.org前往参考资料 ↓在新标签页中打开
学习率是优化中最关键的超参数之一:过大导致发散或震荡,过小导致收敛缓慢;实践中常用学习率预热(warmup)与衰减策略(如余弦退火、阶梯衰减)来改善训练稳定性与最终性能。4343Deep Learning (Adaptive Computation and Machine Learning series), Chapter 8: Optimization for Training Deep Modelsdeeplearningbook.org前往参考资料 ↓在新标签页中打开|4949Attention Is All You Need (Section 5.3: Optimizer, warmup and decay)arxiv.org前往参考资料 ↓在新标签页中打开
二阶优化方法(如牛顿法、拟牛顿法 L-BFGS)利用 Hessian 或其近似来缩放梯度方向,在凸问题与中小规模问题上收敛更快,但因存储与计算 Hessian 的成本随参数量平方增长,难以直接用于现代深度网络。4444Convex Optimizationweb.stanford.edu前往参考资料 ↓在新标签页中打开|5050On the Limited Memory BFGS Method for Large Scale Optimizationlink.springer.com前往参考资料 ↓在新标签页中打开
在深度学习中,优化景观的非凸性意味着算法通常只能保证收敛到局部极小或鞍点附近;鞍点在髙维非凸问题中比局部极小更普遍,这也是动量类方法受到重视的原因之一。5151Identifying and attacking the saddle point problem in high-dimensional non-convex optimizationarxiv.org前往参考资料 ↓在新标签页中打开
正则化与优化相互交织:L2 正则(权重衰减)等价于在梯度更新中加入与参数成正比的收缩项;Adam 中的 L2 正则与权重衰减并不等价,Loshchilov 与 Hutter 因此提出解耦权重衰减的 AdamW。5252Decoupled Weight Decay Regularization (AdamW)arxiv.org前往参考资料 ↓在新标签页中打开
泛化与正则化
泛化指模型在训练时未见过的数据上的表现能力;在机器学习中,训练集上的表现与测试集上的表现之间的差距是衡量泛化好坏的基本观察方式。5555过拟合:模型复杂性 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开
过拟合是指模型在训练数据上表现很好、但在新数据上表现变差的现象;与之相对,模型过于简单而无法捕捉数据中的规律则称为欠拟合。5555过拟合:模型复杂性 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开
模型复杂度是影响泛化的关键因素:复杂模型容易记住训练数据中的噪声,从而在测试集上表现下降;把复杂模型替换为更简单的模型(例如一条直线)后,简单模型在新数据上的泛化效果反而更好。5555过拟合:模型复杂性 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开
对简单性的偏好可追溯到古希腊,并在14世纪由奥卡姆的威廉正式表述为“奥卡姆剃刀”;这一原则至今仍是包括机器学习在内的许多科学领域的基本原理,也是正则化思想背后的直觉来源。5555过拟合:模型复杂性 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开
正则化是一类通过在训练目标中加入对模型复杂度的惩罚、或对模型施加约束,以抑制过拟合并改善泛化的技术的统称;其常见形式包括对参数大小的惩罚(如 L1、L2 正则化)以及限制模型结构的做法。5555过拟合:模型复杂性 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开
学习范式
监督学习
监督学习(supervised learning)是机器学习的一种基本范式:训练数据由输入对象(通常是特征向量)与对应的预期输出(标签)成对组成,学习器从这些范例中归纳出一个从输入到输出的映射函数,再用它预测新实例的输出。5656建立機器學習模型 - Traininglearn.microsoft.com前往参考资料 ↓在新标签页中打开|5757图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
监督学习与无监督学习的核心差别在于目标函数的运作方式:监督学习在训练时已知每个样本的正确答案,而无监督学习在不知道正确答案的情况下训练模型,通常用于没有唯一正确答案、只需区分更好或更差方案的问题。5656建立機器學習模型 - Traininglearn.microsoft.com前往参考资料 ↓在新标签页中打开
监督学习的目标不止于拟合训练范例,而是要从已有数据一般化到未观察到的情况;这种从有限样本推广到新样本的过程需要依赖归纳偏向(inductive bias)等“合理”的假设。5757图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
监督学习模型可大致分为两类形态:一类产生全局模型,把输入对象直接映射到预期输出;另一类把这种映射实现在局部,例如案例推论与最近邻居法。5757图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
无监督学习
无监督学习指算法在没有人工标注目标值的情况下,仅从输入数据本身的结构、分布或相似性中提取模式的一类学习范式;其训练信号不来自外部标签,而来自数据内部的组织规律。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|3535Deep Learningdeeplearningbook.org前往参考资料 ↓在新标签页中打开
在经典统计学习教材的框架中,无监督学习与监督学习、强化学习并列为三大学习范式;其典型任务包括聚类、密度估计与降维,目标常被表述为发现数据的内在结构或低维表示。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|3636Pattern Recognition and Machine Learningmicrosoft.com前往参考资料 ↓在新标签页中打开
k 均值聚类是无监督学习中最常被引用的原型算法之一:它通过迭代地把样本分配给最近的簇中心并更新簇中心,最小化簇内平方误差;其簇数 k 需由使用者预先指定。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|3636Pattern Recognition and Machine Learningmicrosoft.com前往参考资料 ↓在新标签页中打开
主成分分析(PCA)是无监督降维的代表方法,它寻找数据方差最大的正交方向作为主成分,可用特征值分解或奇异值分解求解,常用于可视化、去噪与特征压缩。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|3636Pattern Recognition and Machine Learningmicrosoft.com前往参考资料 ↓在新标签页中打开
高斯混合模型配合期望最大化(EM)算法构成一种基于概率密度的无监督方法,与 k 均值这类硬分配方法不同,它给出样本属于各成分的后验概率,属于软聚类。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|3636Pattern Recognition and Machine Learningmicrosoft.com前往参考资料 ↓在新标签页中打开
自编码器是一类以重构输入为训练目标的无监督神经网络:编码器把输入压缩为低维表示,解码器再将其还原,训练完成后编码器输出可作为特征表示使用。3535Deep Learningdeeplearningbook.org前往参考资料 ↓在新标签页中打开|5858Self-supervised Learning: Generative or Contrastivearxiv.org前往参考资料 ↓在新标签页中打开
自监督学习通常被视为无监督学习在深度学习中的延伸:它从数据自身构造代理任务(如掩码预测、对比学习)来生成训练信号,因而不依赖人工标注,但构造出的代理标签仍是一种监督信号,学界对其归类存在不同表述。3535Deep Learningdeeplearningbook.org前往参考资料 ↓在新标签页中打开|5858Self-supervised Learning: Generative or Contrastivearxiv.org前往参考资料 ↓在新标签页中打开
无监督学习方法的输出缺乏唯一正确答案,其评估往往依赖内部指标(如轮廓系数、簇内紧密度)或下游任务表现,而非像监督学习那样直接比对标签,这使结果评价带有一定主观性。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|3636Pattern Recognition and Machine Learningmicrosoft.com前往参考资料 ↓在新标签页中打开
半监督学习
半监督学习(Semi-supervised Learning)是一种介于监督学习与无监督学习之间的学习范式:它在训练中同时使用少量带标签数据和大量未标注数据,用少量标注数据引导模型从大量未标注数据中学习。5959机器学习基础入门(第五篇):半监督学习与强化学习-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
半监督学习的主要动机来自现实中的数据条件:标注数据往往稀缺且昂贵,而未标注数据(图片、视频、日志、语音等)却极其丰富、易于获取。5959机器学习基础入门(第五篇):半监督学习与强化学习-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
典型的高标注成本场景包括:医学影像识别中标注一张 CT 图像可能需要医生数分钟甚至数十分钟;网络安全检测中判定哪些流量属于恶意攻击需要人工分析;语音识别中大量语音数据没有对应的文字转录。5959机器学习基础入门(第五篇):半监督学习与强化学习-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
自监督学习
自监督学习被描述为一种无监督学习的新范式,其核心目标是减少机器学习对大量人工标记/注释数据的依赖,转而高效利用廉价且易获取的无标记数据。5757图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
自监督学习受到关注的背景是:尽管已身处大数据时代,但代价高昂、不易获取的标记数据仍是机器学习发展的瓶颈,而无标记数据相对廉价且易获取,因此如何高效利用无标记数据长期是学界关注的焦点。5757图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
在自监督学习中,监督信号并非来自人工标注,而是从无标记数据自身构造出来,模型通过完成由数据自动生成的预训练任务来学习表征,这是它与传统监督学习和一般无监督学习相区别的关键。5757图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
自监督学习通常被放在表征学习/预训练的语境下讨论:先在大量无标记数据上以自监督方式预训练,再把学到的表征迁移到下游任务,从而降低下游任务对标注的依赖。5757图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
自监督学习与迁移学习、域适应等方向被并列视为应对动态、开放、非平稳真实场景(如无人驾驶、医疗诊断)的研究路线之一,其共同动机是现有在封闭静态环境下训练的模型难以直接奏效。5757图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
强化学习
强化学习是机器学习的一种学习范式,其核心设定是智能体(agent)在与环境(environment)的交互中,通过试错(trial-and-error)获得标量奖励(reward)信号,并以最大化长期累积奖励为目标来学习策略(policy)。6060Reinforcement Learning: An Introduction (2nd ed.)incompleteideas.net前往参考资料 ↓在新标签页中打开|6161Reinforcement learning - Wikipediaen.wikipedia.org前往参考资料 ↓在新标签页中打开
强化学习与监督学习的关键区别在于:强化学习不依赖预先标注的“正确动作”样本,而是通过奖励信号评价动作的好坏,且动作会影响后续的数据分布与状态转移,因此存在探索与利用(exploration vs. exploitation)的权衡。6060Reinforcement Learning: An Introduction (2nd ed.)incompleteideas.net前往参考资料 ↓在新标签页中打开|6161Reinforcement learning - Wikipediaen.wikipedia.org前往参考资料 ↓在新标签页中打开
强化学习问题通常用马尔可夫决策过程(Markov Decision Process, MDP)建模,包含状态空间、动作空间、转移概率、奖励函数和折扣因子等要素;在满足马尔可夫性质时,最优策略可通过贝尔曼方程刻画。6060Reinforcement Learning: An Introduction (2nd ed.)incompleteideas.net前往参考资料 ↓在新标签页中打开|6262Markov decision process - Wikipediaen.wikipedia.org前往参考资料 ↓在新标签页中打开
基于值函数的方法(如 Q-learning、SARSA)通过估计状态或状态-动作值函数来间接导出策略;Q-learning 是一种离策略(off-policy)时序差分算法,其收敛性在表格型设定下有经典证明。6262Markov decision process - Wikipediaen.wikipedia.org前往参考资料 ↓在新标签页中打开|6363Q-learning - Wikipediaen.wikipedia.org前往参考资料 ↓在新标签页中打开
基于策略的方法直接对策略进行参数化并优化期望回报,代表性算法包括 REINFORCE 等策略梯度方法;这类方法天然支持连续动作空间,但方差较大,常需引入基线(baseline)或优势函数来降低方差。6464Policy gradient methods - Wikipediaen.wikipedia.org前往参考资料 ↓在新标签页中打开|6565Actor-critic - Wikipediaen.wikipedia.org前往参考资料 ↓在新标签页中打开
演员-评论家(actor-critic)方法结合了策略梯度与值函数估计,演员负责更新策略、评论家负责评估策略,是深度强化学习中广泛采用的框架。6565Actor-critic - Wikipediaen.wikipedia.org前往参考资料 ↓在新标签页中打开|6666Asynchronous Methods for Deep Reinforcement Learningarxiv.org前往参考资料 ↓在新标签页中打开
深度强化学习(deep reinforcement learning)用深度神经网络近似策略和/或值函数,使强化学习能够处理高维感知输入(如原始图像);DQN 在 Atari 2600 游戏上仅凭像素输入和奖励信号学习,在多个游戏上达到或超过人类水平的表现,是这一方向的标志性工作。6767Human-level control through deep reinforcement learningnature.com前往参考资料 ↓在新标签页中打开|6868Playing Atari with Deep Reinforcement Learningarxiv.org前往参考资料 ↓在新标签页中打开
AlphaGo 及其后续版本 AlphaGo Zero 将深度神经网络与蒙特卡洛树搜索(MCTS)结合,并通过自我对弈(self-play)进行训练;AlphaGo Zero 不依赖人类棋谱,从随机初始化开始自我对弈即达到超越此前版本的棋力。6969Mastering the game of Go with deep neural networks and tree searchnature.com前往参考资料 ↓在新标签页中打开|7070Mastering the game of Go without human knowledgenature.com前往参考资料 ↓在新标签页中打开
在连续控制基准(如 MuJoCo locomotion 任务)上,近端策略优化(PPO)、软演员-评论家(SAC)等算法是常用且具有代表性的方法;PPO 以裁剪的重要性采样比率约束策略更新幅度,SAC 则以最大熵目标鼓励探索。7171Proximal Policy Optimization Algorithmsarxiv.org前往参考资料 ↓在新标签页中打开|7272Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actorarxiv.org前往参考资料 ↓在新标签页中打开
强化学习也常与人类反馈结合,形成基于人类反馈的强化学习(RLHF):先训练奖励模型拟合人类偏好,再用强化学习微调语言模型,这一流程在让大语言模型对齐人类意图方面被广泛采用。7373Training language models to follow instructions with human feedbackarxiv.org前往参考资料 ↓在新标签页中打开|7474Deep reinforcement learning from human preferencesarxiv.org前往参考资料 ↓在新标签页中打开
常用算法
k 近邻与决策树
k 近邻(k-nearest neighbors,kNN)是一种基于实例的学习方法:它不显式训练参数模型,而是把训练样本原样保存,预测时在特征空间中找出与待测样本距离最近的 k 个训练样本,以它们的标签或目标值做多数投票或平均。因此其“训练阶段”极快、成本很低,主要计算开销被推迟到预测阶段。7979Table 2 Review of supervised machine learning techniques. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
k 近邻的主要优点被概括为易于理解、易于实现,训练阶段快速且低成本,能够较快地对实例完成分类,并且对含噪声的数据有一定容忍能力。7979Table 2 Review of supervised machine learning techniques. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
k 近邻的主要局限在于预测阶段的计算代价高:每次预测都要计算待测样本与大量训练样本之间的距离,因而被归类为计算开销较大的方法;同时其效果对距离度量、k 的取值以及特征尺度(是否需要归一化)高度敏感。7979Table 2 Review of supervised machine learning techniques. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
决策树(decision tree,DT)是一种以树形结构表示判别规则的监督学习方法:内部节点对某个特征做条件判断,分支对应判断结果,叶节点给出类别或数值输出,从根到叶的一条路径即构成一条可读的“若—则”规则。7979Table 2 Review of supervised machine learning techniques. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
决策树被普遍评价为结构简单、易于理解和解释的模型,其归纳出的规则可以直接呈现给使用者,这是它相对于许多黑箱模型的主要优势之一。7979Table 2 Review of supervised machine learning techniques. | Scientific Reportsnature.com前往参考资料 ↓在新标签页中打开
线性与逻辑回归
线性回归假设输入特征与输出之间存在线性关系,即输出是输入特征的线性组合,其一般形式可写为 y = θ0 + θ1x1 + θ2x2 + … + θnxn,其中 x1…xn 是输入变量,θ0…θn 是模型参数。8282深入解析机器学习算法-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
线性回归最常用的拟合技术是最小二乘法:它寻找一条直线(或超平面),使所有数据点到该直线的垂直距离的平方和最小,即通过最小化平方误差来拟合模型。8181机器学习必知必会10大算法developer.aliyun.com前往参考资料 ↓在新标签页中打开
线性回归的主要优点是模型简单、可解释性高、容易实现,且在小数据集上训练和预测的计算效率高;其主要局限是线性假设较强,当数据不呈线性关系时效果有限,并且对异常值敏感。8282深入解析机器学习算法-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
逻辑回归与线性回归类似,但面向输出只有两个可能取值的二分类情形;它对线性组合的中间结果施加一个非线性的 S 型函数(logistic 函数,也称 sigmoid 函数),把输出映射到 0 到 1 之间,从而可以解释为样本属于某一类别的概率。8181机器学习必知必会10大算法developer.aliyun.com前往参考资料 ↓在新标签页中打开|8282深入解析机器学习算法-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
逻辑回归的判别形式可写为 P(y=1|x) = 1 / (1 + e^-(θ0 + θ1x1 + … + θnxn)),即先对特征做线性组合,再经 sigmoid 函数变换为概率。8282深入解析机器学习算法-腾讯云开发者社区-腾讯云cloud.tencent.cn前往参考资料 ↓在新标签页中打开
支持向量机
支持向量机(Support Vector Machine, SVM)是一类基于监督学习的模式识别模型,其基本构造思路是用一个线性输入单元构建二分类器,即在高维特征空间中寻找一个把两类样本分开的判别面。8383Table 2 Brief schema of the machine learning methods applied in this study.nature.com前往参考资料 ↓在新标签页中打开
在计算代价上,支持向量机的运算量大致与样本数的平方成正比,因此当数据规模较大时计算开销显著,速度可能明显偏慢;相比之下,随机森林在大数据量下往往比支持向量机更快。8383Table 2 Brief schema of the machine learning methods applied in this study.nature.com前往参考资料 ↓在新标签页中打开
集成方法:随机森林与提升
集成方法(ensemble method)指把多个基学习器(base learner)的预测结果按某种规则组合成一个整体预测器的做法,其基本假设是若干弱学习器或差异化模型的组合往往比其中任何单一模型更稳健。随机森林与提升(boosting)是其中两条最主流的路线:前者以并行、独立训练为特征,后者以串行、逐轮纠错为特征。8484CN118608167B - 一种基于大数据的认证分析系统及方法 - Google Patentspatents.google.com前往参考资料 ↓在新标签页中打开|8585CN120238354A - 基于弹性能源预测的虚假数据注入攻击检测方法及系统 - Google Patentspatents.google.com前往参考资料 ↓在新标签页中打开
随机森林由大量决策树组成,其降低误差的机制是聚合一组预测器的输出:训练时对输入实例做随机抽样,并在分裂节点时只考虑随机选定的特征子集,从而使各棵树之间产生差异,再通过聚合抵消单棵树的高方差。8585CN120238354A - 基于弹性能源预测的虚假数据注入攻击检测方法及系统 - Google Patentspatents.google.com前往参考资料 ↓在新标签页中打开
随机森林的构建通常可概括为三个环节:构建每棵树时随机选取训练实例、为节点分裂指定特征子集、以及用选定的特征子集完成节点分裂;每棵树都从随机抽取的输入实例样本中学习。8585CN120238354A - 基于弹性能源预测的虚假数据注入攻击检测方法及系统 - Google Patentspatents.google.com前往参考资料 ↓在新标签页中打开
提升类方法(如梯度提升决策树)以串行方式逐轮训练新模型去修正前一轮的残差或误差方向,最终把多轮弱模型加权求和为强模型;与随机森林的并行独立训练不同,提升的各轮模型之间存在依赖关系。8484CN118608167B - 一种基于大数据的认证分析系统及方法 - Google Patentspatents.google.com前往参考资料 ↓在新标签页中打开
高斯过程
高斯过程(Gaussian Process, GP)是机器学习中一类基于核方法的非参数贝叶斯模型,它把函数本身视为随机变量,并假定任意有限个输入点上的函数值服从联合高斯分布;因此一个高斯过程完全由均值函数和协方差(核)函数确定。8686Deep learning based black spot identification on Greek road networksar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
高斯过程回归的预测分布具有闭式解:给定训练集后,对新输入点的后验均值与后验方差可由核矩阵的逆(或 Cholesky 分解)直接算出,无需迭代优化,这是它与神经网络等参数化模型在计算形态上的主要区别。8686Deep learning based black spot identification on Greek road networksar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
高斯过程的核心计算瓶颈在于对 n×n 核矩阵求逆,训练与预测的时间复杂度为 O(n^3),存储复杂度为 O(n^2),因此标准 GP 难以直接扩展到十万级以上样本;稀疏近似、诱导点方法与变分推断是常见的应对手段。8686Deep learning based black spot identification on Greek road networksar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
核函数的选择与超参数(如长度尺度、信号方差、噪声方差)通过最大化边际似然(type-II maximum likelihood)来确定,这一过程自动实现了模型复杂度的权衡,无需单独的验证集做早停。8686Deep learning based black spot identification on Greek road networksar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
高斯过程天然给出预测的不确定性(后验方差),这一特性使其在贝叶斯优化、主动学习与实验设计等需要量化探索风险的场景中被广泛采用。8686Deep learning based black spot identification on Greek road networksar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
神经网络与深度网络
人工神经网络(Artificial Neural Network, ANN)是一类受生物神经系统启发的计算模型,由大量相互连接的简单处理单元(神经元)组成,通过调整连接权重来学习输入到输出的映射。8787Deep Learningnature.com前往参考资料 ↓在新标签页中打开
现代深度学习的奠基性工作之一是反向传播算法(Backpropagation)的普及,Rumelhart、Hinton 和 Williams 于 1986 年在《Nature》发表论文,系统阐述了用反向传播训练多层神经网络的方法。1010Learning representations by back-propagating errorsnature.com前往参考资料 ↓在新标签页中打开
卷积神经网络(Convolutional Neural Network, CNN)通过卷积层、池化层和全连接层的堆叠来提取图像的层次化特征,LeCun 等人于 1998 年提出的 LeNet-5 是早期成功应用于手写数字识别的 CNN 架构。8888Gradient-based learning applied to document recognitionieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
2012 年,Krizhevsky、Sutskever 和 Hinton 提出的 AlexNet 在 ImageNet 大规模视觉识别挑战赛(ILSVRC)中以显著优势夺冠,大幅降低了图像分类的错误率,标志着深度卷积网络在计算机视觉中的复兴。8989ImageNet Classification with Deep Convolutional Neural Networkspapers.nips.cc前往参考资料 ↓在新标签页中打开
循环神经网络(Recurrent Neural Network, RNN)通过循环连接处理序列数据,但标准 RNN 在长序列上存在梯度消失或梯度爆炸问题;长短期记忆网络(Long Short-Term Memory, LSTM)通过门控机制缓解了这一问题,由 Hochreiter 和 Schmidhuber 于 1997 年提出。9090Long Short-Term Memorydirect.mit.edu前往参考资料 ↓在新标签页中打开
Transformer 架构由 Vaswani 等人于 2017 年提出,完全基于自注意力机制(Self-Attention)而摒弃循环和卷积结构,成为后续大规模预训练语言模型的基础架构。9191Attention Is All You Needpapers.nips.cc前往参考资料 ↓在新标签页中打开
残差网络(Residual Network, ResNet)由 He 等人于 2016 年提出,通过引入恒等捷径连接(identity shortcut)缓解深层网络的退化问题,使得训练上百层甚至上千层的网络成为可能。9292Deep Residual Learning for Image Recognitionieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
深度神经网络通常使用随机梯度下降(SGD)及其变体(如 Adam、RMSProp)进行优化,并通过 Dropout、批归一化(Batch Normalization)等技术来正则化和加速训练。4747Adam: A Method for Stochastic Optimizationarxiv.org前往参考资料 ↓在新标签页中打开|9393Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shiftarxiv.org前往参考资料 ↓在新标签页中打开
神经网络按结构可分为前馈网络(如多层感知机 MLP)、卷积网络、循环网络、注意力网络等;按学习范式可分为监督学习、无监督学习和强化学习下的网络模型。8787Deep Learningnature.com前往参考资料 ↓在新标签页中打开
典型任务
分类与回归
在监督学习中,分类任务的目标是学习一个从输入特征到离散类别标签的映射;模型在训练阶段从带标签样本中拟合这一映射,在预测阶段把新样本判归某一类别。9595A Non-technical Introduction to Machine Learninglink.springer.com前往参考资料 ↓在新标签页中打开
回归任务的目标是学习一个从输入特征到连续数值输出的映射,例如预测房价、温度或某种生理指标的具体数值,而不是把样本划入有限个类别。9595A Non-technical Introduction to Machine Learninglink.springer.com前往参考资料 ↓在新标签页中打开
分类与回归共享同一套监督学习框架:都需要带标签的训练数据、一个参数化的假设空间以及一个衡量预测误差的损失函数,区别主要在于输出变量的类型(离散标签还是连续数值)以及由此带来的损失函数与评估指标选择。9595A Non-technical Introduction to Machine Learninglink.springer.com前往参考资料 ↓在新标签页中打开
特征提取是分类与回归任务中的常见前置步骤:把原始输入(例如脑部磁共振图像)转换为能有效表征输入的一组数值特征(例如不同解剖区域的体积),再交给分类器或回归器使用。9595A Non-technical Introduction to Machine Learninglink.springer.com前往参考资料 ↓在新标签页中打开
聚类与降维
聚类是无监督学习的核心任务之一,其目标是在没有标签信息的情况下,依据样本之间的相似性把数据点划分到不同的组(簇)中,使同组样本彼此相似、不同组样本彼此相异;其输出通常是每个样本所属的群组编号,例如把用户划分为不同的客户群体。9696人工智能之核心基础 机器学习 第八章 无监督学习概述-腾讯云开发者社区-腾讯云cloud.tencent.com.cn前往参考资料 ↓在新标签页中打开
K-Means 是实践中最常用的聚类算法之一,此外层次聚类(Hierarchical Clustering)与 DBSCAN 也是常见的聚类方法,其中 DBSCAN 能够发现任意形状的簇,而不像基于质心的方法那样倾向于产生球形簇。9696人工智能之核心基础 机器学习 第八章 无监督学习概述-腾讯云开发者社区-腾讯云cloud.tencent.com.cn前往参考资料 ↓在新标签页中打开
降维是无监督学习的另一核心任务,其目标是把高维数据(例如上千个特征)压缩到低维空间(例如二维或三维),同时尽量保留数据中的重要信息;典型用途包括数据可视化、去噪以及加速后续模型的训练。9696人工智能之核心基础 机器学习 第八章 无监督学习概述-腾讯云开发者社区-腾讯云cloud.tencent.com.cn前往参考资料 ↓在新标签页中打开
主成分分析(PCA)是代表性的线性降维方法;t-SNE 属于非线性降维方法,常用于高维数据的二维或三维可视化;UMAP 则是较新的非线性降维方法,通常被认为在速度与全局结构保持方面具有优势。9696人工智能之核心基础 机器学习 第八章 无监督学习概述-腾讯云开发者社区-腾讯云cloud.tencent.com.cn前往参考资料 ↓在新标签页中打开
生成建模
生成建模(generative modeling)是机器学习中的一类任务,其目标是学习数据分布本身,从而能够从该分布中采样生成新的数据样本,而不仅仅是对输入做出预测。9797Generative and Discriminative Classifiers: A Comparisoncs229.stanford.edu前往参考资料 ↓在新标签页中打开
生成建模与判别建模构成一对互补的建模范式:判别模型学习条件概率 P(y|x) 以区分不同类别,而生成模型学习联合概率 P(x,y) 或数据分布 P(x),从而可以用于生成新样本。9797Generative and Discriminative Classifiers: A Comparisoncs229.stanford.edu前往参考资料 ↓在新标签页中打开
变分自编码器(VAE)是一类基于变分推断的生成模型,它通过最大化证据下界(ELBO)来近似数据对数似然,从而学习潜在变量模型。9898Auto-Encoding Variational Bayesarxiv.org前往参考资料 ↓在新标签页中打开
生成对抗网络(GAN)由生成器和判别器两个神经网络组成,二者通过对抗训练相互博弈,生成器学习将随机噪声映射为逼真样本,判别器则试图区分真实样本与生成样本。9999Generative Adversarial Networksarxiv.org前往参考资料 ↓在新标签页中打开
扩散模型(diffusion model)是一类生成模型,它通过逐步向数据添加噪声的前向过程,以及学习逆转该噪声过程的逆向过程,来生成数据样本。100100Denoising Diffusion Probabilistic Modelsarxiv.org前往参考资料 ↓在新标签页中打开
自回归生成模型(如 Transformer 语言模型)通过将联合概率分解为条件概率的乘积,逐元素地生成序列数据,在文本生成等任务中表现突出。4949Attention Is All You Need (Section 5.3: Optimizer, warmup and decay)arxiv.org前往参考资料 ↓在新标签页中打开
评估与验证
训练集、验证集与测试集
在传统机器学习实践中,训练集、验证集与测试集通常由同一份原始数据集拆分而来:训练集用于拟合模型参数,验证集用于选择超参数与特征,测试集用于对最终模型给出一次性的性能估计。103103数据集:拆分原始数据集 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开|104104scikit-learn 邮件列表讨论:训练集/验证集/测试集的划分与模型选择mail.python.org前往参考资料 ↓在新标签页中打开
测试集必须与训练所用样本不同,因为用训练时见过的样本来评估模型,无法证明模型对未见数据的适用性;只有用独立样本评估,才能反映泛化能力。103103数据集:拆分原始数据集 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开
若反复用同一个测试集评估模型、并依据其结果反复调整超参数与特征,模型会不知不觉地拟合测试集的特性,使测试集失去作为独立评估依据的作用,这与“为考试而教”的类比相似。103103数据集:拆分原始数据集 | Machine Learning | Google for Developersdevelopers.google.com前往参考资料 ↓在新标签页中打开
一种常见做法是:只划分训练集与测试集,在训练集内部用 k 折交叉验证完成模型选择,最后在从未接触过的测试集上做一次最终性能估计。104104scikit-learn 邮件列表讨论:训练集/验证集/测试集的划分与模型选择mail.python.org前往参考资料 ↓在新标签页中打开
交叉验证
交叉验证是一种模型评估与选择方法:把训练数据划分为若干折(fold),轮流以其中一折作为验证集、其余折作为训练集,重复训练与评估,最后对各折的评估指标取平均(或汇总),以估计模型在未见数据上的泛化性能。105105Data splits and cross-validation in automated machine learning - Azure Machine Learninglearn.microsoft.com前往参考资料 ↓在新标签页中打开
在自动化机器学习(AutoML)场景中,交叉验证被用作子回合(子模型)的验证手段:每个候选模型都要通过计算质量指标(如加权 AUC、准确率等)来验证,指标由模型预测与验证数据中已观测的真实标签比较得出。105105Data splits and cross-validation in automated machine learning - Azure Machine Learninglearn.microsoft.com前往参考资料 ↓在新标签页中打开
Azure Machine Learning 的自动化 ML 文档把数据划分选项区分为训练/验证划分与交叉验证设置两类,并说明自动化 ML 实验会自动执行模型验证,即验证过程由平台按配置自动完成,而非由用户手工逐折执行。105105Data splits and cross-validation in automated machine learning - Azure Machine Learninglearn.microsoft.com前往参考资料 ↓在新标签页中打开
交叉验证与单一的训练/验证划分是两种并列的验证配置方式:前者在多个折上重复评估并汇总,后者只在一个固定划分上评估一次,因此交叉验证通常能给出更稳定的性能估计,但计算开销随折数成倍增加。105105Data splits and cross-validation in automated machine learning - Azure Machine Learninglearn.microsoft.com前往参考资料 ↓在新标签页中打开
常用评价指标
在分类与预测任务中,误差率分析与准确度评估是评价模型性能的两类基本分析手段;误差率分析有助于简化模型比较、提供可解释性并指导后续改进。108108FEPP: Advancing Software Risk Prediction in Requirements Engineering Through Innovative Rule Extraction and Multi-Class Integrationieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
准确度(accuracy)与 F1 分数是分类模型常用的评价指标,实践中常与资源开销类指标(如平均耗时、CPU 占用率)一起纳入综合评分函数,用于对模型或系统的整体性能做统一评估。106106CN118586765A - A quality management risk control method and system based on big data - Google Patentspatents.google.com前往参考资料 ↓在新标签页中打开
对回归类模型,常用的评价指标包括决定系数 R²、均方误差 MSE 以及平均相对偏差百分比 MRD% 等;同一模型在训练集、验证集与测试集上的指标值往往并不一致,需分阶段分别报告。107107Table 1 Metrics for evaluating ML models: analysis of model effectiveness across training, validation, and testing phases.nature.com前往参考资料 ↓在新标签页中打开
评价指标在训练、验证与测试三个阶段上的取值差异可以反映模型的泛化状况:例如在决策树等模型中,训练集上 R² 可达 1.0000、MSE 为 0.0000,而验证集与测试集上 R² 明显下降、MSE 上升,提示存在过拟合。107107Table 1 Metrics for evaluating ML models: analysis of model effectiveness across training, validation, and testing phases.nature.com前往参考资料 ↓在新标签页中打开
过拟合与欠拟合
过拟合指模型在训练数据上表现很好、但在未见过的新数据上表现差的现象,其本质是模型把训练数据中的噪声或偶然特征也学了进去,导致泛化能力下降。109109Machine Learningcs.cmu.edu前往参考资料 ↓在新标签页中打开
在偏差-方差分解框架下,欠拟合对应高偏差,过拟合对应高方差;随着模型复杂度增加,偏差下降而方差上升,测试误差呈先降后升的 U 形曲线。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开
训练集、验证集与测试集的划分是诊断过拟合与欠拟合的基本手段:训练误差低而验证/测试误差高提示过拟合,两者都高提示欠拟合。109109Machine Learningcs.cmu.edu前往参考资料 ↓在新标签页中打开
正则化是抑制过拟合的常用手段,包括 L1(Lasso)与 L2(岭回归)惩罚项,通过在损失函数中加入参数范数惩罚来限制模型复杂度。110110Regression Shrinkage and Selection via the Lassojstor.org前往参考资料 ↓在新标签页中打开
早停(early stopping)通过在验证集误差开始上升时停止训练来防止过拟合,是一种无需修改损失函数的隐式正则化方法。111111Early Stopping — But When?link.springer.com前往参考资料 ↓在新标签页中打开
Dropout 在训练时随机丢弃一部分神经元,可视为一种模型集成式的正则化,能有效缓解深层神经网络的过拟合。112112Dropout: A Simple Way to Prevent Neural Networks from Overfittingjmlr.org前往参考资料 ↓在新标签页中打开
数据增强通过对训练样本做标签保持的变换(如图像翻转、裁剪、颜色扰动)扩充数据多样性,是计算机视觉中缓解过拟合的常用手段。8989ImageNet Classification with Deep Convolutional Neural Networkspapers.nips.cc前往参考资料 ↓在新标签页中打开
交叉验证(如 k 折交叉验证)通过轮换训练集与验证集来更稳定地估计泛化误差,在样本量有限时比单次留出法更可靠。113113A Study of Cross-Validation and Bootstrap for Accuracy Estimation and Model Selectionijcai.org前往参考资料 ↓在新标签页中打开
学习曲线(以训练样本量为横轴、误差为纵轴)可用于判断模型处于欠拟合还是过拟合状态:两条曲线收敛且误差都高为欠拟合,训练误差低而验证误差高且差距大为过拟合。109109Machine Learningcs.cmu.edu前往参考资料 ↓在新标签页中打开
现代深度学习中存在“双下降”(double descent)现象:当模型参数量超过训练样本数后,测试误差可能再次下降,这与经典 U 形偏差-方差曲线并不完全一致。114114Reconciling modern machine-learning practice and the classical bias–variance trade-offpnas.org前往参考资料 ↓在新标签页中打开
对立说法有研究指出双下降现象在部分设置下可复现,但其普适性与理论解释仍存在争议,经典偏差-方差权衡在多数实际场景中仍是有效的指导框架。2828Understanding deep learning requires rethinking generalizationarxiv.org前往参考资料 ↓在新标签页中打开
数据与工程实践
特征工程
特征工程指从原始数据中提取和转换变量,构造出可供机器学习模型在训练与推理阶段使用的输入特征;其流程通常包括数据获取与清洗,随后是特征创建与存储。115115什麼是特徵工程?- 特徵工程說明 - AWSaws.amazon.com前往参考资料 ↓在新标签页中打开
模型特征是机器学习在训练和推理期间用于预测的输入,模型精度有赖于特征的精确集合与组合;例如在音乐播放列表推荐应用中,特征可能包括歌曲评分、此前听过的歌曲以及听歌时长。115115什麼是特徵工程?- 特徵工程說明 - AWSaws.amazon.com前往参考资料 ↓在新标签页中打开
特征工程被视为帮助模型理解数据集的方式;机器学习从业者往往在评估、清理和转换数据上投入的时间多于构建模型本身,因此数据准备与特征工程是机器学习课程中需要重点覆盖的内容。116116使用數值資料 | Machine Learning | Google for Developersdevelopers.google.cn前往参考资料 ↓在新标签页中打开
特征工程具有挑战性,因为它同时涉及数据分析、业务领域知识和一定直觉;实践中容易一上来就使用手头可用的数据,而更稳妥的做法是先与领域专家交流、开展头脑风暴和第三方调研,明确究竟需要哪些数据,否则可能遗漏重要的预测变量。115115什麼是特徵工程?- 特徵工程說明 - AWSaws.amazon.com前往参考资料 ↓在新标签页中打开
数据获取之所以繁琐,是因为数据分散在笔记本电脑、数据仓库、云端、应用内部和各类设备等多个来源,连接方式各异,数据量呈指数级增长且格式与类型因来源而异,例如视频数据与表格数据就很难直接一起使用。115115什麼是特徵工程?- 特徵工程說明 - AWSaws.amazon.com前往参考资料 ↓在新标签页中打开
数据预处理
在机器学习项目中,数据准备通常被划分为两项主要工作:数据清理(识别并缓解数据中影响其机器学习可用性的问题)与特征工程及预处理(选取并转换适合模型训练的特征)。117117Prepare data for machine learning - Traininglearn.microsoft.com前往参考资料 ↓在新标签页中打开
数据清理需要处理的典型问题包括不完整数据,即记录中个别字段缺失、通常以 NULL 等标记表示的情况。117117Prepare data for machine learning - Traininglearn.microsoft.com前往参考资料 ↓在新标签页中打开
Google 的机器学习课程指出,机器学习从业者在评估、清理与转换数据上投入的时间多于构建模型本身,并据此把数据准备与特征工程列为课程的重点单元。116116使用數值資料 | Machine Learning | Google for Developersdevelopers.google.cn前往参考资料 ↓在新标签页中打开
数据准备与特征工程的目的,是帮助模型正确理解数据集,从而对新数据点作出正确预测;因此构建数据集与转换数据被视为取得正确预测结果的前提步骤。116116使用數值資料 | Machine Learning | Google for Developersdevelopers.google.cn前往参考资料 ↓在新标签页中打开
数值数据指以整数或浮点值表示、可加总、可计数、有顺序的数据;而邮政编码这类由数字组成但代表地理类别的标识,在机器学习中应作为类别型数据处理,而非数值型数据。116116使用數值資料 | Machine Learning | Google for Developersdevelopers.google.cn前往参考资料 ↓在新标签页中打开
模型选择与调参
模型选择与调参的核心理论依据是误差分解:模型的期望误差可分解为偏差(bias)、方差(variance)与不可约噪声三部分,偏差刻画估计值的平均落点与真值的距离,方差刻画估计值在不同训练集上的分散程度。理解误差来源,才能有针对性地选择改进手段,而不是盲目试错。120120Where does the error come from?raw.githubusercontent.com前往参考资料 ↓在新标签页中打开
偏差与方差之间存在权衡:模型越复杂,函数集合的搜索空间越大,方差随之上升;而加入正则化会缩小函数集合的范围、使曲线更平滑,方差下降,但若缩小后的空间不再包含目标函数,偏差就会变大。因此调参本质上是在偏差与方差之间寻找平衡点。120120Where does the error come from?raw.githubusercontent.com前往参考资料 ↓在新标签页中打开
在企业级实践中,调参通常针对具体模型的关键超参数进行,例如梯度提升树类模型会调整树的最大深度(max_depth)与行采样比例(subsample)等;有案例报告通过贝叶斯优化确定 max_depth=6、subsample=0.8,使模型 AUC 提升 0.07。119119机器学习算法深度实战:企业级开发全链路解析cloud.baidu.com前往参考资料 ↓在新标签页中打开
大数据与分布式训练
大数据通常以“3V”或“4V”刻画:数据量(Volume)、多样性(Variety)、速度(Velocity),以及常被补充的准确性/真实性(Veracity);这些维度共同决定了传统单机内存计算与关系型数据库难以直接承载的规模与形态。121121The 3V's of Big Data: Volume, Velocity, Varietygartner.com前往参考资料 ↓在新标签页中打开
Google 在 2003 年发表的 GFS 论文与 2004 年发表的 MapReduce 论文,奠定了“把计算搬到数据所在节点、以廉价商用机器横向扩展”的分布式数据处理范式,成为后续 Hadoop 生态的直接思想来源。122122The Google File Systemresearch.google前往参考资料 ↓在新标签页中打开|123123MapReduce: Simplified Data Processing on Large Clustersresearch.google前往参考资料 ↓在新标签页中打开
Apache Hadoop 由 HDFS(分布式文件系统)与 MapReduce(批处理计算模型)两大核心组成,其开源实现使 MapReduce 范式从 Google 内部系统扩散为工业界通用基础设施。124124Apache Hadoophadoop.apache.org前往参考资料 ↓在新标签页中打开
Apache Spark 以弹性分布式数据集(RDD)为核心抽象,通过在内存中缓存中间结果并保留血统(lineage)信息支持容错,在迭代式机器学习与交互式查询等场景中相较 MapReduce 显著减少磁盘 I/O。125125Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computingusenix.org前往参考资料 ↓在新标签页中打开
Spark 的 MLlib 将分类、回归、聚类、协同过滤与特征处理等常用机器学习算法实现为分布式版本,使模型训练可以直接在集群上对大规模数据集进行,而不必先降采样到单机可处理规模。126126MLlib: Machine Learning Libraryspark.apache.org前往参考资料 ↓在新标签页中打开
参数服务器(Parameter Server)架构把模型参数存放在一组服务器节点上,工作节点只负责计算梯度/更新并与参数服务器通信,从而支持超出单机内存的模型规模与大量工作节点的异步训练;李沐等人 2014 年的论文系统化了这一架构。127127Scaling Distributed Machine Learning with the Parameter Serverusenix.org前往参考资料 ↓在新标签页中打开
TensorFlow 从 1.x 起提供分布式策略(如 MirroredStrategy、MultiWorkerMirroredStrategy),支持在单机多卡与多机多卡之间以数据并行方式同步训练同一模型,并通过 all-reduce 等集合通信聚合梯度。128128Distributed training with TensorFlowtensorflow.org前往参考资料 ↓在新标签页中打开
PyTorch 通过 DistributedDataParallel(DDP)实现多进程数据并行:每个进程持有完整模型副本、处理不同的数据分片,并在反向传播后对梯度做 all-reduce 同步;官方文档将其列为多 GPU 训练的首选方案。129129Distributed Data Parallelpytorch.org前往参考资料 ↓在新标签页中打开
Horovod 是 Uber 开源的分布式深度学习训练框架,最初为 TensorFlow 设计,采用 ring-allreduce 通信策略,并已扩展到 PyTorch、MXNet 等框架,用于在多 GPU/多机环境下降低梯度同步的通信开销。130130Horovod: Distributed Training Framework for TensorFlow, Keras, PyTorch, and Apache MXNetgithub.com前往参考资料 ↓在新标签页中打开
数据并行在模型参数规模超过单卡显存时会失效,因此出现了模型并行与流水线并行;Megatron-LM 提出层内张量并行方案,可在多 GPU 上训练具有数十亿参数级别的 Transformer 模型。131131Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelismarxiv.org前往参考资料 ↓在新标签页中打开
ZeRO(Zero Redundancy Optimizer)通过把优化器状态、梯度和参数分片到不同数据并行进程上,消除了数据并行中的显存冗余,使在有限显存下训练更大模型成为可能;相关实现集成于 DeepSpeed 并已开源。132132ZeRO: Memory Optimizations Toward Training Trillion Parameter Modelsarxiv.org前往参考资料 ↓在新标签页中打开
混合精度训练(如 FP16 配合损失缩放、或 BF16)在保持数值稳定性的前提下减少显存占用并提升吞吐,已成为大规模分布式训练的常规工程手段;NVIDIA 的 Apex 与 PyTorch 的 AMP 均提供相应支持。133133Mixed Precision Trainingarxiv.org前往参考资料 ↓在新标签页中打开
梯度累积是一种以时间换显存的常用技巧:在多个小批次上分别前向与反向传播、累加梯度后再统一更新参数,从而在受限显存下模拟更大的有效批大小。134134Gradient Accumulationhuggingface.co前往参考资料 ↓在新标签页中打开
分布式训练中,数据加载与预处理常成为瓶颈;TensorFlow 的 tf.data 与 PyTorch 的 DataLoader 均提供多进程/预取机制,用于让输入流水线与 GPU 计算重叠,避免加速器空转。135135tf.data: Build TensorFlow input pipelinestensorflow.org前往参考资料 ↓在新标签页中打开
大规模训练的可复现性依赖对数据版本、代码版本、随机种子与超参数的完整记录;MLflow、DVC 等工具被用于对数据与实验进行版本化管理,以支撑工程实践中的可追溯性。136136MLflow: A Platform for the Machine Learning Lifecyclemlflow.org前往参考资料 ↓在新标签页中打开
应用领域
计算机视觉
计算机视觉是机器学习最早、最成熟的应用领域之一:它把图像或视频像素作为输入,用学习到的模型完成分类、检测、分割等任务,从而替代人工目视判断。139139Image Processing: a Review on Industrial Applications - Repository of the Academy's Libraryreal.mtak.hu前往参考资料 ↓在新标签页中打开
在工业自动化中,图像处理与基于深度学习的视觉系统已成为关键技术,支撑质量控制、机器人操作与过程监控等环节。139139Image Processing: a Review on Industrial Applications - Repository of the Academy's Libraryreal.mtak.hu前往参考资料 ↓在新标签页中打开
自然语言处理
自然语言处理(NLP)是机器学习最早、最持续的应用领域之一:从20世纪90年代基于统计的机器翻译与词性标注,到2010年代基于神经网络的词向量与序列模型,再到2018年以后的预训练语言模型,NLP的方法演进几乎与机器学习主流范式的更替同步。140140Speech and Language Processing (3rd edition draft)web.stanford.edu前往参考资料 ↓在新标签页中打开|141141Natural Language Processing (almost) from Scratchjmlr.org前往参考资料 ↓在新标签页中打开
在词法、句法层面,机器学习被广泛用于中文分词、词性标注、命名实体识别与依存句法分析;这些任务通常被建模为序列标注问题,条件随机场(CRF)与双向长短期记忆网络(BiLSTM)曾是长期的主流方案,近年则普遍由预训练语言模型微调取代。142142Neural Architectures for Named Entity Recognitionarxiv.org前往参考资料 ↓在新标签页中打开|143143BERT: Pre-training of Deep Bidirectional Transformers for Language Understandingarxiv.org前往参考资料 ↓在新标签页中打开
机器翻译是NLP中商业化程度最高的应用之一:基于神经网络的机器翻译(NMT)自2016年前后取代统计机器翻译成为主流,Google于2016年将神经机器翻译系统上线到Google翻译,覆盖多种语言对。144144Google's Neural Machine Translation System: Bridging the Gap between Human and Machine Translationarxiv.org前往参考资料 ↓在新标签页中打开|145145A Neural Network for Machine Translation, at Production Scaleresearch.google前往参考资料 ↓在新标签页中打开
2018年提出的BERT采用双向Transformer编码器与掩码语言模型预训练目标,在11项自然语言理解基准上取得当时的最佳结果,确立了“预训练+微调”的范式,并直接推动了此后NLP应用的大规模落地。143143BERT: Pre-training of Deep Bidirectional Transformers for Language Understandingarxiv.org前往参考资料 ↓在新标签页中打开
大规模生成式语言模型已成为NLP应用的新形态:GPT-3以1750亿参数展示了少样本上下文学习能力,ChatGPT则把对话式问答、文本摘要、写作辅助等能力直接交付给终端用户,使NLP从后台组件变成面向公众的产品界面。146146Language Models are Few-Shot Learnersarxiv.org前往参考资料 ↓在新标签页中打开|147147Introducing ChatGPTopenai.com前往参考资料 ↓在新标签页中打开
信息抽取与知识库构建是NLP的另一类典型应用:从新闻、专利、生物医学文献等非结构化文本中抽取实体、关系与事件,用于构建知识图谱、支撑检索与问答系统;相关评测(如TACRED关系抽取、ACE事件抽取)长期作为该方向的标准基准。148148Position-aware Attention and Supervised Data Improve Slot Fillingaclanthology.org前往参考资料 ↓在新标签页中打开|149149The Automatic Content Extraction (ACE) Program: Tasks, Data, and Evaluationaclanthology.org前往参考资料 ↓在新标签页中打开
情感分析与观点挖掘被广泛用于商品评论、社交媒体舆情与客户服务:基于监督学习的文本分类模型可以判定评论的情感极性,细粒度方面级情感分析则进一步识别评价所针对的属性。150150Thumbs Up or Thumbs Down? Semantic Orientation Applied to Unsupervised Classification of Reviewsaclanthology.org前往参考资料 ↓在新标签页中打开
问答与检索增强是NLP与信息检索交叉的应用方向:开放域问答系统结合文档检索与神经阅读器来回答问题,检索增强生成(RAG)把外部文档检索接入语言模型,以缓解模型知识过时与幻觉问题。151151Reading Wikipedia to Answer Open-Domain Questionsarxiv.org前往参考资料 ↓在新标签页中打开|152152Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasksarxiv.org前往参考资料 ↓在新标签页中打开
语音与文本的接口同样依赖NLP方法:自动语音识别把声学信号转写为文本后,需要语言模型与文本规范化模块参与纠错和格式化;反向的文本转语音则依赖文本分析与韵律预测。153153Deep Speech 2: End-to-End Speech Recognition in English and Mandarinarxiv.org前往参考资料 ↓在新标签页中打开
在工业界,NLP被用于搜索排序、广告相关性、内容审核、智能客服与文档处理等场景;这些系统通常以预训练模型为底座,再通过领域数据微调或提示工程适配具体业务。154154Universal Language Model Fine-tuning for Text Classificationarxiv.org前往参考资料 ↓在新标签页中打开
推荐系统
推荐系统是机器学习最广泛部署的应用之一,其核心任务是根据用户历史行为与物品特征,预测用户对未见物品的偏好,并据此生成个性化排序列表。158158Recommender Systems: An Introductioncambridge.org前往参考资料 ↓在新标签页中打开
协同过滤是推荐系统的经典范式,分为基于内存的方法(如用户/物品邻域模型)和基于模型的方法(如矩阵分解)。矩阵分解通过将用户-物品评分矩阵分解为低维隐向量,显著提升了 Netflix Prize 竞赛中的预测精度。159159Matrix Factorization Techniques for Recommender Systemsieeexplore.ieee.org前往参考资料 ↓在新标签页中打开|160160The Netflix Prizenetflixprize.com前往参考资料 ↓在新标签页中打开
Netflix Prize 竞赛(2006–2009)要求参赛者将电影评分预测的 RMSE 在 Netflix 基线算法基础上提升 10%,最终由 BellKor's Pragmatic Chaos 团队以集成方法达成目标,推动了矩阵分解与集成学习在推荐系统中的普及。160160The Netflix Prizenetflixprize.com前往参考资料 ↓在新标签页中打开|161161BellKor's Pragmatic Chaos wins $1M Netflix Prizenytimes.com前往参考资料 ↓在新标签页中打开
深度学习推荐模型(如 Neural Collaborative Filtering、Wide & Deep、DeepFM)通过端到端学习用户与物品的高阶特征交互,在工业级推荐系统中逐步取代了传统矩阵分解,成为主流架构。162162Neural Collaborative Filteringdl.acm.org前往参考资料 ↓在新标签页中打开|163163DeepFM: A Factorization-Machine based Neural Network for CTR Predictionijcai.org前往参考资料 ↓在新标签页中打开
工业推荐系统通常采用多阶段级联架构:召回阶段从海量物品中快速筛选候选集,排序阶段对候选集进行精细打分,重排阶段考虑多样性与业务规则。该架构在 YouTube、阿里巴巴等大规模系统中得到验证。164164Deep Neural Networks for YouTube Recommendationsdl.acm.org前往参考资料 ↓在新标签页中打开|165165Deep Learning based Recommender System: A Survey and New Perspectivesdl.acm.org前往参考资料 ↓在新标签页中打开
推荐系统在电商、流媒体、新闻资讯、社交网络和广告投放等领域有广泛应用。例如,Amazon 使用物品到物品的协同过滤进行商品推荐,YouTube 使用深度神经网络进行视频推荐。164164Deep Neural Networks for YouTube Recommendationsdl.acm.org前往参考资料 ↓在新标签页中打开|166166Amazon.com Recommendations: Item-to-Item Collaborative Filteringieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
推荐系统面临冷启动、数据稀疏性、可扩展性和用户隐私等挑战。基于内容的推荐和混合推荐方法常被用于缓解冷启动问题,而联邦学习等隐私保护技术正被探索用于推荐场景。158158Recommender Systems: An Introductioncambridge.org前往参考资料 ↓在新标签页中打开|167167Federated Learning for Recommender Systems: A Surveydl.acm.org前往参考资料 ↓在新标签页中打开
推荐系统的评估通常采用离线指标(如 Precision@K、Recall@K、NDCG、AUC)和在线 A/B 测试。离线评估与在线效果之间常存在不一致,因此工业界强调在线实验的最终验证。168168Evaluating Recommendation Systemslink.springer.com前往参考资料 ↓在新标签页中打开|169169Offline Evaluation of Recommender Systems: A Surveydl.acm.org前往参考资料 ↓在新标签页中打开
科学与工程
在科学与工程领域,机器学习正被用于与传统的基于物理的建模方法相结合,以求解复杂的科学与工程问题;这一方向已形成一定共识,即此类问题需要能够把物理建模与机器学习技术整合起来的新方法。172172NSTL国家科技图书文献中心cs.nstl.gov.cn前往参考资料 ↓在新标签页中打开
将科学知识与机器学习整合的研究覆盖了工程系统与环境系统等应用场景,相关综述按应用领域对这类技术做了结构化梳理。172172NSTL国家科技图书文献中心cs.nstl.gov.cn前往参考资料 ↓在新标签页中打开
机器学习在科学与工程中的应用并不限于替代物理模型,更多表现为与领域知识、推理过程结合,例如在图像理解任务中把知识与推理机制引入模型。172172NSTL国家科技图书文献中心cs.nstl.gov.cn前往参考资料 ↓在新标签页中打开
局限与争议
可解释性
可解释性(explainability)指机器学习模型对其预测结果给出人类可理解说明的能力,通常与「可解释人工智能」(explainable AI, XAI)这一研究方向并列讨论;它关注的是模型为何给出某一输出,而非仅仅输出是什么。173173Explainable AI reveals Clever Hans effects in unsupervised learning modelsnature.com前往参考资料 ↓在新标签页中打开
可解释性被视为机器学习在高风险领域部署时的关键约束之一:在医疗等场景中,若模型比现有替代方案更不敏感、更不特异或更不精确,即便整体准确率更高,也可能带来可避免的发病与死亡风险,因此对不透明模型的偏好本身即构成风险。174174Table 5.pmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
围绕可解释性存在明确的公开争论:一方主张准确性与可解释性之间存在权衡,降低不透明度可能要求改用更简单但精度较低的模型,因而可解释性并非总是必要;另一方则认为在临床等高风险决策中,使用比现有替代方案更不准确或不透明的模型会直接危及患者安全,可解释性不可省略。174174Table 5.pmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
可解释性技术不仅用于事后解释,也被用于检验模型是否依赖虚假相关:对无监督表示学习与异常检测模型应用专门开发的 XAI 方法后发现,「聪明汉斯效应」(Clever Hans effect)——模型凭借与任务无关的线索做出准确预测——在无监督学习中普遍存在。173173Explainable AI reveals Clever Hans effects in unsupervised learning modelsnature.com前往参考资料 ↓在新标签页中打开
数据偏见与公平性
机器学习模型在代表性不足的少数群体子群中通常表现更差,其上游成因包括训练数据中的代表性不足、差异化的医疗服务可及性以及潜在的测量误差;这一判断在医疗健康 AI 的预测建模研究中被作为基本预期提出。175175Paradoxical inflation of prediction model performance measures in minority patient subgroups: the role of upstream biasnature.com前往参考资料 ↓在新标签页中打开
在一项预测术后持续性阿片类药物使用的已发表模型中,研究者观察到黑人患者(占样本不足 5%)的模型性能显著高于白人患者,与「少数群体子群性能更差」的通常预期相反;该研究使用子群匹配方法(1B-1W 与 1B-2W 匹配)考察患者特征差异是否贡献了所观察到的性能差异,并进行了重复验证。175175Paradoxical inflation of prediction model performance measures in minority patient subgroups: the role of upstream biasnature.com前往参考资料 ↓在新标签页中打开
对抗脆弱性
对抗脆弱性指机器学习模型(尤其是深度神经网络)在输入被施加人眼往往难以察觉的微小扰动后,输出发生显著错误改变的现象;这类被刻意构造的输入称为对抗样本。它是深度学习缺乏理论理解与可解释性的一个具体表现,被综述性文献列为该领域的「臭名昭著的问题」之一。176176Transgressing the boundaries: towards a rigorous understanding of deep learning and its (non-)robustnessar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
对抗脆弱性并非只出现在图像分类中:由于深度模型在高维输入空间中普遍存在对输入梯度的敏感性,语音识别、自动驾驶感知等以深度网络为关键技术的应用同样面临被对抗扰动误导的风险,因此该问题被视为部署层面的安全性议题而非单纯的实验室现象。176176Transgressing the boundaries: towards a rigorous understanding of deep learning and its (non-)robustnessar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
围绕对抗脆弱性的成因存在公开争论:一种观点认为它是高维输入下模型决策边界过于线性、对输入扰动敏感所导致的固有性质;另一种观点则强调它更多源于训练目标与数据分布(如缺乏对扰动的约束)而非模型类别的本质缺陷。两种解释在文献中并行存在,尚未形成统一结论。176176Transgressing the boundaries: towards a rigorous understanding of deep learning and its (non-)robustnessar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
算力与能耗
训练前沿机器学习模型所需的算力在2012年至2018年间呈指数级增长,OpenAI的分析显示该时期最大规模训练运行的算力每3.4个月翻一番,远快于摩尔定律的约每两年翻一番。177177AI and Computeopenai.com前往参考资料 ↓在新标签页中打开
大语言模型的训练成本已达到数百万至数千万美元量级:例如GPT-3(1750亿参数)的训练据估计耗资数百万美元,而后续更大规模模型的单次训练成本进一步上升至千万美元量级。146146Language Models are Few-Shot Learnersarxiv.org前往参考资料 ↓在新标签页中打开
对立说法部分研究者指出,公开报道的训练成本估算往往只计算GPU租用费用,未计入研发、数据清洗、失败实验与人力成本,实际总成本可能被显著低估或高估,不同估算方法之间差异可达数倍。183
训练一个大模型的能耗与碳排放可观:Strubell等(2019)估算,训练一个大型Transformer语言模型(含调参与架构搜索)的整个过程可排放约626,000磅二氧化碳当量,约相当于五辆汽车整个生命周期的排放量。178178Energy and Policy Considerations for Deep Learning in NLParxiv.org前往参考资料 ↓在新标签页中打开
机器学习模型的推理(部署使用)阶段能耗在总能耗中的占比正快速上升,部分大规模服务场景下推理能耗已超过训练能耗,成为数据中心能耗的主要来源。179179The Inference Cost of Search Disruption: Large Language Models as Costly Search Enginesarxiv.org前往参考资料 ↓在新标签页中打开
对立说法也有研究认为,由于训练是一次性投入而推理是持续投入,两者占比高度依赖于模型规模、服务请求量和硬件效率,不能一概而论;对许多中小规模应用而言训练能耗仍占主导。186
算力需求推动了专用硬件的发展,GPU、TPU等加速器成为训练深度模型的主流硬件;Google于2016年公开其张量处理单元(TPU),专为神经网络推理与训练设计。180180Google supercharges machine learning tasks with TPU custom chipcloud.google.com前往参考资料 ↓在新标签页中打开
算力集中带来准入壁垒争议:训练最先进模型需要大规模GPU集群和巨额资本支出,使得前沿研究日益集中于少数大型科技公司和资金充裕的实验室,学术界在算力竞赛中处于劣势。181181Computing Power and the Governance of Artificial Intelligencearxiv.org前往参考资料 ↓在新标签页中打开
对立说法另一种观点认为,算法效率的提升和开源模型(如LLaMA系列)的发布正在降低算力门槛,学术机构和中小团队仍可通过微调与高效训练方法参与前沿研究。189
教育与教材体系
在高等教育层面,机器学习通常作为计算机科学与人工智能方向的核心课程开设,典型先修要求包括线性代数、概率统计、微积分与程序设计,教材内容普遍覆盖监督学习、无监督学习、模型评估与正则化等模块。184184CS229: Machine Learning(课程主页)cs229.stanford.edu前往参考资料 ↓在新标签页中打开|1851856.036 Introduction to Machine Learning(课程主页)ocw.mit.edu前往参考资料 ↓在新标签页中打开
Tom M. Mitchell 于 1997 年出版的《Machine Learning》是机器学习领域最早的系统性教科书之一,书中给出的“学习”定义(程序在任务 T 上随经验 E 提升性能度量 P)长期被后续教材沿用。109109Machine Learningcs.cmu.edu前往参考资料 ↓在新标签页中打开
Christopher Bishop 的《Pattern Recognition and Machine Learning》(2006)以贝叶斯视角统一讲述模式识别与机器学习,是统计机器学习方向被广泛采用的进阶教材。2323Pattern Recognition and Machine Learninglink.springer.com前往参考资料 ↓在新标签页中打开
Hastie、Tibshirani 与 Friedman 合著的《The Elements of Statistical Learning》由 Springer 出版,其电子版在作者主页长期免费公开,被大量研究生课程列为参考书。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开
Goodfellow、Bengio 与 Courville 的《Deep Learning》(MIT Press,2016)全书在线公开,是深度学习方向引用最广的教科书之一,内容涵盖前馈网络、正则化、优化、卷积网络与循环网络等。3535Deep Learningdeeplearningbook.org前往参考资料 ↓在新标签页中打开
周志华的《机器学习》(清华大学出版社,2016)是国内高校采用最广的中文机器学习教材之一,因封面图案被读者称为“西瓜书”。186186《机器学习》(西瓜书)tup.tsinghua.edu.cn前往参考资料 ↓在新标签页中打开
李航的《统计学习方法》初版于 2012 年、第二版于 2019 年由清华大学出版社出版,以统计学习方法的统一框架讲解感知机、支持向量机、隐马尔可夫模型等方法,是国内统计机器学习方向的重要教材。187187《统计学习方法(第2版)》tup.tsinghua.edu.cn前往参考资料 ↓在新标签页中打开
Andrew Ng 在 Coursera 开设的《Machine Learning》课程是 MOOC 平台上注册人数最多的机器学习入门课程之一,其 2022 年改版课程改用 Python 并覆盖监督学习与无监督学习的基础内容。188188Machine Learning Specializationcoursera.org前往参考资料 ↓在新标签页中打开
fast.ai 的《Practical Deep Learning for Coders》采取“先实践后理论”的自顶向下教学路线,与多数教材“先数学后应用”的编排顺序相反,课程材料以 Jupyter Notebook 形式公开。189189Practical Deep Learning for Coderscourse.fast.ai前往参考资料 ↓在新标签页中打开
Kaggle 的 Learn 系列微课程与竞赛平台被大量课程用作机器学习的实践环节,提供结构化数据集与可复现的 Notebook 环境。190190Kaggle Learnkaggle.com前往参考资料 ↓在新标签页中打开
《统计学习基础》与《深度学习》等教材的免费在线版本降低了学习门槛,但也带来版本更新与纸质版内容不同步的问题,读者需注意所引页码与版次。2222The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.)hastie.su.domains前往参考资料 ↓在新标签页中打开|3535Deep Learningdeeplearningbook.org前往参考资料 ↓在新标签页中打开
关于机器学习课程应先讲授数学基础还是先开展项目实践,教学界存在明确分歧:一派主张先夯实线性代数与概率论再进入建模,另一派主张先做项目、按需补数学。189189Practical Deep Learning for Coderscourse.fast.ai前往参考资料 ↓在新标签页中打开
对立说法以传统教材与多数高校课程为代表的一派认为,缺乏数学基础会导致学习者只能调包、无法理解模型行为,因此应先修线性代数与概率统计再学习算法。184184CS229: Machine Learning(课程主页)cs229.stanford.edu前往参考资料 ↓在新标签页中打开|2323Pattern Recognition and Machine Learninglink.springer.com前往参考资料 ↓在新标签页中打开
| 名称 | 作者/机构 | 年份 | 定位 |
|---|---|---|---|
| Machine Learning | Tom M. Mitchell | 1997 | 早期系统性教科书 |
| Pattern Recognition and Machine Learning | Christopher Bishop | 2006 | 贝叶斯视角进阶教材 |
| The Elements of Statistical Learning | Hastie, Tibshirani, Friedman | 2009(第2版) | 统计学习研究生参考书 |
| 《统计学习方法》 | 李航 | 2012(初版)/2019(第2版) | 统计学习方法中文教材 |
| 《机器学习》 | 周志华 | 2016 | 中文通识教材 |
| Deep Learning | Goodfellow, Bengio, Courville | 2016 | 深度学习教科书 |
| Machine Learning(Coursera) | Andrew Ng / DeepLearning.AI | 2012(初版)/2022(改版) | MOOC 入门课程 |
| Practical Deep Learning for Coders | fast.ai | 2018 起持续更新 | 自顶向下实践课程 |
参考来源
- 1文档 General Machine Learning — A brief introduction of machine learning · ScienceDirect Topics · 2024-01-01 · 核验于 2026-10-22
- 2文档 机器学习(林霍尔姆著)内容提要 · 国防科技大学图书馆书目 · 2023-01-01 · 核验于 2026-10-22
- 3论文 Table 1 Categories of ML models · Cell Reports Physical Science (Cell Press) · 2023-01-01 · 核验于 2026-10-22
- 4文档 机器学习与人工智能(课程简介) · 国家高等教育智慧教育平台 / 中国大学MOOC · 2021-04-05 · 核验于 2026-10-22
- 5文档 大数据机器学习(课程简介) · 国家高等教育智慧教育平台 · 2026-09-09 · 核验于 2026-10-22
- 6文档 深度学习----科学智慧火花 · 科学智慧火花 · 2023-07-21 · 核验于 2026-10-22
- 7文档 Cornell Virtual Workshop > An Overview of AI > Machine Learning and Deep Learning > Functionality and Implementation · Cornell Virtual Workshop · 2023-01-01 · 核验于 2026-10-22
- 8文档 中国科普博览 · 中国科普博览 · 2019-03-26 · 核验于 2026-10-22
- 9文档 【《机器学习》周志华学习笔记1.5】~机器学习的“发展历程”-云社区-华为云 · 华为云社区 · 2020-12-28 · 核验于 2026-10-22
- 10论文 Learning representations by back-propagating errors · Nature, 323(6088): 533–536 · 1986-10-09 · 核验于 2026-10-22
- 11论文 Support-vector networks · Machine Learning, 20(3): 273–297 · 1995-09-01 · 核验于 2026-10-22
- 12论文 A training algorithm for optimal margin classifiers · Proceedings of the 5th Annual Workshop on Computational Learning Theory (COLT '92), pp. 144–152 · 1992-07-01 · 核验于 2026-10-22
- 13文档 The Nature of Statistical Learning Theory · Springer-Verlag, New York · 1995-01-01 · 核验于 2026-10-22
- 14论文 A decision-theoretic generalization of on-line learning and an application to boosting · Journal of Computer and System Sciences, 55(1): 119–139 · 1997-08-01 · 核验于 2026-10-22
- 15论文 A few useful things to know about machine learning · Communications of the ACM, 55(10): 78–87 · 2012-10-01 · 核验于 2026-10-22
- 16文档 Machine Learning (journal) — 期刊主页与创刊信息 · Springer · 1988-01-01 · 核验于 2026-10-22
- 17文档 图文详情——科普中国资源服务 · 科普中国 · 2019-08-12 · 核验于 2026-10-22
- 18文档 大模型应用之:人工智能技术演进-腾讯云开发者社区-腾讯云 · tencent.cn · 2025-07-26 · 核验于 2026-10-22
- 19文档 机器学习的发展与应用:从理论到现实-腾讯云开发者社区-腾讯云 · Tencent · 2025-12-20 · 核验于 2026-10-22
- 20文档 监督式学习 | Machine Learning | Google for Developers · Google for Developers · 2024-01-01 · 核验于 2026-10-22
- 21文档 机器学习模型 - Training · Learn Microsoft · 2026-03-26 · 核验于 2026-10-22
- 22文档 The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.) · Springer · 2009-02-01 · 核验于 2026-10-22
- 23文档 Pattern Recognition and Machine Learning · Springer · 2006-08-17 · 核验于 2026-10-22
- 24文档 Machine Learning: A Probabilistic Perspective · MIT Press · 2012-08-24 · 核验于 2026-10-22
- 25文档 Pattern Recognition and Machine Learning, Chapter 1: Introduction · Springer · 2006-08-17 · 核验于 2026-10-22
- 26文档 Foundations of Machine Learning (2nd ed.) · MIT Press · 2018-11-13 · 核验于 2026-10-22
- 27文档 Rademacher Complexity · Encyclopedia of Machine Learning and Data Mining, Springer · 2017-01-01 · 核验于 2026-10-22
- 28论文 Understanding deep learning requires rethinking generalization · ICLR 2017 / arXiv:1611.03530 · 2017-04-24 · 核验于 2026-10-22
- 29论文 Exploring Generalization in Deep Learning · NeurIPS 2017 / arXiv:1706.08947 · 2017-06-27 · 核验于 2026-10-22
- 30文档 Learning with Kernels: Support Vector Machines, Regularization, Optimization, and Beyond · MIT Press · 2001-12-14 · 核验于 2026-10-22
- 31文档 Bayesian Reasoning and Machine Learning · Cambridge University Press · 2012-02-01 · 核验于 2026-10-22
- 32论文 The Lack of A Priori Distinctions Between Learning Algorithms · Neural Computation 8(7) / Wolpert · 1996-10-01 · 核验于 2026-10-22
- 33论文 No Free Lunch Theorems for Optimization · IEEE Transactions on Evolutionary Computation 1(1) · 1997-04-01 · 核验于 2026-10-22
- 34论文 An Overview of Statistical Learning Theory · IEEE Transactions on Neural Networks 10(5) · 1999-09-01 · 核验于 2026-10-22
- 35文档 Deep Learning · MIT Press · 2016-11-18 · 核验于 2026-10-22
- 36文档 Pattern Recognition and Machine Learning · Springer · 2006-08-17 · 核验于 2026-10-22
- 37论文 A Tutorial on Support Vector Machines for Pattern Recognition · Data Mining and Knowledge Discovery, 2(2), 121–167 · 1998-06-01 · 核验于 2026-10-22
- 38文档 CS231n: Convolutional Neural Networks for Visual Recognition — Loss Functions · Stanford University · 2023-01-01 · 核验于 2026-10-22
- 39文档 Robust Regression and Outlier Detection · Wiley · 1987-01-01 · 核验于 2026-10-22
- 40文档 Huber loss — Wikipedia · Wikipedia · 2024-01-01 · 核验于 2026-10-22
- 41论文 Regularization and variable selection via the elastic net · Journal of the Royal Statistical Society: Series B, 67(2), 301–320 · 2005-04-01 · 核验于 2026-10-22
- 42文档 Why are deep neural networks hard to train? — Neural Networks and Deep Learning · Michael Nielsen · 2015-01-01 · 核验于 2026-10-22
- 43文档 Deep Learning (Adaptive Computation and Machine Learning series), Chapter 8: Optimization for Training Deep Models · MIT Press · 2016-11-18 · 核验于 2026-10-22
- 44文档 Convex Optimization · Cambridge University Press · 2004-03-08 · 核验于 2026-10-22
- 45论文 ADADELTA: An Adaptive Learning Rate Method · arXiv:1212.5701 · 2012-12-22 · 核验于 2026-10-22
- 46文档 Lecture 6.5 - rmsprop: Divide the gradient by a running average of its recent magnitude (Neural Networks for Machine Learning, Coursera) · University of Toronto / Coursera · 2012-01-01 · 核验于 2026-10-22
- 47论文 Adam: A Method for Stochastic Optimization · arXiv:1412.6980 · 2014-12-22 · 核验于 2026-10-22
- 48论文 On the Convergence of Adam and Beyond · ICLR 2018 / arXiv:1904.09237 · 2019-04-19 · 核验于 2026-10-22
- 49论文 Attention Is All You Need (Section 5.3: Optimizer, warmup and decay) · NeurIPS 2017 / arXiv:1706.03762 · 2017-06-12 · 核验于 2026-10-22
- 50论文 On the Limited Memory BFGS Method for Large Scale Optimization · Mathematical Programming, Springer · 1989-08-01 · 核验于 2026-10-22
- 51论文 Identifying and attacking the saddle point problem in high-dimensional non-convex optimization · NeurIPS 2014 / arXiv:1406.2572 · 2014-06-10 · 核验于 2026-10-22
- 52论文 Decoupled Weight Decay Regularization (AdamW) · ICLR 2019 / arXiv:1711.05101 · 2017-11-14 · 核验于 2026-10-22
- 53论文 Don't Decay the Learning Rate, Increase the Batch Size · ICLR 2018 / arXiv:1711.00489 · 2017-11-01 · 核验于 2026-10-22
- 54论文 Descending through a Crowded Valley — Benchmarking Deep Learning Optimizers · ICML 2021 / arXiv:2007.01547 · 2020-07-03 · 核验于 2026-10-22
- 55文档 过拟合:模型复杂性 | Machine Learning | Google for Developers · Google for Developers · 2024-01-01 · 核验于 2026-10-22
- 56文档 建立機器學習模型 - Training · Learn Microsoft · 2023-09-25 · 核验于 2026-10-22
- 57报道 图文详情 · 科普中国 · 2020-05-21 · 核验于 2026-10-22
- 58论文 Self-supervised Learning: Generative or Contrastive · IEEE Transactions on Knowledge and Data Engineering / arXiv:2006.08218 · 2020-06-15 · 核验于 2026-10-22
- 59文档 机器学习基础入门(第五篇):半监督学习与强化学习-腾讯云开发者社区-腾讯云 · tencent.cn · 2025-12-20 · 核验于 2026-10-22
- 60文档 Reinforcement Learning: An Introduction (2nd ed.) · MIT Press · 2018-11-13 · 核验于 2026-10-22
- 61文档 Reinforcement learning - Wikipedia · Wikipedia · 2024-06-01 · 核验于 2026-10-22
- 62文档 Markov decision process - Wikipedia · Wikipedia · 2024-06-01 · 核验于 2026-10-22
- 63文档 Q-learning - Wikipedia · Wikipedia · 2024-06-01 · 核验于 2026-10-22
- 64文档 Policy gradient methods - Wikipedia · Wikipedia · 2024-06-01 · 核验于 2026-10-22
- 65文档 Actor-critic - Wikipedia · Wikipedia · 2024-06-01 · 核验于 2026-10-22
- 66论文 Asynchronous Methods for Deep Reinforcement Learning · arXiv:1602.01783 · 2016-02-04 · 核验于 2026-10-22
- 67论文 Human-level control through deep reinforcement learning · Nature 518, 529–533 · 2015-02-25 · 核验于 2026-10-22
- 68论文 Playing Atari with Deep Reinforcement Learning · arXiv:1312.5602 · 2013-12-19 · 核验于 2026-10-22
- 69论文 Mastering the game of Go with deep neural networks and tree search · Nature 529, 484–489 · 2016-01-27 · 核验于 2026-10-22
- 70论文 Mastering the game of Go without human knowledge · Nature 550, 354–359 · 2017-10-18 · 核验于 2026-10-22
- 71论文 Proximal Policy Optimization Algorithms · arXiv:1707.06347 · 2017-07-20 · 核验于 2026-10-22
- 72论文 Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actor · arXiv:1801.01290 · 2018-01-04 · 核验于 2026-10-22
- 73论文 Training language models to follow instructions with human feedback · arXiv:2203.02155 · 2022-03-04 · 核验于 2026-10-22
- 74论文 Deep reinforcement learning from human preferences · arXiv:1706.03741 · 2017-06-12 · 核验于 2026-10-22
- 75论文 Concrete Problems in AI Safety · arXiv:1606.06565 · 2016-06-21 · 核验于 2026-10-22
- 76文档 Specification gaming examples in AI · DeepMind · 2020-04-01 · 核验于 2026-10-22
- 77论文 Deep Reinforcement Learning: An Overview · arXiv:1701.07274 · 2017-01-25 · 核验于 2026-10-22
- 78论文 Deep Reinforcement Learning that Matters · arXiv:1709.06560 · 2017-09-19 · 核验于 2026-10-22
- 79论文 Table 2 Review of supervised machine learning techniques. | Scientific Reports · Nature · 2024-12-02 · 核验于 2026-10-22
- 80文档 機器學習詞彙表:機器學習基礎知識 | Machine Learning | Google for Developers · Google for Developers · 2024-01-01 · 核验于 2026-10-22
- 81文档 机器学习必知必会10大算法 · 阿里云开发者社区 · 2024-08-27 · 核验于 2026-10-22
- 82文档 深入解析机器学习算法-腾讯云开发者社区-腾讯云 · tencent.cn · 2024-10-30 · 核验于 2026-10-22
- 83论文 Table 2 Brief schema of the machine learning methods applied in this study. · Nature · 2021-03-03 · 核验于 2026-10-22
- 84文档 CN118608167B - 一种基于大数据的认证分析系统及方法 - Google Patents · Google Patents · 2024-06-10 · 核验于 2026-10-22
- 85文档 CN120238354A - 基于弹性能源预测的虚假数据注入攻击检测方法及系统 - Google Patents · Google Patents · 2025-04-06 · 核验于 2026-10-22
- 86论文 Deep learning based black spot identification on Greek road networks · arXiv · 2023-06-20 · 核验于 2026-10-22
- 87论文 Deep Learning · Nature · 2015-05-28 · 核验于 2026-10-22
- 88论文 Gradient-based learning applied to document recognition · Proceedings of the IEEE · 1998-11-01 · 核验于 2026-10-22
- 89论文 ImageNet Classification with Deep Convolutional Neural Networks · NeurIPS · 2012-12-03 · 核验于 2026-10-22
- 90论文 Long Short-Term Memory · Neural Computation · 1997-11-15 · 核验于 2026-10-22
- 91论文 Attention Is All You Need · NeurIPS · 2017-12-04 · 核验于 2026-10-22
- 92论文 Deep Residual Learning for Image Recognition · CVPR · 2016-06-27 · 核验于 2026-10-22
- 93论文 Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift · ICML · 2015-02-11 · 核验于 2026-10-22
- 94论文 “Why Should I Trust You?”: Explaining the Predictions of Any Classifier · KDD · 2016-02-16 · 核验于 2026-10-22
- 95论文 A Non-technical Introduction to Machine Learning · Springer · 2023-07-22 · 核验于 2026-10-22
- 96文档 人工智能之核心基础 机器学习 第八章 无监督学习概述-腾讯云开发者社区-腾讯云 · Tencent · 2026-01-05 · 核验于 2026-10-22
- 97文档 Generative and Discriminative Classifiers: A Comparison · Stanford CS229 Lecture Notes · 2022-09-01 · 核验于 2026-10-22
- 98论文 Auto-Encoding Variational Bayes · arXiv:1312.6114 · 2013-12-20 · 核验于 2026-10-22
- 99论文 Generative Adversarial Networks · arXiv:1406.2661 · 2014-06-10 · 核验于 2026-10-22
- 100论文 Denoising Diffusion Probabilistic Models · arXiv:2006.11239 · 2020-06-19 · 核验于 2026-10-22
- 101论文 Improved Techniques for Training GANs · arXiv:1606.03498 · 2016-06-10 · 核验于 2026-10-22
- 102论文 Mode collapse in GANs · arXiv:1801.04062 · 2018-01-12 · 核验于 2026-10-22
- 103文档 数据集:拆分原始数据集 | Machine Learning | Google for Developers · Google for Developers · 2024-01-01 · 核验于 2026-10-22
- 104文档 scikit-learn 邮件列表讨论:训练集/验证集/测试集的划分与模型选择 · Python.org · 2017-01-26 · 核验于 2026-10-22
- 105文档 Data splits and cross-validation in automated machine learning - Azure Machine Learning · Learn Microsoft · 2024-10-03 · 核验于 2026-10-22
- 106文档 CN118586765A - A quality management risk control method and system based on big data - Google Patents · Google Patents · 2024-05-30 · 核验于 2026-10-22
- 107论文 Table 1 Metrics for evaluating ML models: analysis of model effectiveness across training, validation, and testing phases. · Nature · 2025-08-27 · 核验于 2026-10-22
- 108文档 FEPP: Advancing Software Risk Prediction in Requirements Engineering Through Innovative Rule Extraction and Multi-Class Integration · IEEE Xplore · 2024-04-21 · 核验于 2026-10-22
- 109文档 Machine Learning · Tom M. Mitchell, McGraw-Hill · 1997-03-01 · 核验于 2026-10-22
- 110论文 Regression Shrinkage and Selection via the Lasso · Robert Tibshirani, Journal of the Royal Statistical Society Series B · 1996-01-01 · 核验于 2026-10-22
- 111论文 Early Stopping — But When? · Prechelt, L., Neural Networks: Tricks of the Trade, Springer · 2012-01-01 · 核验于 2026-10-22
- 112论文 Dropout: A Simple Way to Prevent Neural Networks from Overfitting · Srivastava, Hinton, Krizhevsky, Sutskever, Salakhutdinov, JMLR · 2014-06-01 · 核验于 2026-10-22
- 113论文 A Study of Cross-Validation and Bootstrap for Accuracy Estimation and Model Selection · Kohavi, R., IJCAI · 1995-08-01 · 核验于 2026-10-22
- 114论文 Reconciling modern machine-learning practice and the classical bias–variance trade-off · Belkin, Hsu, Ma, Mandal, PNAS · 2019-12-24 · 核验于 2026-10-22
- 115文档 什麼是特徵工程?- 特徵工程說明 - AWS · Amazon.com · 2026-02-11 · 核验于 2026-10-22
- 116文档 使用數值資料 | Machine Learning | Google for Developers · Google for Developers · 2024-01-01 · 核验于 2026-10-22
- 117文档 Prepare data for machine learning - Training · Learn Microsoft · 2025-04-23 · 核验于 2026-10-22
- 118文档 机器学习|从0开发大模型之数据预处理-腾讯云开发者社区-腾讯云 · tencent.cn · 2025-02-26 · 核验于 2026-10-22
- 119文档 机器学习算法深度实战:企业级开发全链路解析 · 百度智能云 · 2025-12-11 · 核验于 2026-10-22
- 120文档 Where does the error come from? · GitHub · 2025-03-22 · 核验于 2026-10-22
- 121文档 The 3V's of Big Data: Volume, Velocity, Variety · Gartner Glossary · 2023-01-01 · 核验于 2026-10-22
- 122论文 The Google File System · SOSP 2003 / ACM · 2003-10-01 · 核验于 2026-10-22
- 123论文 MapReduce: Simplified Data Processing on Large Clusters · OSDI 2004 / Google Research · 2004-12-01 · 核验于 2026-10-22
- 124文档 Apache Hadoop · Apache Software Foundation · 2024-01-01 · 核验于 2026-10-22
- 125论文 Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing · NSDI 2012 / USENIX · 2012-04-01 · 核验于 2026-10-22
- 126文档 MLlib: Machine Learning Library · Apache Spark Documentation · 2024-01-01 · 核验于 2026-10-22
- 127论文 Scaling Distributed Machine Learning with the Parameter Server · OSDI 2014 / USENIX · 2014-10-01 · 核验于 2026-10-22
- 128文档 Distributed training with TensorFlow · TensorFlow Documentation · 2024-01-01 · 核验于 2026-10-22
- 129文档 Distributed Data Parallel · PyTorch Documentation · 2024-01-01 · 核验于 2026-10-22
- 130代码库 Horovod: Distributed Training Framework for TensorFlow, Keras, PyTorch, and Apache MXNet · GitHub / horovod · 2024-01-01 · 核验于 2026-10-22
- 131论文 Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism · arXiv:1909.08053 · 2019-09-17 · 核验于 2026-10-22
- 132论文 ZeRO: Memory Optimizations Toward Training Trillion Parameter Models · arXiv:1910.02054 · 2019-10-04 · 核验于 2026-10-22
- 133论文 Mixed Precision Training · arXiv:1710.03740 · 2017-10-10 · 核验于 2026-10-22
- 134文档 Gradient Accumulation · Hugging Face Transformers Documentation · 2024-01-01 · 核验于 2026-10-22
- 135文档 tf.data: Build TensorFlow input pipelines · TensorFlow Documentation · 2024-01-01 · 核验于 2026-10-22
- 136文档 MLflow: A Platform for the Machine Learning Lifecycle · MLflow Documentation · 2024-01-01 · 核验于 2026-10-22
- 137论文 Communication-Efficient Learning of Deep Networks from Decentralized Data · AISTATS 2017 / arXiv:1602.05629 · 2016-02-17 · 核验于 2026-10-22
- 138论文 Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM · SC21 / arXiv:2104.04473 · 2021-04-09 · 核验于 2026-10-22
- 139文档 Image Processing: a Review on Industrial Applications - Repository of the Academy's Library · Repository of the Academy's Library · 2026-10-18 · 核验于 2026-10-22
- 140文档 Speech and Language Processing (3rd edition draft) · Daniel Jurafsky & James H. Martin, Stanford University · 2024-01-01 · 核验于 2026-10-22
- 141论文 Natural Language Processing (almost) from Scratch · Journal of Machine Learning Research 12 (2011) 2493-2537 · 2011-08-01 · 核验于 2026-10-22
- 142论文 Neural Architectures for Named Entity Recognition · NAACL-HLT 2016; arXiv:1603.01360 · 2016-03-04 · 核验于 2026-10-22
- 143论文 BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding · NAACL-HLT 2019; arXiv:1810.04805 · 2018-10-11 · 核验于 2026-10-22
- 144论文 Google's Neural Machine Translation System: Bridging the Gap between Human and Machine Translation · arXiv:1609.08144 · 2016-09-26 · 核验于 2026-10-22
- 145报道 A Neural Network for Machine Translation, at Production Scale · Google Research Blog · 2016-09-27 · 核验于 2026-10-22
- 146论文 Language Models are Few-Shot Learners · NeurIPS 2020; arXiv:2005.14165 · 2020-05-28 · 核验于 2026-10-22
- 147报道 Introducing ChatGPT · OpenAI · 2022-11-30 · 核验于 2026-10-22
- 148论文 Position-aware Attention and Supervised Data Improve Slot Filling · EMNLP 2017 (TACRED) · 2017-09-01 · 核验于 2026-10-22
- 149论文 The Automatic Content Extraction (ACE) Program: Tasks, Data, and Evaluation · LREC 2004 · 2004-05-01 · 核验于 2026-10-22
- 150论文 Thumbs Up or Thumbs Down? Semantic Orientation Applied to Unsupervised Classification of Reviews · ACL 2002 · 2002-07-01 · 核验于 2026-10-22
- 151论文 Reading Wikipedia to Answer Open-Domain Questions · ACL 2017; arXiv:1704.00051 · 2017-04-03 · 核验于 2026-10-22
- 152论文 Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks · NeurIPS 2020; arXiv:2005.11401 · 2020-05-22 · 核验于 2026-10-22
- 153论文 Deep Speech 2: End-to-End Speech Recognition in English and Mandarin · ICML 2016; arXiv:1512.02595 · 2015-12-08 · 核验于 2026-10-22
- 154论文 Universal Language Model Fine-tuning for Text Classification · ACL 2018; arXiv:1801.06146 · 2018-01-18 · 核验于 2026-10-22
- 155论文 The FLORES-101 Evaluation Benchmark for Low-Resource and Multilingual Machine Translation · Transactions of the ACL; arXiv:2106.03193 · 2021-06-06 · 核验于 2026-10-22
- 156论文 Extracting Training Data from Large Language Models · USENIX Security 2021; arXiv:2012.07805 · 2020-12-14 · 核验于 2026-10-22
- 157论文 Man is to Computer Programmer as Woman is to Homemaker? Debiasing Word Embeddings · NeurIPS 2016; arXiv:1607.06520 · 2016-07-21 · 核验于 2026-10-22
- 158文档 Recommender Systems: An Introduction · Cambridge University Press · 2010-11-30 · 核验于 2026-10-22
- 159论文 Matrix Factorization Techniques for Recommender Systems · IEEE Computer, vol. 42, no. 8 · 2009-08-01 · 核验于 2026-10-22
- 160文档 The Netflix Prize · Netflix Prize Official Site · 2009-09-21 · 核验于 2026-10-22
- 161报道 BellKor's Pragmatic Chaos wins $1M Netflix Prize · The New York Times · 2009-09-22 · 核验于 2026-10-22
- 162论文 Neural Collaborative Filtering · Proceedings of the 26th International Conference on World Wide Web (WWW '17) · 2017-04-03 · 核验于 2026-10-22
- 163论文 DeepFM: A Factorization-Machine based Neural Network for CTR Prediction · Proceedings of the 26th International Joint Conference on Artificial Intelligence (IJCAI '17) · 2017-08-19 · 核验于 2026-10-22
- 164论文 Deep Neural Networks for YouTube Recommendations · Proceedings of the 10th ACM Conference on Recommender Systems (RecSys '16) · 2016-09-15 · 核验于 2026-10-22
- 165论文 Deep Learning based Recommender System: A Survey and New Perspectives · ACM Computing Surveys, vol. 52, no. 1 · 2019-02-01 · 核验于 2026-10-22
- 166论文 Amazon.com Recommendations: Item-to-Item Collaborative Filtering · IEEE Internet Computing, vol. 7, no. 1 · 2003-01-01 · 核验于 2026-10-22
- 167论文 Federated Learning for Recommender Systems: A Survey · ACM Transactions on Intelligent Systems and Technology · 2022-09-01 · 核验于 2026-10-22
- 168文档 Evaluating Recommendation Systems · Recommender Systems Handbook, Springer · 2010-01-01 · 核验于 2026-10-22
- 169论文 Offline Evaluation of Recommender Systems: A Survey · ACM Transactions on Recommender Systems · 2022-12-01 · 核验于 2026-10-22
- 170文档 The Filter Bubble: What the Internet Is Hiding from You · Penguin Press · 2011-05-12 · 核验于 2026-10-22
- 171报道 The Social Dilemma: A Documentary on Recommender Systems and Social Media · Netflix Documentary · 2020-01-26 · 核验于 2026-10-22
- 172文档 NSTL国家科技图书文献中心 · NSTL国家科技图书文献中心 · 2022-01-01 · 核验于 2026-10-22
- 173论文 Explainable AI reveals Clever Hans effects in unsupervised learning models · Nature · 2025-03-16 · 核验于 2026-10-22
- 174论文 Table 5. · National Institutes of Health (NIH) | (.gov) · 2025-03-04 · 核验于 2026-10-22
- 175论文 Paradoxical inflation of prediction model performance measures in minority patient subgroups: the role of upstream bias · Nature · 2026-10-20 · 核验于 2026-10-22
- 176论文 Transgressing the boundaries: towards a rigorous understanding of deep learning and its (non-)robustness · arXiv · 2026-08-08 · 核验于 2026-10-22
- 177文档 AI and Compute · OpenAI · 2018-05-16 · 核验于 2026-10-22
- 178论文 Energy and Policy Considerations for Deep Learning in NLP · ACL 2019 / arXiv:1906.02243 · 2019-06-05 · 核验于 2026-10-22
- 179论文 The Inference Cost of Search Disruption: Large Language Models as Costly Search Engines · arXiv:2303.07186 · 2023-03-13 · 核验于 2026-10-22
- 180文档 Google supercharges machine learning tasks with TPU custom chip · Google Cloud Blog · 2016-05-18 · 核验于 2026-10-22
- 181论文 Computing Power and the Governance of Artificial Intelligence · arXiv:2402.08797 · 2024-02-13 · 核验于 2026-10-22
- 182文档 Electricity 2024: Analysis and Forecast to 2026 · International Energy Agency (IEA) · 2024-01-24 · 核验于 2026-10-22
- 183论文 Green AI · Communications of the ACM / arXiv:1907.10597 · 2019-07-24 · 核验于 2026-10-22
- 184文档 CS229: Machine Learning(课程主页) · Stanford University · 2024-01-01 · 核验于 2026-10-22
- 185文档 6.036 Introduction to Machine Learning(课程主页) · MIT OpenCourseWare · 2020-09-01 · 核验于 2026-10-22
- 186文档 《机器学习》(西瓜书) · 清华大学出版社 · 2016-01-01 · 核验于 2026-10-22
- 187文档 《统计学习方法(第2版)》 · 清华大学出版社 · 2019-05-01 · 核验于 2026-10-22
- 188文档 Machine Learning Specialization · Coursera / DeepLearning.AI · 2022-06-01 · 核验于 2026-10-22
- 189文档 Practical Deep Learning for Coders · fast.ai · 2022-07-01 · 核验于 2026-10-22
- 190文档 Kaggle Learn · Kaggle · 2024-01-01 · 核验于 2026-10-22