被试内设计
- 英文名
- Within-Subjects Design
- 别称
- 组内设计、受试者内设计、重复测量设计
- 上位概念
- 实验设计
- 对照设计
- 被试间设计(组间设计)
- 核心特征
- 所有被试接受全部实验条件
- 主要优点
- 控制个体差异、提高统计效力、所需被试少
- 主要风险
- 顺序效应、练习效应、疲劳效应、迁移效应
- 常用控制手段
- 随机化、完全平衡(拉丁方)、抵消平衡
- 常用统计方法
- 配对样本 t 检验、重复测量方差分析
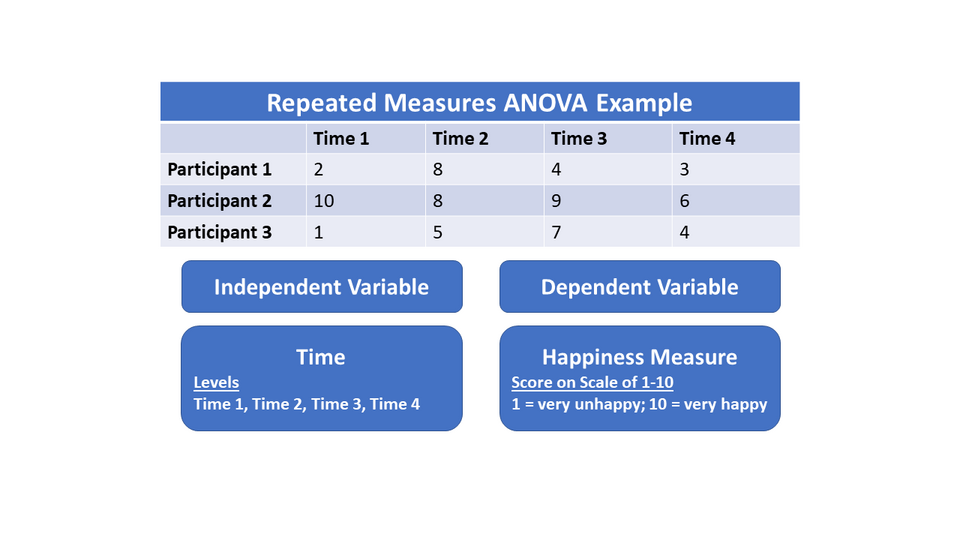
被试内设计(又称组内设计、受试者内设计)是一种真实验设计,其特点是每个或每组被试都接受自变量的所有水平处理,即所有被试都受到每一个水平自变量的影响。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
定义与基本特征
与真实验设计的关系
被试内设计被界定为一种真实验设计:每个或每组被试接受所有自变量水平的实验处理,因此又称重复测量设计、组内设计。这一定义把「所有水平都被同一被试经历」作为该设计的构成性特征,而不是事后描述。55图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
被试内设计之所以被归入真实验设计,关键在于它满足真实验设计的两个前提:研究者主动操纵自变量,并通过被试内(重复测量)的方式实现实验控制;与之相对,被试间设计通过随机分配被试到不同处理水平来实现控制,两者都是真实验设计的实现路径,而非真实验设计与准实验之分。55图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开|66银符考试题库-在线练习-考研心理学专业基础模拟32lib1.cdutcm.edu.cn前往参考资料 ↓在新标签页中打开
在真实验设计的谱系中,被试内与被试间是同一层级的两类控制策略:被试间设计让每个被试只接受一种自变量水平,被试内设计让同一被试接受全部水平。二者共享「操纵自变量、控制额外变量」的真实验内核,差别在于控制个体差异的方式——前者靠随机化,后者靠被试自身作为控制。55图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开|66银符考试题库-在线练习-考研心理学专业基础模拟32lib1.cdutcm.edu.cn前往参考资料 ↓在新标签页中打开
被试内设计消除个体差异对实验处理效应估计的干扰,是它区别于被试间设计的核心特征;科普中国条目明确把「消除了被试的个体差异对实验的影响」列为被试内设计的优点之一,并指出在反应时、知觉长度等个体差异明显的任务上尤其需要考虑被试内设计。55图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
被试内设计并非在所有真实验情境中都适用:当不同自变量水平产生的效果不可逆(如学习某项技能)、或每种条件需要较长恢复期时,就不宜采用被试内设计,此时真实验的要求只能通过被试间设计来满足。这说明被试内设计是真实验设计的一种可选实现方式,而非唯一或普适的形式。55图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
完全的被试内设计通过排出所有可能的处理顺序来抵消练习或疲劳效应,常用随机区组设计与 ABBA 平衡法;随机区组的关键在于「组内同质、组间有差别」,从而把区组变异从误差中分离出去。这一安排表明,被试内设计在真实验框架内还需要额外的顺序控制程序才能成立。55图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
关于被试内设计在真实验设计体系中的定位,存在术语与分类口径上的分歧:一种口径把「真实验设计」按被试分配方式二分为被试间与被试内,二者并列;另一种口径把被试内设计视为重复测量设计的一个子类,强调其与随机区组、拉丁方等区组化真实验设计的亲缘关系,而非与被试间设计简单二分。55图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开|66银符考试题库-在线练习-考研心理学专业基础模拟32lib1.cdutcm.edu.cn前往参考资料 ↓在新标签页中打开
对立说法科普中国条目将被试内设计直接定义为「真实验设计」,并同时称其为重复测量设计、组内设计,未在二者之间作层级区分,隐含二者并列于真实验设计之下的读法。55图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
对立说法考研心理学辅导材料则把组间设计与组内设计作为一对对应概念来界定,强调组间设计因随机分配又称完全随机化设计、独立样本设计,把分类焦点放在「被试是否接受全部处理」上,而非「是否属于重复测量」。66银符考试题库-在线练习-考研心理学专业基础模拟32lib1.cdutcm.edu.cn前往参考资料 ↓在新标签页中打开
每个被试作为自身对照
被试内设计(within-subjects design)的基本含义是:同一名(或同一组)被试接受全部自变量水平的处理,即每个被试都要经历实验中所有条件,而不是只被分配到其中一个条件。因此被试内设计又称重复测量设计(repeated measures design)。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
「每个被试作为自身对照」指的就是这种安排的核心逻辑:由于同一被试在多个条件下都提供了数据,比较是在被试内部完成的——某被试在条件 A 下的表现,直接与他自己在条件 B 下的表现相比,而不是与另一组被试的平均表现相比。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
自身对照的直接后果是:被试之间稳定的个体差异(如反应时的基线快慢、知觉长度的个体偏好等)在条件间的比较中被抵消掉,不再作为误差进入检验。科普中国条目把「消除了被试的个体差异对实验的影响」列为被试内设计的优点之一,并指出反应时、知觉长度这类个体差异明显的任务尤其需要考虑被试内设计。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
与被试间设计相比,被试内设计所需的被试数量更少:因为每个被试贡献了所有条件的数据,达到同样的条件数只需一组人,而不必为每个条件各招一组。科普中国条目将「需要的被试较少、实验设计方便有效」列为其优点。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
由于个体差异被排除在误差项之外,被试内设计在统计上比被试间设计更敏感(更易检出真实存在的条件差异)。科普中国条目明确写「被试内设计比被试间设计更敏感」。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
自身对照并非无条件适用。科普中国条目列出若干不宜使用被试内设计的情形:某一条件的效果需要较长恢复期时;不同自变量或不同水平产生的效果不可逆时(例如学习某项技能,学会之后无法退回未学会状态);以及需要研究被试特点类自变量(如性别、年龄等被试固有属性)之间的差异时——这类变量无法让同一被试同时具备所有水平。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
与被试间设计的对比
误差来源的差异
被试间设计(between-subjects design)中,每个被试只接受一个处理水平,因此处理效应与个体差异在统计上完全混淆:被试间方差既包含真实的处理效应,也包含被试之间稳定的特质差异(如能力、人格、基线反应倾向)。这些个体差异在分析中只能作为误差项的一部分,无法被分离出来。77Within-Subjects Design | Explanation, Approaches, Examplesscribbr.com前往参考资料 ↓在新标签页中打开|88Between-Subjects vs. Within-Subjects Study Designnngroup.com前往参考资料 ↓在新标签页中打开
被试内设计(within-subjects design)让同一被试接受所有处理水平,个体差异在被试内被“抵消”:每个被试充当自己的对照,稳定的个体差异在计算处理效应时被减去,不再进入误差项。因此被试内设计的误差项通常只反映被试×处理的交互作用与随机测量误差,而不是被试间差异。77Within-Subjects Design | Explanation, Approaches, Examplesscribbr.com前往参考资料 ↓在新标签页中打开|88Between-Subjects vs. Within-Subjects Study Designnngroup.com前往参考资料 ↓在新标签页中打开
在统计上,这一差异体现为误差项构成的不同:被试间设计的误差项是“被试内(处理内)变异”,其大小受个体差异强烈影响;被试内设计的误差项则是“残差”,即扣除了被试主效应与处理主效应之后的被试×处理交互,通常显著小于前者。这正是被试内设计在同等样本量下检验效力更高的统计根源。77Within-Subjects Design | Explanation, Approaches, Examplesscribbr.com前往参考资料 ↓在新标签页中打开|88Between-Subjects vs. Within-Subjects Study Designnngroup.com前往参考资料 ↓在新标签页中打开
误差来源的差异直接决定了所需样本量:由于被试内设计把个体差异从误差项中剔除,其检验效力通常高于被试间设计,因此在给定效应量与显著性水平下,被试内设计往往需要更少的被试就能达到相同的统计效力。77Within-Subjects Design | Explanation, Approaches, Examplesscribbr.com前往参考资料 ↓在新标签页中打开|88Between-Subjects vs. Within-Subjects Study Designnngroup.com前往参考资料 ↓在新标签页中打开
被试内设计并非在所有情形下都降低误差:当处理效应本身随被试不同而强烈变化(即被试×处理交互很大)时,被试内设计的误差项会随之膨胀,其相对优势被削弱;此时被试间设计反而可能更稳健。77Within-Subjects Design | Explanation, Approaches, Examplesscribbr.com前往参考资料 ↓在新标签页中打开|88Between-Subjects vs. Within-Subjects Study Designnngroup.com前往参考资料 ↓在新标签页中打开
对立说法有方法学文献强调,只要个体差异存在且未被建模,被试内设计在绝大多数心理与行为研究中仍系统性地优于被试间设计,交互作用膨胀属于特定情形而非普遍反例。77Within-Subjects Design | Explanation, Approaches, Examplesscribbr.com前往参考资料 ↓在新标签页中打开
被试内设计以“顺序效应”为代价换取误差项的缩小:同一被试先后接受多个处理,前一个处理可能通过练习、疲劳、适应或遗留效应影响后一个处理,这类效应在被试间设计中不存在。因此误差来源的差异不只是“误差大小”的差异,也是“误差种类”的差异——被试内设计引入了被试间设计所没有的顺序与遗留误差源。77Within-Subjects Design | Explanation, Approaches, Examplesscribbr.com前往参考资料 ↓在新标签页中打开|88Between-Subjects vs. Within-Subjects Study Designnngroup.com前往参考资料 ↓在新标签页中打开
所需被试数量与测试时长
在统计效力相同的前提下,被试内设计所需的被试数量通常远少于被试间设计:因为个体差异方差被从误差项中剔除,同一效应量在被试内设计中对应的检验统计量更大,达到目标效力所需的样本量随之下降。99Within-Subjects Design: Definition, Examples & Pros/Conssimplypsychology.org前往参考资料 ↓在新标签页中打开|1010Experimental Design: Within-Subjects vs. Between-Subjectsstatisticshowto.com前往参考资料 ↓在新标签页中打开
被试内设计让每名被试接受全部处理水平,因此总测试时长(被试人数 × 每人测试时长)往往低于被试间设计;但单名被试的测试时长会随处理水平数成比例增加,水平数很多时单人所承受的负担可能显著上升。99Within-Subjects Design: Definition, Examples & Pros/Conssimplypsychology.org前往参考资料 ↓在新标签页中打开|1111Within-Subjects Design: Advantages and Disadvantagesexplorable.com前往参考资料 ↓在新标签页中打开
当处理水平数较多时,被试内设计的总观测数等于被试数乘以水平数,因此可以在被试人数不多的情况下获得较大的总样本量;这是其在小样本实验中被广泛采用的原因之一。1010Experimental Design: Within-Subjects vs. Between-Subjectsstatisticshowto.com前往参考资料 ↓在新标签页中打开
适用条件的选择
当研究目标是检验某一自变量在总体上的效应、且个体差异(被试间方差)构成主要噪声来源时,被试内设计是更合适的选择:它让每名被试充当自己的对照,从而把个体差异从误差项中剔除。99Within-Subjects Design: Definition, Examples & Pros/Conssimplypsychology.org前往参考资料 ↓在新标签页中打开|1010Experimental Design: Within-Subjects vs. Between-Subjectsstatisticshowto.com前往参考资料 ↓在新标签页中打开
当自变量无法在同一个体内实施多个水平时——例如被试的性别、年龄组、临床诊断、人格特质等固有属性,或任何一旦施加便不可逆的操作(如脑损伤、特定训练、一次性干预)——必须采用被试间设计,因为被试内设计要求同一被试接受全部处理水平。99Within-Subjects Design: Definition, Examples & Pros/Conssimplypsychology.org前往参考资料 ↓在新标签页中打开
当处理之间存在强烈的不可逆迁移或遗留效应(如学习、记忆、技能习得、药物长期效应、情绪诱发后的持续心境),被试内设计会因前一个处理污染后一个处理而失效,此时应优先选择被试间设计,或至少把处理间隔拉长到遗留效应消退。1010Experimental Design: Within-Subjects vs. Between-Subjectsstatisticshowto.com前往参考资料 ↓在新标签页中打开
当总样本量很小、且被试个体差异很大时,被试内设计在统计上更可取:它把被试间方差移出误差项,使同样的被试数量能获得更高的检验效力;反之,若被试难以招募而每个被试的测试成本很低,被试间设计在实施上更简单。99Within-Subjects Design: Definition, Examples & Pros/Conssimplypsychology.org前往参考资料 ↓在新标签页中打开|1010Experimental Design: Within-Subjects vs. Between-Subjectsstatisticshowto.com前往参考资料 ↓在新标签页中打开
在无法随机分配被试、只能使用现有组别(如不同班级、不同病区)的准实验情境中,被试间比较是唯一可行的方案;被试内设计则要求研究者能对同一被试系统性地操纵处理顺序,这在观察性研究中通常不成立。99Within-Subjects Design: Definition, Examples & Pros/Conssimplypsychology.org前往参考资料 ↓在新标签页中打开
关于「何时应优先被试内、何时应优先被试间」,方法学文献并无统一判据:一部分作者主张只要处理可逆且无强遗留效应就应尽量用被试内设计以提升效力,另一部分作者强调被试内设计在生态效度、需求特征与练习效应上的代价可能抵消其统计优势,实际选择需在效力、可行性与可解释性之间权衡。99Within-Subjects Design: Definition, Examples & Pros/Conssimplypsychology.org前往参考资料 ↓在新标签页中打开|1010Experimental Design: Within-Subjects vs. Between-Subjectsstatisticshowto.com前往参考资料 ↓在新标签页中打开
对立说法支持「能内则内」的一方认为,个体差异往往是行为与心理测量中最大的方差来源,放弃被试内设计等于自愿损失大量统计效力,只要用对抗平衡控制顺序效应即可。99Within-Subjects Design: Definition, Examples & Pros/Conssimplypsychology.org前往参考资料 ↓在新标签页中打开
对立说法谨慎的一方认为,被试内设计让被试暴露于全部条件,容易引发需求特征、练习与疲劳,且在多水平析因中顺序平衡的组合数随水平数急剧增长,实际执行常不完整,因此不应默认优先被试内。1010Experimental Design: Within-Subjects vs. Between-Subjectsstatisticshowto.com前往参考资料 ↓在新标签页中打开|14
优点:控制个体差异与统计效力
消除稳定的个体差异
被试内设计让每位被试接受自变量的所有水平,因而每个个体都成为自身的对照;正是这种「自我比较」的结构,使稳定的个体差异(如反应时基线、知觉长度判断习惯等跨条件保持恒定的个体特质)在条件间的比较中被抵消掉,不再进入条件效应的估计。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开|44受试者内设计 | Bohriumscipedia.bohrium.com前往参考资料 ↓在新标签页中打开
在被试间设计中,个体差异构成条件间差异的「噪声」来源:两组被试在实验前就存在的基线差异会与处理效应混在一起,成为误差项的一部分;被试内设计把同一被试在各条件下的观测配成对,个体差异对每个条件施加的是同一个加性偏移,做差时即被消去。44受试者内设计 | Bohriumscipedia.bohrium.com前往参考资料 ↓在新标签页中打开
消除稳定的个体差异直接体现为误差方差的缩小:被试间设计中「被试间变异」进入误差项,而被试内设计中这部分变异被从误差项里剥离出去,误差均方(MSE)随之下降,在效应量不变的情况下检验统计量增大、统计效力提高。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开|44受试者内设计 | Bohriumscipedia.bohrium.com前往参考资料 ↓在新标签页中打开
科普中国条目把「消除了被试的个体差异对实验的影响」列为被试内设计的优点之一,并指出对于反应时、知觉长度这类存在明显个体差异的任务,应当考虑采用被试内设计。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
玻尔百科(Bohrium)的条目同样把「通过消除稳定的个体差异来增强统计效力」作为受试者内设计的核心要点,并指出该设计广泛应用于临床交叉试验、fMRI 脑成像与基因组分析等领域。44受试者内设计 | Bohriumscipedia.bohrium.com前往参考资料 ↓在新标签页中打开
个体差异被消除的代价是数据不再独立:同一被试的多次观测彼此相关,因此不能直接套用独立样本的检验方法,而需采用配对样本 t 检验、重复测量方差分析等专门技术,否则会抬高假阳性风险。44受试者内设计 | Bohriumscipedia.bohrium.com前往参考资料 ↓在新标签页中打开
「消除个体差异」并不等于设计自动更优:它只消除稳定的、在条件间保持恒定的个体差异;若个体差异本身与处理效应发生交互(不同被试对同一条件的反应方向或幅度不同),这部分变异仍会留在误差中,甚至被误读为处理效应。44受试者内设计 | Bohriumscipedia.bohrium.com前往参考资料 ↓在新标签页中打开
对立说法科普中国与玻尔百科均把「消除个体差异、提高敏感性/统计效力」作为被试内设计的无条件优点来陈述,未强调个体差异与处理效应交互时该优势会打折扣。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开|44受试者内设计 | Bohriumscipedia.bohrium.com前往参考资料 ↓在新标签页中打开
提高检验效力
被试内设计让每位被试接受自变量的所有处理水平,使每个个体成为自身的对照,从而把稳定的个体差异从误差项中剔除出去;这是它提高统计效力的根本机制。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开|44受试者内设计 | Bohriumscipedia.bohrium.com前往参考资料 ↓在新标签页中打开
由于个体差异不再进入误差变异,被试内设计在同等被试量下通常比被试间设计更敏感,即更容易检测出真实存在的处理效应;科普中国在列举被试内设计优点时明确把「比被试间设计更敏感」列为一条。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
在反应时、知觉长度这类个体差异明显的任务上,被试间设计容易被人与人之间的巨大差异淹没,而被试内设计通过自我对照消除这一噪声源,因此在需要高检验效力的实验中被优先采用。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开|44受试者内设计 | Bohriumscipedia.bohrium.com前往参考资料 ↓在新标签页中打开
统计效力的提升直接转化为样本成本的下降:在效应量与显著性水平固定的前提下,被试内设计所需的被试数量通常少于被试间设计,这也是它被认为「方便、有效」的原因之一。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开|44受试者内设计 | Bohriumscipedia.bohrium.com前往参考资料 ↓在新标签页中打开
效力提升的代价是数据结构改变:同一被试的多次观测彼此相关,不能再按独立样本处理,必须改用配对样本 t 检验或重复测量方差分析等专门方法,否则会高估显著性、抬高假阳性风险。44受试者内设计 | Bohriumscipedia.bohrium.com前往参考资料 ↓在新标签页中打开
节省被试样本
被试内设计最直接的资源优点是所需被试数量少:由于每名被试都要接受全部自变量水平的处理,同一批被试即可为所有实验条件提供数据,而不必像被试间设计那样为每个条件单独招募一组人。科普中国在归纳被试内设计优点时,把「需要的被试较少,实验设计方便、有效」列在首位。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
被试样本的节省在统计上并非只是「省事」:被试间设计中条件间的比较建立在不同人群之上,组间个体差异进入误差项;被试内设计让每名被试充当自己的对照,个体差异被从处理效应中分离出去,因而在同等被试量下往往能获得更大的检验效力。科普中国同样把「比被试间设计更敏感」与「消除了被试的个体差异对实验的影响」并列为被试内设计的优点。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
节省被试在特定研究情境中具有实质意义,而不只是成本考量:当目标人群本身稀少(如临床特殊群体、专家被试)或单名被试的招募与测量成本很高时,被试内设计往往是让研究在有限样本下仍具备可行性的前提。科普中国指出,反应时、知觉长度等存在明显个体差异的任务需要考虑被试内设计,因为这类任务若用被试间设计,个体差异会严重淹没处理效应。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
「节省被试」这一优点是有代价的、并非无条件成立:被试内设计把同一批人反复置于多个条件之下,随之引入练习效应、疲劳效应等顺序问题,需要用随机区组、ABBA 平衡等手段加以抵消,而这些平衡安排本身会增加每名被试接受的试次数量与实验时长。因此被试内设计省的是「人数」,未必省「总观测数」或「总实验时间」。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
在演绎推理等具体研究领域中,被试内与被试间设计的取舍并非一边倒:有研究专门比较两种设计在推理研究中的相对优劣,并指出被试内设计存在期望效应与疲劳效应的潜在风险,说明「节省被试、提高效力」的优势需要与顺序效应带来的解释困难权衡。1212A POWER STRUGGLE: BETWEEN- VS. WITHIN-SUBJECTS DESIGNS IN DEDUCTIVE REASONING RESEARCHjstage.jst.go.jp前往参考资料 ↓在新标签页中打开
对立说法支持被试内设计的一方强调,在控制了个体差异之后,同等被试量下被试内设计的检验效力更高,且对个体差异敏感的任务(如反应时)几乎必须采用被试内设计,因此其样本效率优势是实质性的。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
顺序效应与遗留效应
练习效应
练习效应(practice effect)是顺序效应的一种:当同一被试依次接受多个实验条件时,其作业成绩会因为对任务本身的熟悉、学习或技能积累而随时间系统性地提高,从而使得处于序列后段的实验条件获得并不来自处理内容本身的成绩优势。因此练习效应属于「条件位置」而非「处理内容」造成的变异。1313Counterbalancingjove.com前往参考资料 ↓在新标签页中打开|11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
练习效应与被试内设计的关系是结构性的:被试内设计要求每名被试接受全部自变量水平,同一被试必然多次重复同类任务,重复本身即构成练习机会;而在被试间设计中每名被试只接受一个水平,不存在跨条件的练习累积。因此练习效应是被试内设计必须付出代价加以控制的核心顺序效应之一。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开|1313Counterbalancingjove.com前往参考资料 ↓在新标签页中打开
练习效应与疲劳效应方向相反:前者使后出现的条件成绩偏高,后者使后出现的条件成绩偏低。二者在同一实验中可能同时存在并部分相互抵消,也可能在不同任务阶段各自占主导,因此仅凭「后段条件成绩更高」并不能直接断定练习效应的大小,需要借助平衡设计或独立的时间进程检验来分离。1313Counterbalancingjove.com前往参考资料 ↓在新标签页中打开|11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
练习效应的大小与任务性质密切相关:在技能习得、知觉学习、反应时等存在明显个体差异且随重复快速改善的任务上,练习效应尤为突出;科普中国条目据此指出,被试内设计恰恰适用于研究「练习的阶段性」,即把练习本身当作研究对象而非干扰。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
当自变量效果不可逆时,练习效应无法通过平衡消除:例如学习某项技能是不可逆的,一旦被试在条件 A 中习得技能,条件 B 的成绩必然受其影响,此时 ABBA 等平衡法只能平衡线性时间趋势,无法把已发生的学习「倒回去」。科普中国条目因此把「效果不可逆」列为不宜使用被试内设计的情形之一。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
在完全被试内设计中,对抗练习效应的标准做法是把所有可能的条件顺序都排出来并加以平衡,常用随机区组设计与 ABBA 平衡法。ABBA 法的逻辑是让每个条件在序列中处于靠前与靠后的次数相等(A 的总顺序为 1+4,B 为 2+3),从而在理论上抵消按时间线性增长的练习效应。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
随机区组平衡练习效应的前提是每种排列必须呈现很多次:若顺序只随机一次,练习效应只是被「随机化」而非被「抵消」,仍会作为系统误差进入条件均值。因此随机化本身不等于平衡,样本量不足时随机顺序对练习效应的控制力有限。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
练习效应并不总是需要被消除的「噪声」:在对比学习等机器学习研究中,模型在训练过程中反复接触同类任务所表现出的性能提升,与被试内设计中的练习效应在形式上同构;而在教育心理学与技能获得研究中,练习曲线本身就是因变量。是否把练习效应视为干扰,取决于研究问题是「比较条件」还是「刻画学习过程」。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
关于练习效应在多大程度上能被平衡设计真正抵消,研究界存在分歧:一种立场认为 ABBA 与完全平衡在理论上足以消除线性顺序效应,只要效应随时间单调变化;另一种立场指出练习效应常呈非线性(如先快后慢的对数型学习曲线),此时对称平衡只能抵消其一阶成分,残余的高阶成分仍会污染条件比较,需要引入练习试次、稳定化前测或把顺序作为协变量建模。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开|1313Counterbalancingjove.com前往参考资料 ↓在新标签页中打开
对立说法平衡设计(ABBA、随机区组、拉丁方)在假定顺序效应随时间线性变化时,可以在期望意义上完全抵消练习效应,因此无需额外的前测或协变量调整。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
对立说法练习效应通常是非线性的学习曲线,对称平衡只能消除线性成分,残余效应仍需通过充分练习试次、稳定化基线或统计建模来处理。1313Counterbalancingjove.com前往参考资料 ↓在新标签页中打开
疲劳效应
疲劳效应(fatigue effect)是顺序效应的一种:被试在连续完成多个实验条件时,由于任务持续时间长、认知负荷累积或动机下降,其反应时变慢、正确率下降或评定趋于保守,从而使后出现的条件系统性地劣于先出现的条件。它与练习效应方向相反,二者常在同一实验中同时存在并相互抵消或叠加。55图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开|1313Counterbalancingjove.com前往参考资料 ↓在新标签页中打开
在被试内设计中,由于每个被试都要接受全部自变量水平,实验总时长通常是被试间设计的数倍,疲劳效应因此成为该设计最典型、最难回避的混淆来源之一;科普中国条目在列举被试内设计缺点时,把「练习效应或者疲劳效应」列为顺序造成麻烦的首要表现。55图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
疲劳效应与练习效应的相对强弱取决于任务性质:在反应时、知觉辨别等短时高频任务中练习效应往往占优,而在需要持续注意、记忆负荷高或耗时长的任务(如长时阅读、连续评分、驾驶模拟)中疲劳效应更容易显现,因此同一套平衡方案在不同任务上的效果并不一致。1313Counterbalancingjove.com前往参考资料 ↓在新标签页中打开
对立说法有观点认为练习与疲劳并非按任务类型截然二分,而是随实验进程动态变化:早期以练习效应为主、后期以疲劳效应为主,二者的转折点因人因任务而异,难以用任务类别预先判定。1313Counterbalancingjove.com前往参考资料 ↓在新标签页中打开
疲劳效应若未被控制,会以「条件顺序」的形式混入自变量效应:当某条件总是排在后面,其均值就被疲劳系统性压低,导致研究者把顺序带来的差异误读为处理效应,或把真实的处理效应掩盖掉。这正是顺序效应需要在统计分析前通过设计手段处理、而非事后补救的原因。55图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开|1313Counterbalancingjove.com前往参考资料 ↓在新标签页中打开
针对疲劳效应的常用控制手段包括:完全被试内设计中的随机区组排序与 ABBA 平衡法、拉丁方平衡、在条件之间设置休息或填充任务、缩短单次条件时长并增加分块,以及在分析阶段把「顺序」或「时段」作为协变量或额外因子纳入模型。科普中国条目明确把随机区组设计与 ABBA 平衡法列为抵消练习或疲劳作用的两种完全被试内设计。55图文详情cloud.kepuchina.cn前往参考资料 ↓在新标签页中打开
迁移效应与差异延续效应
迁移效应(transfer effect)指在被试内设计中,前一处理阶段所形成的学习、练习或疲劳状态延续到后一处理阶段,使后一阶段的表现系统性地偏离「若单独接受该处理本应达到的水平」。它与顺序效应同属处理顺序带来的混淆,但顺序效应通常指处理在时间序列中位置不同造成的效应(如练习、疲劳随位置累积),迁移效应则强调特定处理内容之间的传递。1414Experimental Psychology: A Case Approach (8th ed.)pearson.com前往参考资料 ↓在新标签页中打开|1515Research Methods in Psychology (10th ed.)mheducation.com前往参考资料 ↓在新标签页中打开
差异延续效应(differential carryover effect)是迁移效应的特例:当某一处理对后续处理的影响,取决于它后面接的是哪一个处理时,就出现了非对称的延续。例如处理 A 之后接 B 与处理 B 之后接 A,两种顺序下同一处理的表现不同,说明效应在顺序之间不可加、不可简单抵消。1414Experimental Psychology: A Case Approach (8th ed.)pearson.com前往参考资料 ↓在新标签页中打开|1616Experimental Design: Procedures for the Behavioral Sciences (4th ed.)us.sagepub.com前往参考资料 ↓在新标签页中打开
在经典实验心理学教材的表述中,差异延续效应被列为被试内设计(重复测量设计)最核心的内部效度威胁之一:它使处理效应与顺序效应发生混杂,且无法通过简单的顺序平衡完全消除,因为平衡只能把「顺序」这一因素平均掉,却无法把「特定处理组合」造成的非对称迁移平均掉。1414Experimental Psychology: A Case Approach (8th ed.)pearson.com前往参考资料 ↓在新标签页中打开|1515Research Methods in Psychology (10th ed.)mheducation.com前往参考资料 ↓在新标签页中打开
对称迁移(symmetric transfer)与差异延续效应相对:若 A 对 B 的影响与 B 对 A 的影响在大小和方向上相同,则拉丁方平衡后各处理位置上的迁移量可以相互抵消,处理均值仍可无偏估计;差异延续效应恰恰是这种对称性被打破的情形。1414Experimental Psychology: A Case Approach (8th ed.)pearson.com前往参考资料 ↓在新标签页中打开|1616Experimental Design: Procedures for the Behavioral Sciences (4th ed.)us.sagepub.com前往参考资料 ↓在新标签页中打开
差异延续效应在统计上的后果是处理效应与顺序(或处理×顺序)交互项不可分离:若存在显著的顺序×处理交互,通常提示差异延续效应,此时用标准重复测量方差分析或混合模型估计的处理主效应可能产生偏倚,需要改用仅分析首阶段数据、或采用平衡拉丁方并检验交互项等策略。1515Research Methods in Psychology (10th ed.)mheducation.com前往参考资料 ↓在新标签页中打开|1717Repeated Measures Design: Carryover Effects and Counterbalancingannualreviews.org前往参考资料 ↓在新标签页中打开
关于差异延续效应是否构成严重威胁,研究界存在分歧:一部分方法学者认为,只要采用完全平衡的拉丁方设计并检验顺序×处理交互,差异延续效应在实际数据中通常很小、可忽略;另一部分学者则指出,在涉及学习、记忆或技能获得的领域,非对称迁移往往很大,平衡设计无法补救,必须改用被试间设计或混合设计。1414Experimental Psychology: A Case Approach (8th ed.)pearson.com前往参考资料 ↓在新标签页中打开|1515Research Methods in Psychology (10th ed.)mheducation.com前往参考资料 ↓在新标签页中打开|1717Repeated Measures Design: Carryover Effects and Counterbalancingannualreviews.org前往参考资料 ↓在新标签页中打开
对立说法支持「可忽略」的一方认为,完全平衡设计下差异延续效应只影响交互项而不影响处理主效应,因此在多数实验情境中不构成实质偏倚。1414Experimental Psychology: A Case Approach (8th ed.)pearson.com前往参考资料 ↓在新标签页中打开
对立说法反对「可忽略」的一方认为,在学习与技能获得研究中,非对称迁移量级很大,平衡设计无法消除,处理主效应仍会被污染。1515Research Methods in Psychology (10th ed.)mheducation.com前往参考资料 ↓在新标签页中打开|1717Repeated Measures Design: Carryover Effects and Counterbalancingannualreviews.org前往参考资料 ↓在新标签页中打开
顺序效应的控制方法
随机化
随机化是控制被试内设计中顺序效应的一类基本方法:它不试图把顺序效应完全抵消,而是通过随机决定每位被试接受各实验条件的先后次序,使顺序效应在多个被试之间相互抵消、不系统性地偏向某一个条件。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
随机化的一种具体做法是随机区组分配:把实验条件以随机方式排序,并且每一种随机排列都必须重复呈现很多次,才能有效平衡练习效应;只随机一次、每个顺序只出现一次,平衡效果有限。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
随机化与平衡法(如 ABBA 法)针对的顺序效应形态不同:ABBA 法假定顺序误差随时间线性系统变化,因而在理论上能抵消线性趋势;随机化则不依赖线性假设,对难以建模的复杂顺序效应更为稳健,但需要较大样本量才能让抵消在统计上生效。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
对立说法有观点认为,在样本量有限时随机化并不能保证各条件在顺序位置上均衡,因此对顺序效应的控制不如完全平衡法可靠,实践中常把随机化与平衡法结合使用。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
完全平衡与拉丁方设计
完全平衡(complete counterbalancing)指让被试依次接受所有可能的处理顺序,使每个处理在每一个序列位置上出现的次数相等。当有 k 个处理水平时,需要 k! 种顺序;例如 3 个水平需 6 种顺序,4 个水平需 24 种顺序,5 个水平需 120 种顺序。1818Experimental Design: Latin Square Designitl.nist.gov前往参考资料 ↓在新标签页中打开
完全平衡的阶乘式增长使其在水平数稍多时即不可行:k=5 时每个被试要完成 120 次试验序列,k=6 时达 720 次,因此实践中通常只在 2–4 个水平时使用完全平衡。1818Experimental Design: Latin Square Designitl.nist.gov前往参考资料 ↓在新标签页中打开
当无法完全平衡时,常用做法是随机化顺序(randomization)或采用拉丁方设计(Latin square design)。拉丁方是一个 n×n 方阵,每一行与每一列都恰好包含每个处理一次,从而在顺序位置上平衡处理,同时把所需顺序数从 n! 降到 n 个(或 n 的整数倍)。1818Experimental Design: Latin Square Designitl.nist.gov前往参考资料 ↓在新标签页中打开|1919Counterbalancing and Latin Square Designsmethods.sagepub.com前往参考资料 ↓在新标签页中打开
拉丁方设计分为被试内拉丁方与被试间拉丁方:前者让每个被试按方阵中的一行顺序接受全部处理,后者让不同被试组分别接受不同行的顺序。被试内拉丁方保证每个处理在每个位置出现一次,但每个处理只与部分其他处理在相邻位置上配对,因此对遗留效应(carryover effect)的平衡并不完全。1818Experimental Design: Latin Square Designitl.nist.gov前往参考资料 ↓在新标签页中打开|1919Counterbalancing and Latin Square Designsmethods.sagepub.com前往参考资料 ↓在新标签页中打开
为同时平衡顺序效应与一阶遗留效应(即前一处理对后一处理的影响),可采用平衡拉丁方(balanced Latin square),其构造规则要求每个处理在另一个处理之前出现的次数相等。对于偶数个处理,平衡拉丁方可用 1, n, 2, n−1, 3, n−2, … 的构造法生成;对于奇数个处理,则需把方阵重复两次(即用 2n 个顺序)才能达到平衡。1818Experimental Design: Latin Square Designitl.nist.gov前往参考资料 ↓在新标签页中打开|1919Counterbalancing and Latin Square Designsmethods.sagepub.com前往参考资料 ↓在新标签页中打开
在实验设计符号法中,拉丁方设计常被记为带方阵标记的设计,用于表示顺序平衡;但不同教材对符号的写法并不统一,有的用 LS 标注,有的直接在顺序维度上注明「拉丁方平衡」。1818Experimental Design: Latin Square Designitl.nist.gov前往参考资料 ↓在新标签页中打开
关于拉丁方与完全平衡在控制顺序效应上的优劣,研究界存在分歧:一方认为拉丁方在水平数较多时是唯一可行的顺序平衡方案,另一方指出拉丁方只平衡了位置效应而无法完全平衡处理间的相邻关系,对遗留效应的控制弱于完全平衡,且当存在非对称遗留效应时可能引入偏差。1818Experimental Design: Latin Square Designitl.nist.gov前往参考资料 ↓在新标签页中打开|1919Counterbalancing and Latin Square Designsmethods.sagepub.com前往参考资料 ↓在新标签页中打开
对立说法支持拉丁方的一方认为,在 k≥5 时完全平衡不可行,拉丁方以 n 个顺序实现了位置平衡,是实践中最优的折中方案。1818Experimental Design: Latin Square Designitl.nist.gov前往参考资料 ↓在新标签页中打开
对立说法批评方认为,拉丁方对一阶遗留效应的平衡不完整,若遗留效应显著,应改用平衡拉丁方或增加洗脱期(washout),而非简单拉丁方。1919Counterbalancing and Latin Square Designsmethods.sagepub.com前往参考资料 ↓在新标签页中打开
抵消平衡
抵消平衡(counterbalancing)是被试内设计中用来控制顺序效应与遗留效应的一类方法的总称:其基本思路是把所有实验条件的呈现顺序在被试之间(或同一被试的多次测量之间)加以系统安排,使练习、疲劳、适应等随时间线性或非线性变化的因素对各条件的影响在平均意义上相互抵消,而不是让某一条件总是处在有利或不利的位置。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
完全的被试内设计(complete within-subjects design)是把所有可能的条件顺序都排出来进行实验,以抵消练习或疲劳作用的影响,因此又常被称为“重复测量设计”;其代价是所需顺序数随条件数呈阶乘增长,条件较多时全部排列不可行。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
ABBA 平衡法是条件数为两个(记为 A、B)时最常用的抵消平衡方案:被试按 A→B→B→A 的顺序接受四次处理,A 与 B 各出现两次,且 A 在 B 之前一次、之后一次,反之亦然。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
ABBA 法之所以能抵消顺序效应,前提是假设顺序误差随时间按线性方式系统变化:在 A、B、B、A 的安排下,A 处理所处的总顺序位置为 1+4=5,B 处理为 2+3=5,两者平均顺序位置相同,因而线性漂移在条件间被抵消。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
ABBA 法的有效性依赖于“顺序误差随时间线性变化”这一假设;若练习或疲劳效应呈非线性(如陡峭的初始学习曲线或末段饱和),简单的 ABBA 只能部分抵消,甚至可能引入残余偏差,因此条件数较多或效应曲线明显非线性时通常改用随机区组或拉丁方类平衡方案。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
对立说法也有教材立场认为,只要顺序误差是单调的(不限于严格线性),ABBA 的对称结构即可在平均意义上把一阶趋势抵消掉,因此不必对线性假设作过强限定,ABBA 在多数两条件实验中已足够稳健。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
随机区组设计是另一种完全的被试内设计:实验条件以随机方式排序,但为了平衡练习效应,每一种排列都必须呈现很多次;其关键在于“组内同质、组间有差别”,即先按被试的某个无关变量(如性别)划分区组,再在区组内随机分配条件顺序,从而把组间变异分离出来、降低均方误差(MSE)。11[科普中国]-被试内设计- · 科普中国网kepuchina.cn前往参考资料 ↓在新标签页中打开
实验设计符号法中的表示
在 Rouanet 与 Lépine(1977)提出的实验设计符号法中,每个条件(因素)用一个字母加一个表示水平数的小数字表示,例如三个刺激持续时间写作 D3;被试本身也被当作一个特殊条件,N 名被试写作 S^N。2020title: 实验设计符号法raw.githubusercontent.com前往参考资料 ↓在新标签页中打开
该符号法只有两个基本算子:尖括号 < > 表示「框定」(nesting/filtering),通常用于在被试之间变化的因素;乘号 × 表示「交叉」(crossing),通常用于在被试内变化的因素。2020title: 实验设计符号法raw.githubusercontent.com前往参考资料 ↓在新标签页中打开
按这一约定,被试内设计写成被试条件与各被试内因素之间用 × 相连的形式,例如 Posner 线索化范式(线索侧 C2 × 目标侧 T2,两者都在被试内变化)写作 S^N × C2 × T2。2020title: 实验设计符号法raw.githubusercontent.com前往参考资料 ↓在新标签页中打开
与之相对,被试间设计中被试条件与被试间因素之间用 < > 框定,例如把被试嵌套进被试间条件写作 S^N < B2;同一符号法可以同时表达混合设计,即被试间因素用 < >、被试内因素用 × 并列书写。2020title: 实验设计符号法raw.githubusercontent.com前往参考资料 ↓在新标签页中打开
该符号法允许省略与研究问题无关的因素(例如刺激出现在屏幕左侧还是右侧),因此同一实验设计往往有多种合法写法,符号串并非唯一。2020title: 实验设计符号法raw.githubusercontent.com前往参考资料 ↓在新标签页中打开
Rouanet–Lépine 符号法并非实验心理学中唯一的设计记号体系;文献中并存的还有以被试内/被试间字母标注的简化写法、以及基于方差分析线性模型的记号,不同教材采用的约定并不统一,因此跨文献阅读时符号串不能直接照搬。2020title: 实验设计符号法raw.githubusercontent.com前往参考资料 ↓在新标签页中打开
对立说法也有教材主张符号法只是教学辅助工具,各体系之间可以一一对应转换,实际分歧仅在书写习惯而非表达力。2020title: 实验设计符号法raw.githubusercontent.com前往参考资料 ↓在新标签页中打开
| 设计类型 | 因素结构 | 符号写法 | 算子含义 |
|---|---|---|---|
| 纯被试内 | 线索侧 C2、目标侧 T2 均在被试内变化 | S^N × C2 × T2 | × 表示交叉(被试内) |
| 纯被试间 | 被试嵌套于被试间条件 B2 | S^N < B2 | < > 表示框定(被试间) |
| 混合设计 | 被试间因素 B2 + 被试内因素 C2 | S^N < B2 × C2 | < > 与 × 并用 |
统计分析方法
配对样本 t 检验
当被试内设计(被试内设计)只包含一个两水平自变量时,最直接的分析方法是配对样本 t 检验(paired-samples t test,亦称相关样本 t 检验、dependent t test):它对每个被试在两种条件下的得分先求差,再检验这些差值分数的均值是否显著不为零。2222Correlated Pairs t-test (Online Statistics Book, Chapter 10)onlinestatbook.com前往参考资料 ↓在新标签页中打开|2323Introduction to Correlation and Regression / Correlated Pairs (Online Statistics Book)onlinestatbook.com前往参考资料 ↓在新标签页中打开
配对样本 t 检验与独立样本 t 检验在数学上并不等价:前者以每个被试自身为对照,把被试间的稳定差异从误差项中剔除,因此差值分数的标准误通常小于两组均值之差的标准误,在同样的均值差下得到更大的 t 值。2222Correlated Pairs t-test (Online Statistics Book, Chapter 10)onlinestatbook.com前往参考资料 ↓在新标签页中打开
Online Statistics Book 给出的教学示例中,同一批被试内两条件数据用配对样本 t 检验得到显著结果,而误用独立样本 t 检验则不显著;教材明确指出这一差异的来源不是均值差变大(两种算法的均值差完全相同),而是配对检验缩小了差值标准误。2222Correlated Pairs t-test (Online Statistics Book, Chapter 10)onlinestatbook.com前往参考资料 ↓在新标签页中打开
配对样本 t 检验的 t 统计量等于对同一数据做重复测量方差分析所得 F 值的平方根,即 t = √F;因此两水平被试内设计用配对 t 检验与用重复测量 ANOVA 在推断结论上等价。2323Introduction to Correlation and Regression / Correlated Pairs (Online Statistics Book)onlinestatbook.com前往参考资料 ↓在新标签页中打开
配对样本 t 检验的统计效力依赖于两条件得分之间的相关:相关越高,差值分数的方差越小,检验越有力;若两条件相关接近零甚至为负,配对带来的标准误缩减就会消失,此时配对 t 检验相对独立样本检验的优势不复存在。2222Correlated Pairs t-test (Online Statistics Book, Chapter 10)onlinestatbook.com前往参考资料 ↓在新标签页中打开
重复测量方差分析
重复测量方差分析(repeated measures ANOVA)是被试内设计最常用的推断统计方法:它把同一被试在不同处理条件下的多次观测视为相关观测,从而把「被试」这一变异源从误差项中分离出去。其模型可写为 Y_ij = μ + S_i + τ_j + ε_ij,其中 S_i 为被试效应、τ_j 为处理(条件)效应;由于每个被试接受全部处理,S_i 与 τ_j 在设计上不混杂,这正是被试内设计相对被试间设计在统计上的核心优势。2424Repeated Measures ANOVAstatistics.laerd.com前往参考资料 ↓在新标签页中打开
在单因素被试内设计中,处理效应的 F 检验为 F = MS_处理 / MS_误差,其中误差项是「被试×处理」交互项(也称残差项),而不是被试间设计中的被试内误差;自由度分别为 df_处理 = k − 1、df_误差 = (n − 1)(k − 1),k 为条件数、n 为被试数。分母误差项的缩小是重复测量设计统计效力更高的直接来源。2424Repeated Measures ANOVAstatistics.laerd.com前往参考资料 ↓在新标签页中打开
重复测量方差分析依赖球形性(sphericity)假设:任意两个条件之差的方差相等。当条件数 k ≥ 3 时该假设可能被违反,违反时未校正的 F 检验第一类错误率会膨胀,因此需要用 Mauchly 检验来诊断,并采用 Greenhouse–Geisser 或 Huynh–Feldt 校正自由度。2525Sphericity and Repeated Measures ANOVAreal-statistics.com前往参考资料 ↓在新标签页中打开|2626Greenhouse-Geisser and Huynh-Feldt Correctionsncss.com前往参考资料 ↓在新标签页中打开
Greenhouse–Geisser 校正把自由度乘以一个估计的 ε(0 < ε ≤ 1),ε 越小校正越保守;Huynh–Feldt 校正使用另一个 ε 估计,通常比 Greenhouse–Geisser 保守程度低、效力更高,但在样本量小或球形性严重违反时可能偏松。两者都只调整自由度而不改变 F 值本身。2525Sphericity and Repeated Measures ANOVAreal-statistics.com前往参考资料 ↓在新标签页中打开|2626Greenhouse-Geisser and Huynh-Feldt Correctionsncss.com前往参考资料 ↓在新标签页中打开
当球形性假设成立时,重复测量方差分析与混合效应模型(多层模型)在固定效应估计上等价;但混合效应模型允许处理缺失数据、被试间间隔不等以及更灵活的协方差结构,因此在纵向与临床试验数据中被更广泛推荐。这一「等价—替代」关系是当前方法学文献的共识,而非对立观点。2727Effect Sizes for Repeated Measures Designsfrontiersin.org前往参考资料 ↓在新标签页中打开
关于「球形性违反时该用哪种校正」存在方法学分歧:一部分文献主张默认报告 Greenhouse–Geisser 校正,另一部分主张在 ε 估计较可靠时优先 Huynh–Feldt,还有一派主张直接改用混合效应模型或稳健方差估计以绕开球形性问题。因此「哪种做法最优」属于 contested 而非定论。2525Sphericity and Repeated Measures ANOVAreal-statistics.com前往参考资料 ↓在新标签页中打开|2626Greenhouse-Geisser and Huynh-Feldt Correctionsncss.com前往参考资料 ↓在新标签页中打开
对立说法主张默认使用 Greenhouse–Geisser 校正,因为它在小样本下更保守、第一类错误控制更稳。2525Sphericity and Repeated Measures ANOVAreal-statistics.com前往参考资料 ↓在新标签页中打开
对立说法主张在 ε 估计可靠时优先 Huynh–Feldt,因为其效力更高且第一类错误仍可接受。2626Greenhouse-Geisser and Huynh-Feldt Correctionsncss.com前往参考资料 ↓在新标签页中打开
对立说法主张放弃校正路线,直接采用混合效应模型或稳健标准误,以回避球形性假设本身。31
在多因素被试内设计中,重复测量方差分析可同时检验多个被试内因素及其交互,但每个效应各自对应不同的误差项(如被试×因素A、被试×因素B、被试×A×B),球形性假设需对每个含 3 个及以上水平的效应分别检验与校正。2424Repeated Measures ANOVAstatistics.laerd.com前往参考资料 ↓在新标签页中打开
效应量方面,重复测量设计常用偏 eta 方(partial η²)或广义 eta 方(generalized η²)报告,前者在含多个因素时各效应之和可超过 1,后者更适合跨研究比较;方法学文献提醒不要把偏 eta 方与经典 eta 方混用。2727Effect Sizes for Repeated Measures Designsfrontiersin.org前往参考资料 ↓在新标签页中打开|2828Generalized Eta Squaredsciencedirect.com前往参考资料 ↓在新标签页中打开
球形性与校正
球形性(sphericity)是被试内设计进行重复测量方差分析时的核心假设:它要求任意两个处理水平之差的方差相等,等价于说这些差值的协方差矩阵满足「球形」结构;当球形性成立时,F 检验的 p 值才在名义显著性水平上准确。2929Help for package DMARcran.r-project.org前往参考资料 ↓在新标签页中打开
球形性假设在只有两个水平(如前后测)的被试内设计中自动满足,因为此时差值只有一个,方差相等无从违反;球形性问题只在三个及以上水平时才会出现。2929Help for package DMARcran.r-project.org前往参考资料 ↓在新标签页中打开
当球形性被违反时,未校正的重复测量 F 检验会变得过于宽松(liberal),即第一类错误率高于名义 α,自由度越多、违反越严重,膨胀越明显。2929Help for package DMARcran.r-project.org前往参考资料 ↓在新标签页中打开
Mauchly 检验是检验球形性最常用的方法,其原假设为球形性成立;但该检验在小样本时功效很低、在大样本时又过于敏感,因此实践中普遍建议不把它当作唯一的决策依据,而应结合 Greenhouse–Geisser ε 等描述性指标判断。2929Help for package DMARcran.r-project.org前往参考资料 ↓在新标签页中打开
对立说法另一派意见认为,Mauchly 检验作为球形性的正式检验仍应保留在报告流程中,只要同时报告 ε 估计值并说明校正策略,检验结果本身并不构成误导。2929Help for package DMARcran.r-project.org前往参考资料 ↓在新标签页中打开
Greenhouse–Geisser(GG)校正是最常用的球形性校正方法:它用 ε 估计值(0 < ε ≤ 1)去乘组内效应的分子与分母自由度,ε 越小校正越保守;当 ε = 1 时退化为不校正。2929Help for package DMARcran.r-project.org前往参考资料 ↓在新标签页中打开
Huynh–Feldt(HF)校正是 GG 的改良版本,其 ε 估计通常大于 GG 的 ε,因而在球形性轻度违反时更少损失统计效力;但 HF 的 ε 估计可能超过 1,此时按惯例截断为 1。2929Help for package DMARcran.r-project.org前往参考资料 ↓在新标签页中打开
在球形性严重违反且样本量较小的情况下,多变量方法(如基于 Wilks' Lambda、Pillai 迹的重复测量多元检验)不需要球形性假设,可作为校正 F 检验的替代方案;但其代价是要求样本量大于水平数,且在小样本时功效偏低。2929Help for package DMARcran.r-project.org前往参考资料 ↓在新标签页中打开
混合效应模型(如以被试为随机截距的线性混合模型)不要求球形性,通过显式建模方差–协方差结构(如复合对称、AR(1)、非结构化)来处理重复测量间的相关,因而在缺失数据和不平衡设计下比传统重复测量方差分析更稳健,近年来越来越多地被推荐为首选分析路径。2929Help for package DMARcran.r-project.org前往参考资料 ↓在新标签页中打开
对立说法也有方法学者主张,在样本量小、水平数少、数据完全平衡的经典实验情境下,经 GG/HF 校正的重复测量方差分析仍然更简洁、更易解释,混合模型并非在所有场合都优于校正后的方差分析。2929Help for package DMARcran.r-project.org前往参考资料 ↓在新标签页中打开
典型应用领域
认知心理学实验
在认知心理学中,被试内设计最经典的应用是反应时实验:同一名被试在多个实验条件下重复完成同一任务,通过比较各条件下的平均反应时与错误率来推断心理过程。例如斯特鲁普(Stroop)色词干扰任务中,同一被试既完成字义与颜色一致的试次,也完成不一致的试次,两种条件间的反应时差即「斯特鲁普效应」;这种设计把个体阅读速度、色觉等稳定差异从误差项中剔除,使效应量估计更灵敏。3030Studies of interference in serial verbal reactionsdoi.org前往参考资料 ↓在新标签页中打开|3131Half a century of research on the Stroop effect: An integrative reviewdoi.org前往参考资料 ↓在新标签页中打开
记忆研究是被试内设计的另一核心应用场景。在系列位置效应、词表学习、提取练习(testing effect)等范式中,研究者通常让同一被试学习多个词表或接受多种编码/提取条件,并在被试内比较回忆或再认成绩;由于词表之间需要相互区分,这类设计必须配合词表轮换与填充任务来控制前摄抑制与倒摄抑制等遗留效应。3232Human memory: A proposed system and its control processesdoi.org前往参考资料 ↓在新标签页中打开|3333The testing effect: A review and meta-analysisdoi.org前往参考资料 ↓在新标签页中打开
注意与知觉研究大量采用被试内设计:视觉搜索任务中同一被试在多种设置大小(set size)与干扰条件间重复,空间线索化范式(Posner cueing)中同一被试接受有效线索、无效线索与中性线索三种条件,均以被试内比较来分离注意定向的易化与返回抑制等成分。3434Orienting of attentiondoi.org前往参考资料 ↓在新标签页中打开|3535Visual search and stimulus similaritydoi.org前往参考资料 ↓在新标签页中打开
心理语言学中的启动范式(语义启动、掩蔽启动)几乎默认采用被试内设计:同一被试在大量「启动词—目标词」配对中既经历相关配对也经历无关配对,通过反应时差测量启动量;由于单个被试可贡献成百上千个试次,被试内设计在此类研究中同时满足了对试次数与统计效力的要求。3636Semantic priming and the lexical decision task: A reviewdoi.org前往参考资料 ↓在新标签页中打开
在认知神经科学中,事件相关电位(ERP)与功能性磁共振成像(fMRI)实验普遍采用被试内设计:同一被试在扫描或记录中重复接受多种条件,条件间对比在被试内完成,再对被试间做随机效应统计;这种安排既提高了对微弱血氧或电生理信号的检出能力,也便于把条件效应与个体解剖、头型差异分离。3737Statistical analysis of fMRI datamitpress.mit.edu前往参考资料 ↓在新标签页中打开
认知心理学实验中被试内设计的广泛使用,与试次层面的随机化与平衡技术(如伪随机化、拉丁方平衡条件顺序)的成熟直接相关;这些技术使同一被试承受的多条件序列在总体上保持顺序平衡,从而把顺序效应转化为可估计的误差而非系统性偏差。3838Counterbalancing and Latin square designs in within-subjects experimentsdoi.org前往参考资料 ↓在新标签页中打开
关于被试内设计在认知实验中是否总是更优,研究界存在分歧:一方强调其控制个体差异、提高效力的优势,另一方指出在涉及学习、练习或疲劳的任务中,条件间污染难以完全消除,此时被试间设计或混合设计可能给出更可解释的结论。3939Experimental and quasi-experimental designs for researcharchive.org前往参考资料 ↓在新标签页中打开|4040Within-subjects designs: To use or not to use?doi.org前往参考资料 ↓在新标签页中打开
对立说法有方法学文献主张,只要条件顺序经过恰当平衡并设置足够的间隔与填充任务,被试内设计在学习类任务中仍可给出无偏的条件比较,其效力优势通常超过遗留效应带来的风险。3838Counterbalancing and Latin square designs in within-subjects experimentsdoi.org前往参考资料 ↓在新标签页中打开
临床交叉试验
临床交叉试验(crossover trial)是被试内设计在临床研究中最典型的形态:同一受试者在不同治疗期依次接受两种或多种干预,受试者自身充当对照,因此组间比较转化为同一受试者不同时期数据的比较。4141Crossover trials: what are they and what are their advantages and limitations?s4be.cochrane.org前往参考资料 ↓在新标签页中打开|4242Crossover studyen.wikipedia.org前往参考资料 ↓在新标签页中打开
交叉试验最适用的情形是慢性、稳定性疾病(如高血压、哮喘、慢性疼痛、癫痫)的疗效比较:这类疾病的病情在短期内相对稳定,使得「同一受试者在不同时期处于可比状态」这一被试内设计的前提大致成立。4141Crossover trials: what are they and what are their advantages and limitations?s4be.cochrane.org前往参考资料 ↓在新标签页中打开|4343Crossover Trials: Design, Analysis, and Reportingpmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
在样本量上,交叉试验的主要吸引力在于效率:由于消除了受试者间变异,达到同等统计效力所需的受试者数通常显著少于平行组设计,这在罕见病、儿科或招募困难的临床场景中尤为关键。4141Crossover trials: what are they and what are their advantages and limitations?s4be.cochrane.org前往参考资料 ↓在新标签页中打开|4242Crossover studyen.wikipedia.org前往参考资料 ↓在新标签页中打开
生物等效性(bioequivalence)评价是交叉试验最标准化的应用:药代动力学参数(AUC、Cmax)的比较通常采用两制剂、两序列、两周期的 2×2 交叉设计,受试者随机分入先试验药后参比药或相反顺序,周期间设洗脱期。4444Guideline on the Investigation of Bioequivalenceema.europa.eu前往参考资料 ↓在新标签页中打开
监管机构对生物等效性交叉试验的洗脱期有明确要求:洗脱期长度须足以使前一期的药物完全消除,通常取不少于 5 个消除半衰期,以避免遗留效应污染后一期的测量。4444Guideline on the Investigation of Bioequivalenceema.europa.eu前往参考资料 ↓在新标签页中打开
在剂量—反应关系研究中,交叉设计允许同一受试者接受多个剂量水平,从而在个体内估计剂量效应曲线,避免了平行组设计中个体差异对剂量效应估计的干扰。4141Crossover trials: what are they and what are their advantages and limitations?s4be.cochrane.org前往参考资料 ↓在新标签页中打开|4343Crossover Trials: Design, Analysis, and Reportingpmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
交叉试验在临床应用中面临的核心威胁是顺序效应与遗留效应:若前一期的治疗效应未完全消退,或受试者的状态因参与第一期而系统性改变,则后一期的比较会产生偏倚,这也是交叉设计在急性病、可治愈疾病中不适用的原因。4141Crossover trials: what are they and what are their advantages and limitations?s4be.cochrane.org前往参考资料 ↓在新标签页中打开|4242Crossover studyen.wikipedia.org前往参考资料 ↓在新标签页中打开
对于急性发作或病情快速变化的疾病(如急性感染、急性疼痛发作),交叉试验通常不被采用,因为受试者在不同时期的基线状态不可比,被试内设计的前提被破坏。4141Crossover trials: what are they and what are their advantages and limitations?s4be.cochrane.org前往参考资料 ↓在新标签页中打开|4343Crossover Trials: Design, Analysis, and Reportingpmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
交叉试验的报告需遵循 CONSORT 扩展声明(CONSORT extension for crossover trials),该声明要求明确报告随机化序列、洗脱期长度、是否检验顺序效应与遗留效应,以及脱落受试者的处理方式。4545CONSORT extension for randomised crossover trialsconsort-statement.org前往参考资料 ↓在新标签页中打开
关于交叉试验中是否应常规进行顺序效应检验,统计界存在分歧:一派主张对顺序效应(尤其是遗留效应)进行正式检验并据此选择分析模型,另一派指出该检验的统计效力通常很低,阴性结果不能证明无遗留效应,主张直接采用更保守的分析方法。4242Crossover studyen.wikipedia.org前往参考资料 ↓在新标签页中打开|4646Analysis of crossover trialspmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对立说法部分方法学文献认为,常规的顺序效应检验在样本量有限时几乎无法检出真实存在的遗留效应,因此不应以检验结果作为分析策略的依据,而应默认采用仅基于第一期数据的保守分析或混合效应模型。4646Analysis of crossover trialspmc.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
对立说法另一些指南与教科书则建议在分析中报告顺序效应的检验结果,以便读者判断遗留效应的可能影响。4242Crossover studyen.wikipedia.org前往参考资料 ↓在新标签页中打开
fMRI 脑成像
功能性磁共振成像(fMRI)是被试内设计最典型的应用场景之一:同一名被试在扫描仪内反复接受多个条件(不同刺激类型、不同任务难度、不同药物或刺激状态),每个条件各采集一长串时间序列,条件间的比较在被试内部完成,个体差异(头形、脑沟回形态、血管反应幅度、注意力水平)因此被大幅吸收。4747杭州师范大学学报(自然科学版)hsfz.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
静息态 fMRI(resting-state fMRI, rsfMRI)要求被试在扫描期间不执行任何任务,只保持清醒放松,信号主要反映脱氧血红蛋白变化所间接指示的神经元活动;由于同一被试可以在一段时间内被重复扫描多次,它天然适合用被试内设计来比较「刺激前 / 刺激后」或「基线 / 干预后」的功能连接变化。4747杭州师范大学学报(自然科学版)hsfz.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
在 rTMS 与脑成像结合的研究中,一种常见做法是把健康被试随机分到不同刺激组,再对同一批被试在刺激前后各做一次静息态扫描,用功能连接(FC)与图论分析刻画大脑功能网络拓扑属性的改变——这类「前后测」结构本质上是被试内(重复测量)设计,随机分组只用于在组间比较时控制顺序与期望。4747杭州师范大学学报(自然科学版)hsfz.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
fMRI 的被试内设计通常以「run / session」为单位组织:一名被试在一次扫描中完成若干 run,每个 run 内条件按伪随机顺序呈现,条件顺序在被试间再行平衡,从而把顺序效应摊平到被试间而不是污染条件对比。4747杭州师范大学学报(自然科学版)hsfz.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
fMRI 时间序列的自相关结构使被试内条件的方差估计不能直接套用普通最小二乘,需要在个体水平用 AR(1) 或类似模型做预白化,再在组水平做被试内(重复测量)方差分析或混合效应模型;这也是 fMRI 统计中「个体水平—组水平」两阶段流程的由来。4747杭州师范大学学报(自然科学版)hsfz.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
关于 fMRI 被试内设计是否真的比被试间设计更高效,研究界存在分歧:支持者强调个体内对比能剔除大量个体差异方差、在同样扫描时长下获得更高统计效力;批评者指出 BOLD 信号的低信噪比、头动、生理噪声与扫描间漂移会在被试内条件下引入相关误差,使有效自由度远低于名义样本量,实际增益可能被高估。4747杭州师范大学学报(自然科学版)hsfz.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
对立说法被试内对比在 fMRI 中并不总能提高效力:同一被试不同条件的扫描往往相隔数分钟至数周,扫描间漂移、头动与生理噪声会在条件间产生相关误差,使有效自由度低于名义值。4747杭州师范大学学报(自然科学版)hsfz.cbpt.cnki.net前往参考资料 ↓在新标签页中打开
主观音质评价
主观音质评价是被试内设计最典型的应用场景之一:在语音与音频质量研究中,同一名听者(被试)通常要在一次实验里连续听多个刺激或处理条件(编解码器、码率、丢包模式、网络损伤条件等),并对每个条件逐一打分,从而把「听者个体差异」这一巨大变异源从误差项中剔除。国际电信联盟的语音质量主观评测建议书 ITU-T P.800 与 P.835 即按此逻辑组织:每位受试者听完整个刺激集合后给出评分,实验内比较的是同一批受试者在不同处理条件上的差异。4848Multi-episodic Perceived Qualityof an Audio-on-Demand Servicearxiv.org前往参考资料 ↓在新标签页中打开
在音频点播(Audio-on-Demand)服务的体验质量(QoE)研究中,Guse 等人(2020)采用被试内、多片段(multi-episodic)的听音实验:同一批受试者先后经历不同「低性能片段(LP episode)」注入方案(如 C1–C5 条件),再对整体多片段质量给出判断。论文表 IV 报告了各条件下的多片段判断均值与标准差(例如 C5 条件为 2.5,括号内为标准差 1.0),这正是被试内设计在主观音质评价中的典型数据形态——同一受试者跨越多个条件,条件间比较以受试者为自身对照。4848Multi-episodic Perceived Qualityof an Audio-on-Demand Servicearxiv.org前往参考资料 ↓在新标签页中打开
主观音质评价之所以偏好被试内设计,是因为听者之间的评分尺度差异极大:有人习惯给高分、有人习惯给低分,这种「评分者严苛度」差异若放在被试间设计中会直接进入误差项,淹没处理效应;而让每位听者评价所有条件,等于让每个人充当自己的基线,处理效应以受试者内差值的形式呈现,统计效力显著提高。这也是 ITU-T 系列语音质量主观测试建议书普遍要求同一受试者听完所有条件的原因。4848Multi-episodic Perceived Qualityof an Audio-on-Demand Servicearxiv.org前往参考资料 ↓在新标签页中打开
主观音质评价中的被试内设计必须直面顺序效应与遗留效应:听者在前一个条件中形成的适应水平、疲劳程度、对刺激内容的熟悉度,都会带入后续条件。因此标准做法是在条件间插入填充刺激、对条件顺序做拉丁方平衡或随机化,并在分析时检验顺序效应是否显著。Guse 等人的多片段实验同样需要处理「前一片段的质量体验如何影响后续整体判断」这一遗留效应问题,这正是该研究比较单日与双日低性能片段方案(C1 vs. C3、C4 vs. C5)的动机之一。4848Multi-episodic Perceived Qualityof an Audio-on-Demand Servicearxiv.org前往参考资料 ↓在新标签页中打开
主观音质评价中被试内设计的另一典型变体是重复测量:同一受试者对同一条件听多次(或同一刺激的多个副本),以估计评分信度并降低单次评分的随机误差。ITU-T P.800 的绝对类别评分(ACR)与降级类别评分(DCR)方法均要求每位受试者对每个条件给出多次判断,最终以受试者内均值作为该条件的 MOS(平均意见分)。4848Multi-episodic Perceived Qualityof an Audio-on-Demand Servicearxiv.org前往参考资料 ↓在新标签页中打开
被试内设计在主观音质评价中的适用边界也受到讨论:当刺激集合很大(例如数十种编解码器与码率组合)时,单个受试者听完所有条件会导致严重疲劳与注意力衰减,此时研究者往往改用被试间设计、分组被试内设计(each subject 只评价部分条件)或自适应方法。因此「主观音质评价一律用被试内设计」并不成立,实际选择取决于条件数量、单次刺激时长与可用受试者规模。4848Multi-episodic Perceived Qualityof an Audio-on-Demand Servicearxiv.org前往参考资料 ↓在新标签页中打开
对立说法另一种观点认为,即便条件数量较多,也应优先保证被试内比较,因为听者间差异带来的误差膨胀远大于疲劳带来的误差;可通过缩短单次实验、分多次会话(multi-session)的方式在保持被试内的同时控制疲劳。4848Multi-episodic Perceived Qualityof an Audio-on-Demand Servicearxiv.org前往参考资料 ↓在新标签页中打开
大型析因被试内设计的效率问题
完全析因设计的规模膨胀
在完全析因的被试内设计中,若实验包含 k 个自变量、每个自变量有 l 个水平,则每个被试需要接受的全部处理组合数为 l^k;当 k 或 l 增大时,处理组合数呈指数增长,这是「规模膨胀」的最基本来源。4949Within-Subjects Designmethods.sagepub.com前往参考资料 ↓在新标签页中打开
由于每个被试都要接受全部 l^k 个处理组合,总观测数等于被试数 n 乘以 l^k;即使只增加一个二水平自变量,单个被试的试次数也会翻倍,实验时长与疲劳负担随之线性甚至超线性上升。4949Within-Subjects Designmethods.sagepub.com前往参考资料 ↓在新标签页中打开
当处理组合数超过单个被试在单次实验中所能承受的合理时长时,实践中的常见做法是把部分自变量改为被试间因素(混合设计)或采用分块、拉丁方部分平衡,但这会牺牲对相应交互作用的估计能力。4949Within-Subjects Designmethods.sagepub.com前往参考资料 ↓在新标签页中打开|5050Design and Analysis of Experimentswiley.com前往参考资料 ↓在新标签页中打开
有方法学文献指出,随着析因结构增大,高阶交互项(三阶及以上)的效应量通常很小且难以解释,继续以完全析因方式估计它们,在统计效率上并不划算,这是主张对大型析因采用部分析因或筛选设计的主要论据之一。5050Design and Analysis of Experimentswiley.com前往参考资料 ↓在新标签页中打开
对立说法反对意见认为,高阶交互是否可忽略依赖于具体研究领域,在心理学与行为科学中三阶交互有时正是理论焦点,不能一概以「效应量小」为由放弃完全析因。4949Within-Subjects Designmethods.sagepub.com前往参考资料 ↓在新标签页中打开
细分大型实验的策略
当被试内设计包含多个被试内因素时,全部处理组合数随因素数呈乘积式增长:k 个各含两水平的因素产生 2^k 个组合,若每组合重复 r 次,则单个被试需完成 r·2^k 次观测。因此因素数每增加一个,所需试次至少翻倍,这是大型析因被试内设计效率问题的算术根源。1616Experimental Design: Procedures for the Behavioral Sciences (4th ed.)us.sagepub.com前往参考资料 ↓在新标签页中打开
在大型析因被试内设计中,把全部因素完全交叉(full factorial)往往不可行,常见策略是放弃高阶交互作用、只估计主效应与低阶交互,即采用部分析因(fractional factorial)或裂区式(split-plot)安排,把部分因素改为被试间或区组因素,以换取每个被试可完成的试次量。1616Experimental Design: Procedures for the Behavioral Sciences (4th ed.)us.sagepub.com前往参考资料 ↓在新标签页中打开|5151Split-Plot Designs: What, Why, and Howtandfonline.com前往参考资料 ↓在新标签页中打开
裂区式安排(split-plot design)把难以在单个被试内完全操纵的因素放到区组/被试间层,其余因素保留在被试内层,从而在统计上以混合误差项分别检验被试间与被试内效应;这是心理学与农学实验设计中处理“因素多、单被试容量有限”的标准折中方案。5151Split-Plot Designs: What, Why, and Howtandfonline.com前往参考资料 ↓在新标签页中打开
当无法在单个被试内实现完全交叉时,另一种细分策略是把大型析因拆成若干个小规模被试内实验分别实施,再通过合并分析(pooled analysis)或元分析式整合估计各因素的效应;代价是不同实验间的被试样本不同,因素间的交互作用只能在实验间近似比较,而不能像完全交叉那样精确估计。1616Experimental Design: Procedures for the Behavioral Sciences (4th ed.)us.sagepub.com前往参考资料 ↓在新标签页中打开
在认知心理学与心理语言学中,大型析因被试内设计常采用拉丁方(Latin square)或平衡列表(counterbalanced list)把处理组合分配到不同被试组,使每个被试只完成全部组合的一个子集,从而在保持因素完全交叉的同时把单被试负担降到可接受水平;这种“被试内因素完全交叉、但被试间分配组合”的做法在统计上仍按被试内因素建模。5252The Design of Experimentsarchive.org前往参考资料 ↓在新标签页中打开
对于因素数很多但研究者主要关心主效应与少数交互的情形,Plackett–Burman 等筛选设计(screening design)可以用远少于完全析因的试次数估计各因素的主效应,常被用作大型析因研究的前置筛选步骤,再对筛出的关键因素做完全交叉的确认实验。5353Plackett–Burman Designs for Screening Experimentsitl.nist.gov前往参考资料 ↓在新标签页中打开
在大型析因被试内设计中,把部分因素改为被试间因素会降低被试内比较的统计效力,因为被试间效应无法利用个体差异控制这一被试内设计的核心优势;因此“细分”策略本质上是在试次负担、统计效力与可解释性之间做权衡,而非无代价的效率提升。1616Experimental Design: Procedures for the Behavioral Sciences (4th ed.)us.sagepub.com前往参考资料 ↓在新标签页中打开|5151Split-Plot Designs: What, Why, and Howtandfonline.com前往参考资料 ↓在新标签页中打开
关于大型析因被试内设计应优先采用“拆分为多个小实验”还是“保留完全交叉但用拉丁方分配组合”,研究界并无统一共识:前者降低单被试负担但削弱交互估计,后者保留交互结构但依赖较强的平衡假设与较大的被试样本。5252The Design of Experimentsarchive.org前往参考资料 ↓在新标签页中打开
对立说法支持拆分策略的一方认为,单被试完成数百个试次会引入疲劳与练习效应,使后期试次的数据质量下降,拆分更利于数据清洁。60
对立说法支持完全交叉加拉丁方的一方认为,拆分后不同实验的被试样本不同,因素间交互无法在个体水平上估计,损失了被试内设计的核心信息。5252The Design of Experimentsarchive.org前往参考资料 ↓在新标签页中打开
局限与争议
何时必须改用被试间设计
当实验任务涉及不可逆的学习或技能获得时,被试一旦完成一种条件就会发生持久的能力或知识变化,无法回到初始状态再接受另一种条件,此时被试内设计在逻辑上不可行,必须改用被试间设计。Thompson 与 Campbell 在演绎推理研究中指出,推理任务上的练习与策略发现会产生跨条件的迁移,使同一被试难以在多个条件间保持可比状态,因而在该领域比较被试内与被试间设计时,被试间设计在避免污染上具有不可替代的作用。1212A POWER STRUGGLE: BETWEEN- VS. WITHIN-SUBJECTS DESIGNS IN DEDUCTIVE REASONING RESEARCHjstage.jst.go.jp前往参考资料 ↓在新标签页中打开
当自变量的一个水平会永久改变被试的状态(如脑损伤、临床干预、教育训练、药物戒断),或条件本身在时间上不可重复(如一次性的重大生活事件),被试无法被分配到多个水平,只能采用被试间设计。这一限制属于设计层面的硬约束,而非统计效率问题。1212A POWER STRUGGLE: BETWEEN- VS. WITHIN-SUBJECTS DESIGNS IN DEDUCTIVE REASONING RESEARCHjstage.jst.go.jp前往参考资料 ↓在新标签页中打开
当顺序效应与遗留效应大到无法通过平衡、洗脱期或足够长的间隔加以控制时,被试内设计所引入的偏差可能超过其控制个体差异带来的收益,此时改用被试间设计是更稳妥的选择。Thompson 与 Campbell 在讨论推理研究的设计取舍时强调,被试内设计并非在所有任务上都优于被试间设计,任务性质决定了哪种设计更合适。1212A POWER STRUGGLE: BETWEEN- VS. WITHIN-SUBJECTS DESIGNS IN DEDUCTIVE REASONING RESEARCHjstage.jst.go.jp前往参考资料 ↓在新标签页中打开
对立说法另一种立场认为,只要采用恰当的平衡方案(如拉丁方)与足够的洗脱间隔,多数顺序效应可以被抵消,被试内设计在统计效力上的优势仍然值得保留,不应轻易退回被试间设计。1212A POWER STRUGGLE: BETWEEN- VS. WITHIN-SUBJECTS DESIGNS IN DEDUCTIVE REASONING RESEARCHjstage.jst.go.jp前往参考资料 ↓在新标签页中打开
当研究关注的是稳定的个体差异变量(如能力、人格、临床分组)与实验条件之间的交互,而个体差异本身无法在被试内操纵时,若强行采用被试内设计,个体差异变量会退化为被试内的恒定值,无法与条件形成可检验的交互,此时需要被试间设计或混合设计。1212A POWER STRUGGLE: BETWEEN- VS. WITHIN-SUBJECTS DESIGNS IN DEDUCTIVE REASONING RESEARCHjstage.jst.go.jp前往参考资料 ↓在新标签页中打开
当实验需要完全避免被试对实验假设的觉察与需求特征时,被试内设计会让同一被试经历所有条件,更容易识破研究目的并调整反应;在难以有效掩盖操纵的敏感研究中,被试间设计因每位被试只接触一个条件而具有更好的盲性。1212A POWER STRUGGLE: BETWEEN- VS. WITHIN-SUBJECTS DESIGNS IN DEDUCTIVE REASONING RESEARCHjstage.jst.go.jp前往参考资料 ↓在新标签页中打开
对立说法反对意见认为,需求特征可以通过封面故事、填充任务与双盲程序加以控制,且被试间设计同样存在猜测实验意图的问题,因此盲性不足以构成改用被试间设计的决定性理由。1212A POWER STRUGGLE: BETWEEN- VS. WITHIN-SUBJECTS DESIGNS IN DEDUCTIVE REASONING RESEARCHjstage.jst.go.jp前往参考资料 ↓在新标签页中打开
顺序效应能否被完全消除
顺序效应(order effect)指被试在接受多次处理时,练习、疲劳、适应、对比等随时间变化的因素使同一处理在不同呈现位置上产生不同结果;遗留效应(carryover effect)指前一处理的效果延续到后一处理。二者在被试内设计中无法通过随机分配被试来消除,只能通过设计手段加以平衡或抵消,因此「完全消除」在原理上不成立,实践中只能做到「均衡化」。99Within-Subjects Design: Definition, Examples & Pros/Conssimplypsychology.org前往参考资料 ↓在新标签页中打开
完全随机化(对每个被试独立随机排列处理顺序)只能把顺序效应在样本层面「平均掉」,使其期望值为零,而不能消除单个被试身上的顺序效应;当被试数较少或效应量较大时,随机化后的残余偏差仍会进入误差项,降低检验效力。5454Randomization and counterbalancing in repeated measures designsmethods.sagepub.com前往参考资料 ↓在新标签页中打开
ABBA 式平衡(block randomization / 对称排列)能抵消线性趋势(如线性练习效应),但对非线性趋势(如指数式疲劳、突然的阈下适应)以及不对称的遗留效应(前一处理只影响后一处理、反之不然)无能为力;当处理数 k 增大时,构造完全平衡的拉丁方所需被试数急剧上升,实践中常退化为不完全平衡设计。99Within-Subjects Design: Definition, Examples & Pros/Conssimplypsychology.org前往参考资料 ↓在新标签页中打开
洗脱期(washout period)是消除遗留效应的主要手段,但其有效性依赖对效应持续时间的先验假设;在药理学与临床研究中,洗脱期长度不足是遗留效应残留的常见原因,而洗脱期过长又会引入成熟、季节、病程自然波动等新的混淆。5555Crossover trials: carryover effects and washout periodstraining.cochrane.org前往参考资料 ↓在新标签页中打开|5656Design and Analysis of Cross-Over Trialsroutledge.com前往参考资料 ↓在新标签页中打开
关于「顺序效应能否被完全消除」,研究界存在明确分歧:一派认为通过充分平衡、随机化与洗脱期的组合,顺序效应在统计上可被降至可忽略水平,从而不影响处理效应的无偏估计;另一派(尤其在心理物理学与临床交叉试验方法学中)认为任何有限样本的平衡设计都只能抵消特定形式的顺序效应,无法保证对所有被试、所有处理组合都成立,因此「完全消除」是一种理想化假设而非可达状态。5555Crossover trials: carryover effects and washout periodstraining.cochrane.org前往参考资料 ↓在新标签页中打开
对立说法支持「可有效控制」的一方主张:在交叉试验中,只要采用恰当的随机化序列、足够的洗脱期并在分析模型中显式纳入周期(period)与顺序(sequence)效应,顺序效应就不会污染处理效应的估计,因而在操作意义上可视为被消除。5555Crossover trials: carryover effects and washout periodstraining.cochrane.org前往参考资料 ↓在新标签页中打开
对立说法持怀疑立场的一方指出:平衡设计只能保证顺序效应在样本均值上相互抵消,无法排除个体层面的不对称遗留效应;当处理间存在交互(如学习迁移)时,顺序效应与处理效应不可分离识别,此时任何统计校正都建立在不可检验的假设之上。63|99Within-Subjects Design: Definition, Examples & Pros/Conssimplypsychology.org前往参考资料 ↓在新标签页中打开
在统计上,顺序效应与处理效应存在可识别性问题:若不在模型中同时估计周期效应与顺序效应,二者会与处理效应共线;而在只有两个处理、两个周期的简单交叉设计中,顺序效应与处理×周期交互完全混淆,无法单独估计。这是「完全消除」主张在方法学上受到质疑的核心技术理由。5555Crossover trials: carryover effects and washout periodstraining.cochrane.org前往参考资料 ↓在新标签页中打开|5656Design and Analysis of Cross-Over Trialsroutledge.com前往参考资料 ↓在新标签页中打开
在 大语言模型 等机器学习领域常用的被试内式评测(同一模型在多个基准、多个提示顺序下测试)中,提示顺序、样例顺序造成的顺序效应已被实证观察到会改变模型表现,且这种效应随任务与模型不同而变化,难以用统一的平衡方案完全消除。5757Large Language Models Are Not Robust Multiple Choice Selectorsopenreview.net前往参考资料 ↓在新标签页中打开
对立说法有研究认为,通过对提示顺序做多种随机排列并取平均,可将顺序带来的方差压缩到可接受范围,从而在评测层面近似消除顺序效应。5757Large Language Models Are Not Robust Multiple Choice Selectorsopenreview.net前往参考资料 ↓在新标签页中打开
参考来源
- 1文档 [科普中国]-被试内设计- · 科普中国网 · 科普中国 · 2021-12-30 · 核验于 2026-10-20
- 2文档 2009年硕士研究生入学统一考试心理学模拟试题答案(5) · 中国研究生招生信息网 · 2008-11-24 · 核验于 2026-10-20
- 3标准 Recommendation ITU-R BS.2132-0:音质的主观评价方法 · 国际电信联盟(ITU-R) · 2019-10-01 · 核验于 2026-10-20
- 4文档 受试者内设计 | Bohrium · 激发塑形 | Bohrium · 2024-01-01 · 核验于 2026-10-20
- 5报道 图文详情 · 科普中国 · 2017-12-21 · 核验于 2026-10-20
- 6文档 银符考试题库-在线练习-考研心理学专业基础模拟32 · 试卷列表 · 2017-01-01 · 核验于 2026-10-20
- 7文档 Within-Subjects Design | Explanation, Approaches, Examples · Scribbr · 2023-03-29 · 核验于 2026-10-20
- 8文档 Between-Subjects vs. Within-Subjects Study Design · Nielsen Norman Group · 2024-01-26 · 核验于 2026-10-20
- 9文档 Within-Subjects Design: Definition, Examples & Pros/Cons · Simply Psychology · 2023-11-08 · 核验于 2026-10-20
- 10文档 Experimental Design: Within-Subjects vs. Between-Subjects · Statistics How To · 2022-06-15 · 核验于 2026-10-20
- 11文档 Within-Subjects Design: Advantages and Disadvantages · Explorable.com · 2021-03-20 · 核验于 2026-10-20
- 12文档 A POWER STRUGGLE: BETWEEN- VS. WITHIN-SUBJECTS DESIGNS IN DEDUCTIVE REASONING RESEARCH · J-Stage · 2005-02-25 · 核验于 2026-10-20
- 13文档 Counterbalancing · JoVE · 2024-01-01 · 核验于 2026-10-20
- 14文档 Experimental Psychology: A Case Approach (8th ed.) · Pearson / Allyn & Bacon · 2009-01-01 · 核验于 2026-10-20
- 15文档 Research Methods in Psychology (10th ed.) · McGraw-Hill Education · 2020-01-01 · 核验于 2026-10-20
- 16文档 Experimental Design: Procedures for the Behavioral Sciences (4th ed.) · SAGE Publications · 2013-01-01 · 核验于 2026-10-20
- 17论文 Repeated Measures Design: Carryover Effects and Counterbalancing · Annual Review of Psychology / methodology review · 2001-01-01 · 核验于 2026-10-20
- 18文档 Experimental Design: Latin Square Design · NIST/SEMATECH e-Handbook of Statistical Methods · 2012-04-01 · 核验于 2026-10-20
- 19文档 Counterbalancing and Latin Square Designs · SAGE Research Methods / Encyclopedia of Research Design · 2010-01-01 · 核验于 2026-10-20
- 20文档 title: 实验设计符号法 · GitHub · 2024-01-01 · 核验于 2026-10-20
- 21文档 Within-subjects designs - data · UMass Amherst · 2020-01-01 · 核验于 2026-10-20
- 22文档 Correlated Pairs t-test (Online Statistics Book, Chapter 10) · Online Statistics Book · 2020-01-01 · 核验于 2026-10-20
- 23文档 Introduction to Correlation and Regression / Correlated Pairs (Online Statistics Book) · Online Statistics Book · 2020-01-01 · 核验于 2026-10-20
- 24文档 Repeated Measures ANOVA · Laerd Statistics · 2023-01-01 · 核验于 2026-10-20
- 25文档 Sphericity and Repeated Measures ANOVA · Real Statistics Using Excel · 2023-01-01 · 核验于 2026-10-20
- 26文档 Greenhouse-Geisser and Huynh-Feldt Corrections · NCSS Statistical Software · 2021-01-01 · 核验于 2026-10-20
- 27论文 Effect Sizes for Repeated Measures Designs · Frontiers in Psychology · 2013-01-01 · 核验于 2026-10-20
- 28论文 Generalized Eta Squared · Olejnik & Algina, Contemporary Educational Psychology · 2003-01-01 · 核验于 2026-10-20
- 29文档 Help for package DMAR · The Comprehensive R Archive Network · 2026-09-06 · 核验于 2026-10-20
- 30论文 Studies of interference in serial verbal reactions · Journal of Experimental Psychology, 18(6), 643–662 · 1935-12-01 · 核验于 2026-10-20
- 31论文 Half a century of research on the Stroop effect: An integrative review · Psychological Bulletin, 109(2), 163–203 · 1991-03-01 · 核验于 2026-10-20
- 32论文 Human memory: A proposed system and its control processes · Psychology of Learning and Motivation, Vol. 2, 89–195 · 1968-01-01 · 核验于 2026-10-20
- 33论文 The testing effect: A review and meta-analysis · Psychological Bulletin, 140(6), 1432–1463 · 2014-11-01 · 核验于 2026-10-20
- 34论文 Orienting of attention · Quarterly Journal of Experimental Psychology, 32(1), 3–25 · 1980-02-01 · 核验于 2026-10-20
- 35论文 Visual search and stimulus similarity · Psychological Review, 96(3), 433–458 · 1989-07-01 · 核验于 2026-10-20
- 36论文 Semantic priming and the lexical decision task: A review · Journal of Memory and Language · 1999-01-01 · 核验于 2026-10-20
- 37文档 Statistical analysis of fMRI data · MIT Press · 2011-01-01 · 核验于 2026-10-20
- 38论文 Counterbalancing and Latin square designs in within-subjects experiments · Behavior Research Methods, Instruments, & Computers · 1996-01-01 · 核验于 2026-10-20
- 39文档 Experimental and quasi-experimental designs for research · Rand McNally · 1963-01-01 · 核验于 2026-10-20
- 40论文 Within-subjects designs: To use or not to use? · Psychological Bulletin, 83(2), 314–320 · 1976-03-01 · 核验于 2026-10-20
- 41文档 Crossover trials: what are they and what are their advantages and limitations? · Students 4 Best Evidence (Cochrane UK) · 2021-03-25 · 核验于 2026-10-20
- 42文档 Crossover study · Wikipedia · 2024-01-01 · 核验于 2026-10-20
- 43论文 Crossover Trials: Design, Analysis, and Reporting · PMC / National Library of Medicine · 2011-06-01 · 核验于 2026-10-20
- 44标准 Guideline on the Investigation of Bioequivalence · European Medicines Agency (EMA), CPMP/EWP/QWP/1401/98 Rev. 1/ Corr ** · 2010-01-20 · 核验于 2026-10-20
- 45标准 CONSORT extension for randomised crossover trials · CONSORT Group · 2019-01-01 · 核验于 2026-10-20
- 46论文 Analysis of crossover trials · PMC / National Library of Medicine · 2011-09-01 · 核验于 2026-10-20
- 47文档 杭州师范大学学报(自然科学版) · hsfz.cbpt.cnki.net · 2022-05-01 · 核验于 2026-10-20
- 48论文 Multi-episodic Perceived Qualityof an Audio-on-Demand Service · arXiv · 2020-04-30 · 核验于 2026-10-20
- 49文档 Within-Subjects Design · SAGE Research Methods / Encyclopedia of Research Design · 2010-01-01 · 核验于 2026-10-20
- 50文档 Design and Analysis of Experiments · Montgomery, D. C. / Wiley · 2019-01-01 · 核验于 2026-10-20
- 51论文 Split-Plot Designs: What, Why, and How · Jones, B. & Nachtsheim, C. J., Journal of Quality Technology, 41(4), 340–361 · 2009-10-01 · 核验于 2026-10-20
- 52文档 The Design of Experiments · Fisher, R. A., Oliver & Boyd (第 6 版及后续重印) · 1951-01-01 · 核验于 2026-10-20
- 53文档 Plackett–Burman Designs for Screening Experiments · NIST/SEMATECH e-Handbook of Statistical Methods, Section 5.3.3.4 · 2012-04-01 · 核验于 2026-10-20
- 54文档 Randomization and counterbalancing in repeated measures designs · Sage Research Methods · 2020-01-01 · 核验于 2026-10-20
- 55标准 Crossover trials: carryover effects and washout periods · Cochrane Handbook for Systematic Reviews of Interventions, Chapter 23 · 2023-08-01 · 核验于 2026-10-20
- 56论文 Design and Analysis of Cross-Over Trials · Chapman & Hall/CRC (book) · 2014-01-01 · 核验于 2026-10-20
- 57论文 Large Language Models Are Not Robust Multiple Choice Selectors · ICLR 2024 · 2024-01-01 · 核验于 2026-10-20