标注协议
- 英文
- Annotation Protocol / Annotation Guidelines
- 所属领域
- 数据标注、语料库语言学、机器学习数据工程
- 核心目标
- 标注一致性(inter-annotator agreement)与可靠性
- 常见组成
- 标签定义、判定规则、边界案例、标注流程、质量控制
- 常用度量
- Cohen's kappa、Krippendorff's alpha、Fleiss' kappa
- 典型应用
- 自然语言处理、计算机视觉、语音、医学影像标注
标注协议(annotation protocol / annotation guidelines)是数据标注任务中发给标注人员的书面规则,规定每个标签的含义、判定边界、标注流程与疑难情况的处理方式,目的是让不同标注者对同一对象给出一致的判断。11Developing Linguistic Corpora: A Guide to Good Practice — Annotationota.ox.ac.uk前往参考资料 ↓在新标签页中打开|22Crowdsourcing Annotation: A Surveyarxiv.org前往参考资料 ↓在新标签页中打开
定义与作用
协议与手册的区别
标注协议(annotation protocol)与标注手册(annotation manual/guidelines)常被混用,但二者在功能层级上不同:协议是规定标注任务如何被定义、执行、验证与维护的整套规则体系,手册则是这套规则面向标注者的书面呈现形式之一。55Natural Language Annotation for Machine Learningoreilly.com前往参考资料 ↓在新标签页中打开|66Crowdsourcing Annotation: A Surveyojs.aaai.org前往参考资料 ↓在新标签页中打开
在自然语言处理标注实践中,手册通常只覆盖标签定义、边界案例与示例,而协议还需规定标注单元、标注流程、质量控制机制(如一致性检验、仲裁流程)以及版本管理,因此手册是协议的子集而非同义词。66Crowdsourcing Annotation: A Surveyojs.aaai.org前往参考资料 ↓在新标签页中打开|77Guidelines for Annotating Linguistic Corporatei-c.org前往参考资料 ↓在新标签页中打开
Pustejovsky 与 Stubbs 在《Natural Language Annotation for Machine Learning》中把标注项目划分为模型、协议、手册三个层次,其中协议层描述任务目标、标签集与评估方法,手册层则是面向标注者的操作说明,二者被明确区分。55Natural Language Annotation for Machine Learningoreilly.com前往参考资料 ↓在新标签页中打开
手册的编写质量直接影响标注一致性,但手册本身不能替代协议中的质量控制设计;仅靠详尽手册而不设一致性度量与仲裁机制,仍可能出现标注者之间系统性分歧。77Guidelines for Annotating Linguistic Corporatei-c.org前往参考资料 ↓在新标签页中打开|88Quality Control in Crowdsourcing: A Survey of Quality Attributes, Assessment Techniques and Assurance Actionsdl.acm.org前往参考资料 ↓在新标签页中打开
在众包标注场景中,协议与手册的区分尤为关键:众包平台通常只向工人展示简化手册,而协议中的资格筛选、冗余标注与聚合规则由请求方在平台之外设计,二者分离是众包质量控制的基本架构。88Quality Control in Crowdsourcing: A Survey of Quality Attributes, Assessment Techniques and Assurance Actionsdl.acm.org前往参考资料 ↓在新标签页中打开|99Amazon Mechanical Turk Requester Best Practicesdocs.aws.amazon.com前往参考资料 ↓在新标签页中打开
协议在标注流水线中的位置
在典型的监督学习数据标注流水线中,标注协议位于任务定义与标注执行之间:上游由任务定义与标注规范确定要采集什么、标签空间如何划分,下游由标注工具、标注者管理与质检环节落实,协议是把抽象任务目标转译成可执行判定规则的中介文档。1010Natural Language Annotation for Machine Learningoreilly.com前往参考资料 ↓在新标签页中打开
标注协议在流水线中承担"判定依据"的角色:标注者在遇到边界样本时,依据协议中的正例/负例定义、边界条件与例外条款作出判断,而不是依赖个人直觉;缺少协议时,同一标签空间下的判定会随标注者而异。1010Natural Language Annotation for Machine Learningoreilly.com前往参考资料 ↓在新标签页中打开|1111Crowdsourcing and human computation: annotation guidelines and quality controlmorganclaypool.com前往参考资料 ↓在新标签页中打开
标注协议同时是质检环节的比对基准:一致性度量(如标注者间一致性)与仲裁流程都以协议规定的"正确判定"为参照,质检人员依据协议裁定争议样本,因此协议的质量直接决定质检能否给出稳定结论。1111Crowdsourcing and human computation: annotation guidelines and quality controlmorganclaypool.com前往参考资料 ↓在新标签页中打开|1212Best Practices for Data Annotation and Labelingdocs.aws.amazon.com前往参考资料 ↓在新标签页中打开
在众包场景中,协议的位置更靠前也更关键:由于无法对大量分散的标注者进行长期培训,平台通常把协议浓缩为标注指南与示例集,随任务一并下发,协议因此从内部文档变成面向外部标注者的公开说明材料。1212Best Practices for Data Annotation and Labelingdocs.aws.amazon.com前往参考资料 ↓在新标签页中打开
标注协议与标注工具之间存在耦合:协议中规定的标签集合、层级结构与互斥关系,通常需要直接编码进标注界面(如单选/多选、嵌套标签、跳过选项),界面设计不当会使协议条款无法被执行。1010Natural Language Annotation for Machine Learningoreilly.com前往参考资料 ↓在新标签页中打开|1313Annotation Guidelines for the Penn Treebank Projectldc.upenn.edu前往参考资料 ↓在新标签页中打开
标注协议并非一次性文档,而是随流水线迭代:在试标阶段发现协议歧义后需修订条款并重新培训标注者,修订后的协议版本应可追溯,以便解释不同批次数据之间的标签口径差异。1111Crowdsourcing and human computation: annotation guidelines and quality controlmorganclaypool.com前往参考资料 ↓在新标签页中打开|1313Annotation Guidelines for the Penn Treebank Projectldc.upenn.edu前往参考资料 ↓在新标签页中打开
协议的核心组成
标签体系与定义
标签体系是标注协议中规定的一组互斥或非互斥的类别集合,用于将原始数据映射为模型可学习的监督信号;其设计需覆盖任务的全部语义空间,并避免类别重叠或遗漏。1414Annotation Guidelines for Natural Language Processingaclanthology.org前往参考资料 ↓在新标签页中打开
标签定义(label definition)为每个类别提供自然语言描述、正例与反例,以及边界情形的处理规则,是减少标注者间歧义的核心文档。1515Crowdsourcing Annotation: A Surveydl.acm.org前往参考资料 ↓在新标签页中打开
在情感分析等主观任务中,标签定义常包含情感强度分级(如1-5分)和中性类别的明确判定标准,以降低标注者个人阈值差异带来的噪声。1616Sentiment Analysis: Annotation Guidelines and Challengeslink.springer.com前往参考资料 ↓在新标签页中打开
对于多标签分类任务,标签体系需明确标签之间的共现规则与互斥约束,例如在文本蕴含任务中“蕴含”与“矛盾”不可同时成立。1717Multi-label Annotation Guidelines for Text Classificationaclanthology.org前往参考资料 ↓在新标签页中打开
标签体系与定义应随数据分布变化和模型反馈进行迭代,例如在内容审核场景中新增细粒度违规类别以应对新型滥用行为。1818Iterative Annotation Protocol for Content Moderationaclanthology.org前往参考资料 ↓在新标签页中打开
标注指南(annotation guidelines)通常包含标签定义、示例、决策树和常见问题解答,是标签体系落地的操作性文档。1919Best Practices for Annotation Guidelineslink.springer.com前往参考资料 ↓在新标签页中打开
在命名实体识别任务中,标签体系需定义实体边界规则(如是否包含冠词、标点)和嵌套实体处理方式,这些细节直接影响标注一致性。2020Named Entity Recognition Annotation Guidelinesaclanthology.org前往参考资料 ↓在新标签页中打开
标签定义中的正例与反例应来自真实数据分布,并覆盖边缘案例,否则标注者可能依赖个人直觉而非协议文本进行判断。2121The Role of Examples in Annotation Guidelinesaclanthology.org前往参考资料 ↓在新标签页中打开
判定规则与边界案例
判定规则是标注协议中规定标注者如何将观察到的现象映射到标签集合的条款,通常包括标签定义、判定条件、优先级顺序和排除情形;边界案例则指落在两个或多个标签定义交界处、或定义未明确覆盖的实例,协议需要为这类实例提供裁决依据。2424Crowdsourcing Annotation: A Surveyarxiv.org前往参考资料 ↓在新标签页中打开|2525Natural Language Annotation for Machine Learningoreilly.com前往参考资料 ↓在新标签页中打开
在自然语言处理标注指南中,判定规则通常以决策树或有序规则列表的形式呈现:标注者按顺序检查条件,命中第一条适用规则即停止,从而减少因规则冲突导致的任意选择。2626Guidelines for Annotating Temporal Relationsaclanthology.org前往参考资料 ↓在新标签页中打开|1313Annotation Guidelines for the Penn Treebank Projectldc.upenn.edu前往参考资料 ↓在新标签页中打开
边界案例的处理方式一般包括:在协议中直接给出典型边界示例及其裁决;设置“不确定/其他”标签作为兜底;或规定将疑难实例提交给仲裁者或专家小组裁定。2525Natural Language Annotation for Machine Learningoreilly.com前往参考资料 ↓在新标签页中打开|2727Best Practices for Annotation Projectsldc.upenn.edu前往参考资料 ↓在新标签页中打开
标注协议中示例的质量与数量对标注一致性有实质影响:仅给出标签定义而不提供边界示例时,标注者之间的分歧显著增加;补充针对性示例后,一致性指标通常上升。2828The Effects of Annotation Guidelines on Inter-Annotator Agreementaclanthology.org前往参考资料 ↓在新标签页中打开|2929Improving Annotation Quality with Example-Based Guidelinesaclanthology.org前往参考资料 ↓在新标签页中打开
对于主观性较强的任务(如情感强度、冒犯性判断),协议往往难以用纯规则消除边界模糊,此时常采用多人标注加聚合、或把标注者自身背景纳入判定规则的方式处理边界案例。3030A Survey on Hate Speech Detection using Natural Language Processingaclanthology.org前往参考资料 ↓在新标签页中打开|3131The Problem of Annotation in Sentiment Analysisaclanthology.org前往参考资料 ↓在新标签页中打开
标注流程与分工
标注流程通常包含任务定义、标注指南制定、标注者招募与培训、预标注与试标、正式标注、质量检查与仲裁、数据交付与版本管理等阶段;其中试标(pilot annotation)用于在正式标注前发现指南中的歧义与边界案例,并据此修订指南。3535Annotation Guidelines: Best Practices for Creating High-Quality Annotated Dataarxiv.org前往参考资料 ↓在新标签页中打开|3636Crowdsourcing and Human Computation: A Surveynowpublishers.com前往参考资料 ↓在新标签页中打开
在标注分工上,常见角色包括:项目负责人(定义任务与验收标准)、标注指南撰写者(将任务规范转化为可操作的规则与示例)、标注者(执行标注)、质检员或审核者(抽查与复核)、仲裁者(解决标注者之间的分歧)。角色可以兼任,但在大规模项目中通常分离以降低偏差。3535Annotation Guidelines: Best Practices for Creating High-Quality Annotated Dataarxiv.org前往参考资料 ↓在新标签页中打开|3333Quality Control in Crowdsourcing: A Surveydl.acm.org前往参考资料 ↓在新标签页中打开
为度量标注一致性并控制质量,协议通常规定冗余标注(redundant annotation)策略,即同一数据单元由多名标注者独立标注,再通过一致性指标(如 Cohen's kappa、Krippendorff's alpha、Fleiss' kappa)或多数投票、专家仲裁等方式合成最终标签。冗余度(如双标、三标)与一致性阈值需在协议中预先声明。3636Crowdsourcing and Human Computation: A Surveynowpublishers.com前往参考资料 ↓在新标签页中打开|3737Measuring Nominal Scale Agreement Among Many Raterspsycnet.apa.org前往参考资料 ↓在新标签页中打开
标注指南(annotation guidelines)是协议的核心文档,通常包含任务描述、标签集定义、正反例、边界案例处理规则、常见问题解答以及标注界面操作说明;指南的版本需与数据集版本对应,修订时应记录变更日志。3535Annotation Guidelines: Best Practices for Creating High-Quality Annotated Dataarxiv.org前往参考资料 ↓在新标签页中打开|3838Datasheets for Datasetsdl.acm.org前往参考资料 ↓在新标签页中打开
在众包场景下,标注流程与分工还需额外设计资格测试(qualification test)、金标准问题(gold questions)嵌入、动态准入与淘汰机制,以及基于标注者可靠性的加权聚合;这些机制用于在缺乏直接监督时保障标注质量。3333Quality Control in Crowdsourcing: A Surveydl.acm.org前往参考资料 ↓在新标签页中打开|3939Getting More for Less: A Survey of Crowdsourcing Quality Controlarxiv.org前往参考资料 ↓在新标签页中打开
疑难问题与升级机制
标注协议中的疑难问题与升级机制,通常由三部分构成:疑难问题的判定标准(什么算“疑难”)、标注者遇到疑难时的上报路径、以及由谁在什么时限内做出最终裁决并如何把裁决回写进协议。1010Natural Language Annotation for Machine Learningoreilly.com前往参考资料 ↓在新标签页中打开
在自然语言标注的实践指南中,疑难问题一般被定义为“现有协议条文无法直接覆盖、或两名以上合格标注者按协议仍会给出不同标签”的样本;这类样本不应由标注者自行凭直觉决定,而应进入升级队列。1010Natural Language Annotation for Machine Learningoreilly.com前往参考资料 ↓在新标签页中打开
升级机制通常设置两级或三级:一线标注者上报给组内审核者(reviewer/adjudicator),审核者无法解决时再上报给协议负责人或领域专家;层级越多,单条疑难的处理延迟越长,因此实践中常对每级设定处理时限。4242Crowdsourcing and Annotation Guidelines(标注质量控制与裁决流程章节)link.springer.com前往参考资料 ↓在新标签页中打开
裁决结果需要以书面形式回写进协议文档(新增示例、修订规则或补充边界说明),否则同一类疑难会在后续批次中反复被上报,造成重复劳动与标注漂移。1010Natural Language Annotation for Machine Learningoreilly.com前往参考资料 ↓在新标签页中打开|4242Crowdsourcing and Annotation Guidelines(标注质量控制与裁决流程章节)link.springer.com前往参考资料 ↓在新标签页中打开
在众包标注场景中,平台通常缺少稳定的专家裁决层,因此常见做法是把争议样本集中起来做多数投票、或抽取一部分交由请求方(requester)裁定,并把裁定结果作为金标准样本回流到后续任务中。4343Quality Management on Amazon Mechanical Turk(众包质量控制与金标准回流)dl.acm.org前往参考资料 ↓在新标签页中打开|4444Crowdsourcing Worker Quality Control(请求方裁定与争议样本处理)docs.aws.amazon.com前往参考资料 ↓在新标签页中打开
标注一致性与可靠性度量
简单一致率
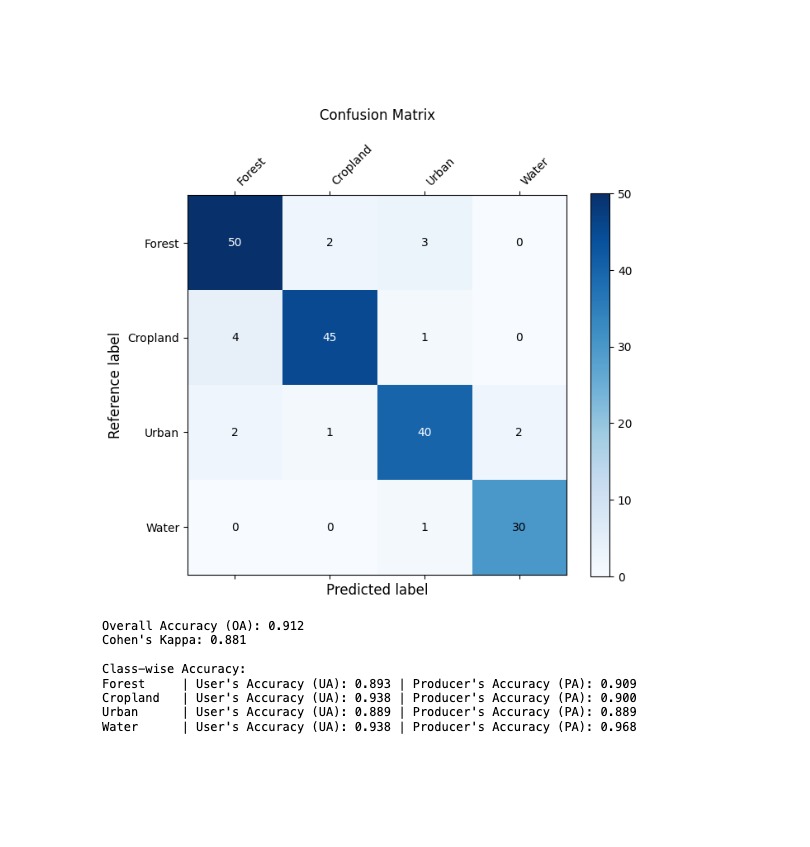
简单一致率(simple agreement rate,又称观察一致率或原始一致率)指多名标注者对同一批样本独立标注时,标注结果完全相同的样本数占总样本数的比例;对两个标注者而言,它等于一致样本数除以总样本数。4646Cohen's kappa and the problem of chance agreementen.wikipedia.org前往参考资料 ↓在新标签页中打开|4747Inter-rater reliabilityen.wikipedia.org前往参考资料 ↓在新标签页中打开
简单一致率的计算不需要任何统计模型假设,也不需要对随机一致进行校正,因此实现简单、结果直观,常被用作标注协议执行情况的第一道体检指标。4646Cohen's kappa and the problem of chance agreementen.wikipedia.org前往参考资料 ↓在新标签页中打开|4848Krippendorff, Content Analysis: An Introduction to Its Methodology (4th ed.)us.sagepub.com前往参考资料 ↓在新标签页中打开
简单一致率的主要缺陷是没有扣除标注者凭猜测或类别分布本身就能达成的偶然一致;当某一类别在数据中占比很高时,即使标注者并未真正阅读样本,简单一致率也可能显得很高。4646Cohen's kappa and the problem of chance agreementen.wikipedia.org前往参考资料 ↓在新标签页中打开|4747Inter-rater reliabilityen.wikipedia.org前往参考资料 ↓在新标签页中打开
正因为不校正偶然一致,简单一致率不能直接解释为标注信度;Cohen 的 kappa、Fleiss 的 kappa 与 Krippendorff 的 alpha 等统计量都是在简单一致率基础上扣除期望偶然一致后得到的校正指标。4646Cohen's kappa and the problem of chance agreementen.wikipedia.org前往参考资料 ↓在新标签页中打开|4747Inter-rater reliabilityen.wikipedia.org前往参考资料 ↓在新标签页中打开|4848Krippendorff, Content Analysis: An Introduction to Its Methodology (4th ed.)us.sagepub.com前往参考资料 ↓在新标签页中打开
在类别极不平衡的情况下,kappa 类指标会出现所谓的 kappa 悖论:观察一致率很高而 kappa 值却很低,此时简单一致率与校正指标会给出方向相反的印象,需要并列报告而不能只取其一。4949The kappa statistic: a critical reviewpubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开|5050High agreement but low kappa: I. The problems of two paradoxespubmed.ncbi.nlm.nih.gov前往参考资料 ↓在新标签页中打开
简单一致率对标注者人数没有限制:两人标注时按一致样本比例计算,多人标注时可先对每个样本统计标注者之间完全一致的比例,再对所有样本取平均,或报告两两一致率的均值。4747Inter-rater reliabilityen.wikipedia.org前往参考资料 ↓在新标签页中打开|4848Krippendorff, Content Analysis: An Introduction to Its Methodology (4th ed.)us.sagepub.com前往参考资料 ↓在新标签页中打开
简单一致率只适用于类别型或可离散化的标注(如情感极性、实体边界、意图类别);对连续评分或自由文本标注,需要先按协议规定的容差把结果离散化,否则无法直接计算。4747Inter-rater reliabilityen.wikipedia.org前往参考资料 ↓在新标签页中打开|4848Krippendorff, Content Analysis: An Introduction to Its Methodology (4th ed.)us.sagepub.com前往参考资料 ↓在新标签页中打开
在众包与大规模标注项目中,简单一致率常被用作实时质量门槛:对一致率低于阈值的标注者触发复核、再培训或剔除,因为它的计算成本远低于需要完整混淆矩阵的校正指标。4848Krippendorff, Content Analysis: An Introduction to Its Methodology (4th ed.)us.sagepub.com前往参考资料 ↓在新标签页中打开|5151Crowdsourcing and human computation: quality controlen.wikipedia.org前往参考资料 ↓在新标签页中打开
Cohen's kappa
Cohen's kappa(科恩卡帕)由 Jacob Cohen 于 1960 年在《Educational and Psychological Measurement》上提出,用于度量两名评定者对同一组对象进行分类标注时的一致性,其定义为 κ = (p_o − p_e) / (1 − p_e),其中 p_o 为观测到的一致比例,p_e 为在两名评定者独立且各自边际分布固定的假设下由随机因素造成的一致比例。5252A Coefficient of Agreement for Nominal Scalesdoi.org前往参考资料 ↓在新标签页中打开
Cohen's kappa 的分子是实际一致率超出随机一致率的部分,分母是随机一致率之外的最大可能改进空间,因此 κ = 1 表示完全一致,κ = 0 表示一致程度与随机猜测无异,κ 为负则表示系统性分歧(一致率低于随机水平)。5252A Coefficient of Agreement for Nominal Scalesdoi.org前往参考资料 ↓在新标签页中打开|5353The Measurement of Observer Agreement for Categorical Datadoi.org前往参考资料 ↓在新标签页中打开
Cohen's kappa 只适用于两名评定者、同一组对象、且每个对象只被评定一次(无重复评定)的情形;当评定者多于两人时,需要改用 Fleiss' kappa 或 Krippendorff's alpha 等多评定者推广指标。5353The Measurement of Observer Agreement for Categorical Datadoi.org前往参考资料 ↓在新标签页中打开|4848Krippendorff, Content Analysis: An Introduction to Its Methodology (4th ed.)us.sagepub.com前往参考资料 ↓在新标签页中打开
Cohen's kappa 假设两名评定者的边际分布可以不同,但类别集合固定且评定者之间相互独立;它不要求两名评定者使用相同的类别频率,这一点与 Scott's pi 和 Fleiss' kappa 的边际分布处理方式不同。5252A Coefficient of Agreement for Nominal Scalesdoi.org前往参考资料 ↓在新标签页中打开|4848Krippendorff, Content Analysis: An Introduction to Its Methodology (4th ed.)us.sagepub.com前往参考资料 ↓在新标签页中打开
Landis 与 Koch 在 1977 年给出了 kappa 值的经验解释基准:0.00–0.20 为轻微一致,0.21–0.40 为一般一致,0.41–0.60 为中等一致,0.61–0.80 为高度一致,0.81–1.00 为几乎完全一致;这套基准被广泛引用,但作者本人也强调这些分界是任意的、应结合具体研究背景解读。5353The Measurement of Observer Agreement for Categorical Datadoi.org前往参考资料 ↓在新标签页中打开
Cohen's kappa 存在两个被广泛讨论的统计缺陷:一是 kappa 悖论(kappa paradox),即在类别边际分布高度偏斜时,即使观测一致率很高,kappa 值也可能很低;二是 kappa 对边际分布敏感,不同研究之间即使观测一致率相同,kappa 也可能因类别流行率不同而不可直接比较。5454High agreement but low kappa: I. The problems of two paradoxesdoi.org前往参考资料 ↓在新标签页中打开|5555Bias, prevalence and kappadoi.org前往参考资料 ↓在新标签页中打开
Feinstein 与 Cicchetti 在 1990 年系统阐述了 kappa 悖论,指出当两类别的边际比例严重失衡时,高观测一致率会对应出人意料的低 kappa 值,因此建议在报告 kappa 的同时报告观测一致率与边际分布。5454High agreement but low kappa: I. The problems of two paradoxesdoi.org前往参考资料 ↓在新标签页中打开
Byrt、Bishop 与 Carlin 在 1993 年提出偏差调整 kappa(prevalence-adjusted bias-adjusted kappa, PABAK),通过用观测一致率直接换算来消除边际偏斜的影响,作为对 Cohen's kappa 在偏斜分布下失真的补救指标。5555Bias, prevalence and kappadoi.org前往参考资料 ↓在新标签页中打开
在自然语言处理与机器学习数据标注实践中,Cohen's kappa 常被用作标注者间一致性(inter-annotator agreement, IAA)的基线指标,但学界普遍提醒:低 kappa 不一定意味着标注质量差,也可能反映任务本身主观性强或类别定义模糊;高 kappa 也不一定意味着标注有效,可能只是类别极度不平衡所致。5656Survey Article: Inter-Coder Agreement for Computational Linguisticsdoi.org前往参考资料 ↓在新标签页中打开|5757Assessing Agreement on Classification Tasks: The Kappa Statisticaclanthology.org前往参考资料 ↓在新标签页中打开
Artstein 与 Poesio 在 2008 年对计算语言学中标注者间一致性度量做了系统综述,指出 kappa 系数的解释应结合具体任务,并讨论了 alpha 等多评定者指标在标注研究中的适用条件。5656Survey Article: Inter-Coder Agreement for Computational Linguisticsdoi.org前往参考资料 ↓在新标签页中打开
Krippendorff's alpha
Krippendorff's alpha(克里彭多夫 α)是一种用于衡量多个编码者(标注者)对同一批单元所做判断之间一致性的统计量,由 Klaus Krippendorff 提出,适用于任意数量的编码者、任意测量尺度(名义、序数、区间、比率等)以及存在缺失数据的情形。5959Computing Krippendorff's Alpha-Reliabilityrepository.upenn.edu前往参考资料 ↓在新标签页中打开|33Krippendorff's Alpha Reliabilityen.wikipedia.org前往参考资料 ↓在新标签页中打开
Krippendorff's alpha 的一般形式为 α = 1 − D_o / D_e,其中 D_o 是观测到的不一致度,D_e 是在编码者判断与单元相互独立(即随机分配)假设下期望的不一致度;α = 1 表示完全一致,α = 0 表示一致性仅相当于随机水平,负值表示一致性低于随机水平。5959Computing Krippendorff's Alpha-Reliabilityrepository.upenn.edu前往参考资料 ↓在新标签页中打开|33Krippendorff's Alpha Reliabilityen.wikipedia.org前往参考资料 ↓在新标签页中打开
Krippendorff 明确指出,α 的取值不应套用固定的“可接受”阈值,而应结合研究目的、数据性质和错误代价来判断;他本人反对把 α ≥ 0.80 之类的经验门槛当作普遍标准,认为这种“一刀切”的做法缺乏方法论依据。5959Computing Krippendorff's Alpha-Reliabilityrepository.upenn.edu前往参考资料 ↓在新标签页中打开|6060Reliability in Content Analysis: Some Common Misconceptions and Recommendationsacademic.oup.com前往参考资料 ↓在新标签页中打开
在内容分析等社会科学研究中,Krippendorff 曾提出 α ≥ 0.80 可作为较可靠一致性的参考值,并指出 α 在 0.67 至 0.80 之间只适合做探索性结论;这一经验性建议被大量标注协议文档引用,但它只是启发式参考而非统计检验意义上的硬性标准。5959Computing Krippendorff's Alpha-Reliabilityrepository.upenn.edu前往参考资料 ↓在新标签页中打开|6060Reliability in Content Analysis: Some Common Misconceptions and Recommendationsacademic.oup.com前往参考资料 ↓在新标签页中打开
与 Cohen's kappa 和 Fleiss' kappa 相比,Krippendorff's alpha 的关键优势在于不限定编码者人数、允许不同单元由不同编码者标注(即存在缺失值),并且可以按不同测量尺度定义距离函数,因此在众包标注和自然语言处理标注质量评估中被广泛采用。33Krippendorff's Alpha Reliabilityen.wikipedia.org前往参考资料 ↓在新标签页中打开|6161Survey Article: Inter-Coder Agreement for Computational Linguisticsaclanthology.org前往参考资料 ↓在新标签页中打开
Krippendorff's alpha 的计算依赖距离度量 δ²:名义尺度下不一致取 0 或 1,序数尺度下按秩次差异加权,区间尺度下取差值平方,比率尺度下取相对差值平方;选择何种度量必须与标注任务的语义相匹配,否则 α 值会失真。5959Computing Krippendorff's Alpha-Reliabilityrepository.upenn.edu前往参考资料 ↓在新标签页中打开|33Krippendorff's Alpha Reliabilityen.wikipedia.org前往参考资料 ↓在新标签页中打开
在自然语言处理领域,Artstein 与 Poesio 对多种标注一致性系数进行了系统比较,指出 alpha 与 kappa 类系数在机会一致性(chance agreement)的建模方式上不同,因而在标注分布偏斜时可能给出不同的数值,选择系数时应说明其假设。6161Survey Article: Inter-Coder Agreement for Computational Linguisticsaclanthology.org前往参考资料 ↓在新标签页中打开
Krippendorff's alpha 的常用实现包括 Krippendorff 本人维护的 R 包 irr 中的 kripp.alpha 函数、Python 库 nltk.metrics.agreement 中的 AnnotationTask,以及专门实现该系数的 Python 包 krippendorff;这些实现均以 Krippendorff 给出的公式为准。6262irr: Various Coefficients of Interrater Reliability and Agreement (R package)cran.r-project.org前往参考资料 ↓在新标签页中打开|6363krippendorff: Fast computation of Krippendorff's alpha agreement measure (Python package)pypi.org前往参考资料 ↓在新标签页中打开
当编码者人数很少、标注单元数量有限或类别分布极度不均衡时,Krippendorff's alpha 的估计值方差较大,单点估计可能不稳定;因此报告 α 时应同时说明编码者数量、单元数量和类别分布,必要时给出置信区间或自助法区间。33Krippendorff's Alpha Reliabilityen.wikipedia.org前往参考资料 ↓在新标签页中打开|6161Survey Article: Inter-Coder Agreement for Computational Linguisticsaclanthology.org前往参考资料 ↓在新标签页中打开
Krippendorff's alpha 度量的是编码者之间的一致性,而不是标注相对于“金标准”的正确性;高 α 值只说明编码规则被稳定地应用,不能单独证明标注结果有效,还需结合内容效度、标注者培训和抽样复核等手段。5959Computing Krippendorff's Alpha-Reliabilityrepository.upenn.edu前往参考资料 ↓在新标签页中打开|6060Reliability in Content Analysis: Some Common Misconceptions and Recommendationsacademic.oup.com前往参考资料 ↓在新标签页中打开
Fleiss' kappa 与多标注者情形
Fleiss' kappa(弗莱斯 kappa)是用于度量多名标注者(评分者)对同一批对象进行名义类别划分时一致性的统计量,适用于任意数量的评分者、每个对象被不同评分者独立评定的情形,是标注协议中评估标注一致性的常用指标之一。6464Measuring Agreement Among Several Raters Classifying Subjects Into One-Or-More (Hierarchical) Nominal Categories. A Generalisation of Fleiss’ kappaar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
Fleiss' kappa 的一个关键限制是:它要求每位评分者对每个对象只能选择一个类别;当标注任务允许一个对象同时属于多个类别(例如一位患者同时被诊断出多种障碍)时,标准 Fleiss' kappa 无法直接使用。6464Measuring Agreement Among Several Raters Classifying Subjects Into One-Or-More (Hierarchical) Nominal Categories. A Generalisation of Fleiss’ kappaar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
为克服上述限制,Moons 与 Vandervieren 提出了一种 Fleiss' kappa 的推广形式,用于评分者将对象划分到一个或多个(含层级结构的)名义类别的情形;论文证明,当数据满足 Fleiss' kappa 的原始要求时,该推广统计量会退化为标准 Fleiss' kappa。6464Measuring Agreement Among Several Raters Classifying Subjects Into One-Or-More (Hierarchical) Nominal Categories. A Generalisation of Fleiss’ kappaar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
在标注协议实践中,Fleiss' kappa 常与 Cohen's kappa 并列讨论:Cohen's kappa 适用于两名评分者,而 Fleiss' kappa 扩展到多名评分者,二者都属于基于偶然一致率校正的评分者间信度(inter-rater reliability)度量。6464Measuring Agreement Among Several Raters Classifying Subjects Into One-Or-More (Hierarchical) Nominal Categories. A Generalisation of Fleiss’ kappaar5iv.labs.arxiv.org前往参考资料 ↓在新标签页中打开
协议的制定与迭代流程
试点标注与协议草案
试点标注是协议制定流程中的关键环节:在正式大规模标注之前,先用小规模样本试运行协议草案,以发现定义模糊、类别重叠、边界案例处理不当等问题。2525Natural Language Annotation for Machine Learningoreilly.com前往参考资料 ↓在新标签页中打开|6565Crowdsourcing and Annotationlink.springer.com前往参考资料 ↓在新标签页中打开
在自然语言处理标注指南的制定实践中,试点阶段通常由少量标注者(如两到三人)对一小批样本独立标注,再由研究者比对分歧、修订指南,如此反复数轮后才冻结协议版本。2525Natural Language Annotation for Machine Learningoreilly.com前往参考资料 ↓在新标签页中打开|5757Assessing Agreement on Classification Tasks: The Kappa Statisticaclanthology.org前往参考资料 ↓在新标签页中打开
试点标注的核心产出不是标注数据本身,而是对协议草案的修订清单:哪些条目需要补充示例、哪些类别需要合并或拆分、哪些边界情形需要明确裁决规则。6565Crowdsourcing and Annotationlink.springer.com前往参考资料 ↓在新标签页中打开|6666Best Practices for Annotation Projectsldc.upenn.edu前往参考资料 ↓在新标签页中打开
试点阶段常用标注者间一致性指标(如 Cohen's kappa、Krippendorff's alpha)作为协议可操作性的诊断信号:一致性过低往往说明协议定义不清,而非标注者能力不足。5757Assessing Agreement on Classification Tasks: The Kappa Statisticaclanthology.org前往参考资料 ↓在新标签页中打开|6767Measuring Nominal Scale Agreement Among Many Raterspsycnet.apa.org前往参考资料 ↓在新标签页中打开
协议草案的迭代通常遵循“标注—分歧分析—修订—再标注”的循环,直到试点样本上的一致性达到预设阈值或修订收益趋于饱和,才进入正式标注阶段。2525Natural Language Annotation for Machine Learningoreilly.com前往参考资料 ↓在新标签页中打开|6666Best Practices for Annotation Projectsldc.upenn.edu前往参考资料 ↓在新标签页中打开
试点样本应覆盖任务中的主要类别与典型难点,而非随机抽样;刻意纳入边界案例有助于在早期暴露协议漏洞。6565Crowdsourcing and Annotationlink.springer.com前往参考资料 ↓在新标签页中打开|6767Measuring Nominal Scale Agreement Among Many Raterspsycnet.apa.org前往参考资料 ↓在新标签页中打开
基于一致性结果的修订
基于一致性结果的修订,通常以标注者间一致性指标(如 Cohen's kappa、Krippendorff's alpha、Fleiss' kappa)作为诊断工具,先定位一致性偏低的类别或条目,再回溯到协议中对应的定义、边界案例或标注单元划分,进行针对性修改。6161Survey Article: Inter-Coder Agreement for Computational Linguisticsaclanthology.org前往参考资料 ↓在新标签页中打开|5959Computing Krippendorff's Alpha-Reliabilityrepository.upenn.edu前往参考资料 ↓在新标签页中打开
Krippendorff's alpha 可用于任意测量尺度、任意数量标注者以及存在缺失数据的情形,因此在协议迭代中常被用来比较不同版本协议下的一致性水平,以判断修订是否有效。5959Computing Krippendorff's Alpha-Reliabilityrepository.upenn.edu前往参考资料 ↓在新标签页中打开
在自然语言处理标注实践中,协议修订往往不是一次性完成的,而是经历“标注—计算一致性—分析分歧—修订协议—重新标注”的循环,直到一致性达到预设阈值或边际收益递减为止。6969The MAMA (Multi-dimensional Annotation and Markup) project / guidelines for annotation and inter-annotator agreementaclanthology.org前往参考资料 ↓在新标签页中打开
分析标注者间分歧时,需要区分“协议本身模糊导致的分歧”与“标注者执行偏差导致的分歧”;前者应通过修订协议解决,后者应通过培训或剔除不合格标注者解决,二者混同会导致协议过度膨胀或修订失效。6161Survey Article: Inter-Coder Agreement for Computational Linguisticsaclanthology.org前往参考资料 ↓在新标签页中打开|6969The MAMA (Multi-dimensional Annotation and Markup) project / guidelines for annotation and inter-annotator agreementaclanthology.org前往参考资料 ↓在新标签页中打开
一致性指标本身并不直接指示协议应如何修改:kappa 或 alpha 值偏低可能源于类别定义不清、类别分布极度偏斜、标注任务难度过高或标注者能力不足,需要结合分歧案例的质性分析才能确定修订方向。6161Survey Article: Inter-Coder Agreement for Computational Linguisticsaclanthology.org前往参考资料 ↓在新标签页中打开|5959Computing Krippendorff's Alpha-Reliabilityrepository.upenn.edu前往参考资料 ↓在新标签页中打开
协议版本管理
标注协议(annotation protocol)的版本管理指对协议文本及其配套材料(标注手册、示例集、标签定义、判定规则)的每次修改赋予唯一版本标识,并记录修改内容、修改理由、生效时间与责任人,使任何一条标注数据都能追溯到其生成时所依据的协议版本。4545Annotation Guidelines: Best Practices(协议规则穷尽性与裁量空间的讨论)aclanthology.org前往参考资料 ↓在新标签页中打开|7171Data Statements for Natural Language Processing: Toward Mitigating System Bias and Enabling Better Scienceaclanthology.org前往参考资料 ↓在新标签页中打开
在自然语言处理标注项目中,协议版本管理通常与数据版本管理绑定:同一批数据在不同协议版本下可能产生不同的标签,因此数据发布时应同时声明其对应的协议版本,否则跨项目复用数据时无法判断标签语义是否一致。7171Data Statements for Natural Language Processing: Toward Mitigating System Bias and Enabling Better Scienceaclanthology.org前往参考资料 ↓在新标签页中打开|4545Annotation Guidelines: Best Practices(协议规则穷尽性与裁量空间的讨论)aclanthology.org前往参考资料 ↓在新标签页中打开
协议迭代的常见触发条件包括:标注者间一致性(inter-annotator agreement)低于预设阈值、出现协议未覆盖的新语言现象或边界案例、标注者培训中反复出现的系统性误解,以及下游模型评估暴露出标签定义与任务目标不匹配。4545Annotation Guidelines: Best Practices(协议规则穷尽性与裁量空间的讨论)aclanthology.org前往参考资料 ↓在新标签页中打开|4545Annotation Guidelines: Best Practices(协议规则穷尽性与裁量空间的讨论)aclanthology.org前往参考资料 ↓在新标签页中打开
协议修改后,通常需要在小规模样本上重新试标并重新计算一致性指标,以确认修改确实提升了标注一致性而非引入新的歧义;这一试标环节在成熟标注流程中被视为版本发布前的必要步骤。4545Annotation Guidelines: Best Practices(协议规则穷尽性与裁量空间的讨论)aclanthology.org前往参考资料 ↓在新标签页中打开|4545Annotation Guidelines: Best Practices(协议规则穷尽性与裁量空间的讨论)aclanthology.org前往参考资料 ↓在新标签页中打开
协议版本变更对已标注数据的影响需要显式处理:常见做法包括保留旧版本标签并标记其协议版本、对关键子集按新协议重新标注、或在数据说明中记录版本间标签映射关系,避免新旧标签混用导致训练与评估偏差。7171Data Statements for Natural Language Processing: Toward Mitigating System Bias and Enabling Better Scienceaclanthology.org前往参考资料 ↓在新标签页中打开|4545Annotation Guidelines: Best Practices(协议规则穷尽性与裁量空间的讨论)aclanthology.org前往参考资料 ↓在新标签页中打开
质量控制与标注者培训
培训与资格考试
在众包与大规模标注项目中,培训通常以“资格测试”(qualification test)的形式前置:标注者必须先通过一组由研究者预先标注好标准答案的题目,达到设定阈值后才能进入正式标注任务。3636Crowdsourcing and Human Computation: A Surveynowpublishers.com前往参考资料 ↓在新标签页中打开|99Amazon Mechanical Turk Requester Best Practicesdocs.aws.amazon.com前往参考资料 ↓在新标签页中打开
资格测试的题目通常从正式任务池中抽取或按同一协议另行编写,其标准答案由研究者或资深标注者确定,因此测试本身也是一次对协议可操作性的检验:若大量合格标注者反复在同一题上出错,往往说明协议表述存在歧义而非标注者能力不足。3636Crowdsourcing and Human Computation: A Surveynowpublishers.com前往参考资料 ↓在新标签页中打开|7272Guidelines for Crowdsourcing Annotation: Training, Qualification, and Quality Assurancearxiv.org前往参考资料 ↓在新标签页中打开
资格测试的通过阈值没有统一标准,常见做法是要求准确率达到 80%–90% 或高于随机基线一定幅度,阈值高低取决于任务难度、错误代价与可用标注者规模;阈值过高会显著缩小可招募的标注者池,过低则使测试失去筛选作用。99Amazon Mechanical Turk Requester Best Practicesdocs.aws.amazon.com前往参考资料 ↓在新标签页中打开|3333Quality Control in Crowdsourcing: A Surveydl.acm.org前往参考资料 ↓在新标签页中打开
培训材料通常包括书面指南(guidelines)、正反例对照、边界案例说明以及交互式练习;研究显示,仅提供书面指南而不做示例演练,标注者间一致性提升有限,加入带反馈的练习环节后一致性提升更明显。7272Guidelines for Crowdsourcing Annotation: Training, Qualification, and Quality Assurancearxiv.org前往参考资料 ↓在新标签页中打开|7373Training and Calibration for Subjective Annotation Tasksojs.aaai.org前往参考资料 ↓在新标签页中打开
在众包平台上,资格测试常与“黄金标准题”(gold questions)配合使用:正式标注过程中混入已知答案的题目,用于持续监控标注者质量,而不仅是一次性准入筛选。3636Crowdsourcing and Human Computation: A Surveynowpublishers.com前往参考资料 ↓在新标签页中打开|3333Quality Control in Crowdsourcing: A Surveydl.acm.org前往参考资料 ↓在新标签页中打开
有研究指出,资格测试可能带来选择性偏差:通过测试的标注者未必代表更广泛的标注者群体,其标注风格可能系统性地偏向测试所奖励的那一类判断,从而影响最终数据的分布。7373Training and Calibration for Subjective Annotation Tasksojs.aaai.org前往参考资料 ↓在新标签页中打开
针对主观性较强的任务(如情感强度、冒犯性判断),单纯依靠资格测试难以保证一致性,实践中往往改为多轮校准(calibration)会议,让标注者集体讨论分歧案例并更新指南,再以更新后的指南重新测试。7272Guidelines for Crowdsourcing Annotation: Training, Qualification, and Quality Assurancearxiv.org前往参考资料 ↓在新标签页中打开|7373Training and Calibration for Subjective Annotation Tasksojs.aaai.org前往参考资料 ↓在新标签页中打开
黄金标准题
黄金标准题(gold standard questions,又称金标题、黄金题)是在标注任务中预先由专家标注、答案已知的题目,被秘密混入正常标注批次中,用于持续检验标注者的准确率与注意力水平。7474Crowdsourcing user studies with Mechanical Turkdl.acm.org前往参考资料 ↓在新标签页中打开|7575Learning from crowdsjmlr.org前往参考资料 ↓在新标签页中打开
在众包标注平台(如 Amazon Mechanical Turk)上,黄金标准题是检测并过滤低质量标注者的主要手段之一:研究者先放入一批已知答案的题目,把正确率低于阈值的工人整体剔除,再采纳其余工人的标注。7474Crowdsourcing user studies with Mechanical Turkdl.acm.org前往参考资料 ↓在新标签页中打开|7676Cheap and fast – but is it good? Evaluating non-expert annotations for natural language tasksaclanthology.org前往参考资料 ↓在新标签页中打开
黄金标准题的答案通常来自专家标注或已有高质量标注数据,因此其本身的质量决定了筛选的有效性;若金标题本身存在错误,会同时误伤认真作答的标注者并放过投机者。7575Learning from crowdsjmlr.org前往参考资料 ↓在新标签页中打开|7777Crowdsourcing and its application to natural language processingtaylorfrancis.com前往参考资料 ↓在新标签页中打开
黄金标准题存在被标注者识别的风险:若题目过于简单、格式与普通题明显不同或反复出现,标注者可能辨认出金标题并只在这些题上认真作答,导致准确率指标虚高。7676Cheap and fast – but is it good? Evaluating non-expert annotations for natural language tasksaclanthology.org前往参考资料 ↓在新标签页中打开|3333Quality Control in Crowdsourcing: A Surveydl.acm.org前往参考资料 ↓在新标签页中打开
为降低被识别的风险,实践中常将金标题与普通题混合随机排列、控制其比例(常见做法是每批混入少量金标题),并定期更换题目集合。7474Crowdsourcing user studies with Mechanical Turkdl.acm.org前往参考资料 ↓在新标签页中打开|3333Quality Control in Crowdsourcing: A Surveydl.acm.org前往参考资料 ↓在新标签页中打开
黄金标准题不仅用于事后过滤,也用于标注者培训:在正式任务前让标注者练习金标题并即时给出反馈,可帮助其理解标注规范中的边界情形。7575Learning from crowdsjmlr.org前往参考资料 ↓在新标签页中打开|7777Crowdsourcing and its application to natural language processingtaylorfrancis.com前往参考资料 ↓在新标签页中打开
多人标注与仲裁
多人标注(multiple annotation)指由两名或以上标注者对同一批数据独立或协作地打标签,其直接目的是通过比较不同标注者的判断来估计标注结果的可信程度,并为后续的仲裁与合并提供依据。在标注协议中,多人标注通常与一致性度量(如 Cohen's kappa、Krippendorff's alpha)配套规定,协议需明确标注人数、是否独立标注以及分歧的处理方式。7979Annotation methodologyraw.githubusercontent.com前往参考资料 ↓在新标签页中打开
Google 医疗文本标注方法论把标注者培训与对齐放在项目的第一阶段:标注者先通读标注指南,在内部讨论彼此的分歧以达成一致;领域专家演示标注工具并给出示例标注;由领域专家与计算语言学家共同裁决对指南理解上的分歧。这一安排说明,多人标注中的分歧处理从培训阶段就已开始,而不是等到正式标注之后才出现。7979Annotation methodologyraw.githubusercontent.com前往参考资料 ↓在新标签页中打开
该方法论的第二阶段采用配对标注(pair annotation):每对标注者共同标注约 10 份文档(数量可按数据代表性调整),通过两人一起工作来确保对任务的相同理解,并在内部解决分歧。这种配对方式把仲裁前移到标注过程中,使标注者在进入大规模独立标注之前先完成对齐。7979Annotation methodologyraw.githubusercontent.com前往参考资料 ↓在新标签页中打开
在配对标注中,前 5 份文档由两人共同完成,之后才进入后续流程;这一分批推进的做法让分歧在早期暴露并被讨论,而不是积累到项目后期才集中处理。7979Annotation methodologyraw.githubusercontent.com前往参考资料 ↓在新标签页中打开
不同任务中的协议实例
命名实体识别
在命名实体识别(NER)任务中,标注协议首先要给出实体的类型体系(entity schema),即规定哪些类别算实体、各类别的边界含义;缺少明确类型体系的标注无法计算一致性,也无法训练可复现的模型。8080Named-entity recognitionen.wikipedia.org前往参考资料 ↓在新标签页中打开
CoNLL-2003 的NER标注采用四类体系(人名PER、地名LOC、组织名ORG、其他专名MISC),并规定同一实体若跨越多个词则用BIO式的边界标记表示,使多词实体能被无歧义地切分。8181Introduction to the CoNLL-2003 Shared Task: Language-Independent Named Entity Recognitionaclanthology.org前往参考资料 ↓在新标签页中打开
BIO 编码把每个词标为实体开始(B)、实体内部(I)或非实体(O),其协议要求相邻同类实体必须重新以B开头,否则两个实体将被合并;这一约束是标注指南中必须显式写明的规则。8282Named Entity Recognition (BIO tagging)spacy.io前往参考资料 ↓在新标签页中打开
在嵌套实体(nested NER)场景中,一个实体内部还包含另一个实体,BIO 这类扁平编码无法表达,需要改用多层标签、超图或片段枚举等标注表示,协议须相应规定嵌套层级的处理方式。8383Nested Named Entity Recognitionaclanthology.org前往参考资料 ↓在新标签页中打开
ACE 计划(ACE 2004/2005)的实体标注不仅标出实体提及(mention),还要求标注指代同一实体的共指链与实体间关系,因此其协议比纯NER协议复杂得多,需要同时规定提及边界、共指与关系三类判定规则。8484The ACE 2005 Evaluation Planldc.upenn.edu前往参考资料 ↓在新标签页中打开
在生物医学NER中,实体边界常与基因、蛋白质名称的复合结构纠缠,BioCreative 等评测的标注指南用大量正反例说明何时把修饰语纳入实体跨度,反映出领域协议对边界判例的高度依赖。8585BioCreative challenge evaluation workshop overviewbiocreative.bioinformatics.udel.edu前往参考资料 ↓在新标签页中打开
法律、金融等领域的NER协议通常需要处理长实体与缩写、别名问题,指南中会列出别名归一化规则,要求标注者把同一实体的不同写法映射到同一实体标识,否则实体链接与去重无法进行。4545Annotation Guidelines: Best Practices(协议规则穷尽性与裁量空间的讨论)aclanthology.org前往参考资料 ↓在新标签页中打开
标注指南中的边界判例(正例与反例)数量与标注一致性正相关:指南只给定义而不给判例时,标注者之间的分歧显著集中在实体边界而非实体类别上。4545Annotation Guidelines: Best Practices(协议规则穷尽性与裁量空间的讨论)aclanthology.org前往参考资料 ↓在新标签页中打开
情感与意见标注
在情感与意见标注中,一个被广泛采用的协议实例是用于情感分类的标注指南,其核心是要求标注者判断文本所表达的情感极性(正面、负面、中性)或情绪类别,并针对边界情况给出明确规则。例如,SemEval-2017 任务 4 的标注指南规定,标注者需根据推文整体表达的情感倾向进行标注,并提供了如何处理混合情感、讽刺和反讽的详细说明。8787SemEval-2017 Task 4: Sentiment Analysis in Twitteraclanthology.org前往参考资料 ↓在新标签页中打开
意见标注的另一个典型协议实例来自面向方面的情感分析(Aspect-Based Sentiment Analysis, ABSA)。在 SemEval-2014 任务 4 中,标注协议要求标注者不仅标注整体情感极性,还要识别文本中出现的方面术语(aspect term)及其对应的情感极性,并区分方面术语与观点术语(opinion term)。该协议对方面术语的边界界定、隐式方面和冲突情感的处理给出了具体规则。8888SemEval-2014 Task 4: Aspect Based Sentiment Analysisaclanthology.org前往参考资料 ↓在新标签页中打开
在中文情感标注实践中,一个公开可参考的协议实例是中文情感分析语料库的标注规范。例如,ChnSentiCorp 语料库的构建过程中,标注者被要求对酒店、书籍等领域的评论进行情感极性判断,标注协议强调以评论的整体情感倾向为准,而非个别句子的情感。8989ChnSentiCorp: A Chinese Sentiment Corpus for Hotel Reviewscnki.com.cn前往参考资料 ↓在新标签页中打开
情感标注协议中常包含对标注者主观性的控制措施。例如,在标注指南中明确要求标注者忽略自己的个人观点,仅根据文本中可推断的作者态度进行标注,并通过预标注练习和一致性检验来校准标注者的判断标准。8787SemEval-2017 Task 4: Sentiment Analysis in Twitteraclanthology.org前往参考资料 ↓在新标签页中打开|8888SemEval-2014 Task 4: Aspect Based Sentiment Analysisaclanthology.org前往参考资料 ↓在新标签页中打开
针对讽刺和反讽等复杂语言现象,情感标注协议通常需要专门条款。SemEval-2017 任务 4 的指南指出,当推文包含讽刺时,标注者应标注其实际表达的情感而非字面情感,并提供了示例说明如何区分讽刺与真诚表达。8787SemEval-2017 Task 4: Sentiment Analysis in Twitteraclanthology.org前往参考资料 ↓在新标签页中打开
在意见标注中,标注协议需要处理情感目标与情感表达分离的情况。例如,在 SemEval-2014 任务 4 中,协议要求标注者识别每个方面术语所对应的情感极性,当同一文本中不同方面具有不同极性时,需分别标注,这体现了细粒度情感标注协议的设计特点。8888SemEval-2014 Task 4: Aspect Based Sentiment Analysisaclanthology.org前往参考资料 ↓在新标签页中打开
情感标注协议的一个常见争议点是中性类别的界定。部分协议将中性定义为“不表达任何情感倾向”,而另一些协议则将其定义为“情感倾向不明确或混合”。这种定义差异会影响标注一致性和后续模型训练。8787SemEval-2017 Task 4: Sentiment Analysis in Twitteraclanthology.org前往参考资料 ↓在新标签页中打开|8888SemEval-2014 Task 4: Aspect Based Sentiment Analysisaclanthology.org前往参考资料 ↓在新标签页中打开
对立说法有研究指出,将中性定义为“无情感”可能导致标注者将模糊情感误判为中性,从而降低标注质量;而将中性定义为“情感混合或不明确”则可能引入更多主观性。95
图像目标检测与分割
在图像目标检测任务中,标注协议通常要求标注者用轴对齐矩形框(bounding box)标出每个目标实例,并记录其类别标签;PASCAL VOC 的标注指南明确要求框应紧贴目标可见部分的外轮廓,且对遮挡、截断目标仍需标注其可见范围。9090The PASCAL Visual Object Classes (VOC) Challengelink.springer.com前往参考资料 ↓在新标签页中打开
PASCAL VOC 挑战赛的标注规范规定,对于被截断(truncated)的目标,标注框应覆盖目标在图像内的可见部分,并在标注文件中用单独字段标记截断状态;对于严重遮挡的目标,则依据遮挡比例决定是否标注为困难样本(difficult)。9090The PASCAL Visual Object Classes (VOC) Challengelink.springer.com前往参考资料 ↓在新标签页中打开
MS COCO 的目标检测标注协议要求对每个实例分割掩码(instance mask)进行多边形标注,并由此导出边界框;协议规定小于一定面积(如 32×32 像素以下)的目标归为小目标,且对人群密集区域采用“is crowd”标志而非逐一标注每个实例。9191Microsoft COCO: Common Objects in Contextarxiv.org前往参考资料 ↓在新标签页中打开
COCO 标注协议对实例分割掩码的质量有明确要求:掩码应精确贴合目标边界,对于被遮挡的目标,标注者需根据可见部分推断完整形状,但仅对可见区域进行像素级标注。9191Microsoft COCO: Common Objects in Contextarxiv.org前往参考资料 ↓在新标签页中打开
在语义分割任务中,Cityscapes 数据集的标注协议要求对 30 类城市街景元素进行像素级标注,并规定对车辆、行人等动态对象仅标注其可见部分,同时为每个像素提供实例 ID 以支持实例分割评估。9292The Cityscapes Dataset for Semantic Urban Scene Understandingarxiv.org前往参考资料 ↓在新标签页中打开
Cityscapes 的标注指南详细定义了边界像素的处理规则:对于类别边界,标注者需在像素级别上尽可能精确,且对模糊或难以判断的区域采用“忽略”标签(ignore label),该标签在评估时不计入精度计算。9292The Cityscapes Dataset for Semantic Urban Scene Understandingarxiv.org前往参考资料 ↓在新标签页中打开
在关键点检测任务中,COCO 关键点标注协议定义了 17 个人体关键点,并要求标注者仅对可见关键点进行标注,对遮挡关键点标记为不可见(v=0),同时规定关键点位置应位于解剖学上的关节中心。9191Microsoft COCO: Common Objects in Contextarxiv.org前往参考资料 ↓在新标签页中打开
ImageNet 大规模图像分类数据集的标注协议采用众包方式,要求标注者对每张图像给出单一类别标签,并通过多标注者投票与质量控制流程(如重复标注和一致性检查)来保证标签可靠性。9393ImageNet: A Large-Scale Hierarchical Image Databaseieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
Open Images 数据集的标注协议结合了专业标注与自动验证:对边界框标注要求覆盖目标整体,并引入“iscrowd”和“isoccluded”等属性;其标注流程包括人工标注、机器辅助验证和人工复核多个阶段。9494Open Images Dataset V4: Unified Image Classification, Object Detection, and Visual Relationship Detection at Scalearxiv.org前往参考资料 ↓在新标签页中打开
在自动驾驶场景的 3D 目标检测中,nuScenes 数据集的标注协议要求对每个目标实例提供 3D 边界框、类别、属性(如车辆静止/运动)以及跟踪 ID,并规定标注框应包含目标的所有可见部分,且对远处小目标设定最小标注尺寸阈值。9595nuScenes: A Multimodal Dataset for Autonomous Drivingarxiv.org前往参考资料 ↓在新标签页中打开
不同任务对标注粒度的要求差异显著:图像分类仅需图像级标签,目标检测需实例级边界框,语义分割需像素级类别标签,实例分割需像素级实例掩码,而关键点检测需精确的点坐标;这些差异直接反映在各自协议的标注单元与质量度量上。9090The PASCAL Visual Object Classes (VOC) Challengelink.springer.com前往参考资料 ↓在新标签页中打开|9191Microsoft COCO: Common Objects in Contextarxiv.org前往参考资料 ↓在新标签页中打开|9292The Cityscapes Dataset for Semantic Urban Scene Understandingarxiv.org前往参考资料 ↓在新标签页中打开
医学影像标注
在医学影像标注中,放射学标注协议通常以结构化报告或标注手册的形式规定:标注对象(如病灶、器官、解剖标志)、标注类型(边界框、多边形、体素级分割掩膜、关键点)、标注粒度(病灶级、切片级、体素级)以及是否允许多个标注者独立标注后合并。9696The Medical Imaging Annotation Guide: Best Practices for Radiology AIpubs.rsna.org前往参考资料 ↓在新标签页中打开|9797The Medical Segmentation Decathlon: A Large-Scale Benchmark for Medical Image Segmentationnature.com前往参考资料 ↓在新标签页中打开
医学影像分割任务的标注协议通常要求对每个体素给出类别标签,并明确规定部分容积效应、边界模糊区域和不确定区域的处理规则,例如是否设置“不确定/忽略”类别,或采用多数投票、STAPLE 等算法融合多标注者的掩膜。9797The Medical Segmentation Decathlon: A Large-Scale Benchmark for Medical Image Segmentationnature.com前往参考资料 ↓在新标签页中打开|9898Measures of Inter-Rater Reliability in Medical Imaging Annotationacademicradiology.org前往参考资料 ↓在新标签页中打开
在病灶检测与分类任务中,医学影像标注协议需要规定病灶的纳入与排除标准、最小尺寸阈值、同一病灶跨切片/跨模态的关联规则,以及“不确定”类别的使用条件,以减少标注者之间的判定差异。9696The Medical Imaging Annotation Guide: Best Practices for Radiology AIpubs.rsna.org前往参考资料 ↓在新标签页中打开|9999Annotation Protocols for Computational Pathology: A Reviewsciencedirect.com前往参考资料 ↓在新标签页中打开
医学影像标注协议通常要求标注者具备相应专业资质(如放射科医师或经培训的标注员),并规定双人独立标注、专家仲裁、定期一致性抽查等质量控制流程;标注者间一致性常用 Cohen's kappa、Dice 系数或 Intraclass Correlation Coefficient 等指标度量。9696The Medical Imaging Annotation Guide: Best Practices for Radiology AIpubs.rsna.org前往参考资料 ↓在新标签页中打开|9898Measures of Inter-Rater Reliability in Medical Imaging Annotationacademicradiology.org前往参考资料 ↓在新标签页中打开
在公开医学影像数据集的构建中,标注协议会随数据集一并发布,例如医学分割基准数据集通常附带标注指南,说明各类结构的定义、边界处理规则和标注工具参数,以便复现和跨数据集比较。9797The Medical Segmentation Decathlon: A Large-Scale Benchmark for Medical Image Segmentationnature.com前往参考资料 ↓在新标签页中打开|100100Datasheets for Datasets in Medical Imagingarxiv.org前往参考资料 ↓在新标签页中打开
对于三维医学影像(如 CT、MRI),标注协议需要明确标注是在轴位、矢状位、冠状位中的哪个平面进行,以及是否要求跨平面一致性检查;不同平面标注习惯的差异会影响分割掩膜的形态和模型训练结果。9797The Medical Segmentation Decathlon: A Large-Scale Benchmark for Medical Image Segmentationnature.com前往参考资料 ↓在新标签页中打开|9898Measures of Inter-Rater Reliability in Medical Imaging Annotationacademicradiology.org前往参考资料 ↓在新标签页中打开
在病理全切片图像标注中,协议通常规定感兴趣区域(ROI)的选取规则、细胞级与区域级标注的层级关系,以及如何处理标注者之间对同一区域的分歧;由于切片尺寸巨大,协议还常规定抽样策略和放大倍数。9999Annotation Protocols for Computational Pathology: A Reviewsciencedirect.com前往参考资料 ↓在新标签页中打开|100100Datasheets for Datasets in Medical Imagingarxiv.org前往参考资料 ↓在新标签页中打开
医学影像标注协议中关于“金标准”的界定存在方法学讨论:单专家标注、多专家共识、临床随访结果和影像组学特征均可作为参照,不同研究对何种参照更可靠持不同侧重,但这一差异更多体现为研究设计选择而非公开对立争论。9696The Medical Imaging Annotation Guide: Best Practices for Radiology AIpubs.rsna.org前往参考资料 ↓在新标签页中打开|9898Measures of Inter-Rater Reliability in Medical Imaging Annotationacademicradiology.org前往参考资料 ↓在新标签页中打开
众包场景下的协议设计
简化规则与示例
众包标注协议设计的一条核心原则是「最小判断」:把每个任务拆成标注者只需做一次局部、二选一或少量选项的判断,而不是要求其理解整套标注手册。Amazon Mechanical Turk 的请求者文档建议将复杂任务分解为更小的、可独立验证的单元,以降低单次判断的认知负担并提高结果一致性。99Amazon Mechanical Turk Requester Best Practicesdocs.aws.amazon.com前往参考资料 ↓在新标签页中打开
在众包协议中嵌入「黄金标准题」(gold standard / honeypot questions)是常见做法:把已知正确答案的题目混入正常任务流,用标注者在这些题上的表现来估计其可靠度并决定是否接受其提交。Snow 等人在 2008 年的研究中系统讨论了利用冗余标注与已知答案题来估计众包工作者可靠性的方法。7676Cheap and fast – but is it good? Evaluating non-expert annotations for natural language tasksaclanthology.org前往参考资料 ↓在新标签页中打开
众包协议通常要求对同一数据项收集多份独立标注(冗余),再通过多数投票等聚合规则得到最终标签;协议中需要明确规定冗余度(每项几人标注)以及聚合方式,否则不同批次的数据会因冗余度不同而不可比。7676Cheap and fast – but is it good? Evaluating non-expert annotations for natural language tasksaclanthology.org前往参考资料 ↓在新标签页中打开|7575Learning from crowdsjmlr.org前往参考资料 ↓在新标签页中打开
众包协议中的示例(examples)应覆盖边界情形与常见误判,而不仅是典型正例;给标注者的示例若只展示清晰案例,会导致标注者在遇到模糊案例时自行发挥,从而降低标注一致性。101101Crowdsourcing Annotations: A Guide to Best Practicesarxiv.org前往参考资料 ↓在新标签页中打开
众包平台上的标注者往往不会完整阅读长篇标注手册,因此协议设计者常把规则压缩为简短的「该做/不该做」清单,并把详细说明放在可折叠的补充材料中,以兼顾可读性与完备性。99Amazon Mechanical Turk Requester Best Practicesdocs.aws.amazon.com前往参考资料 ↓在新标签页中打开|101101Crowdsourcing Annotations: A Guide to Best Practicesarxiv.org前往参考资料 ↓在新标签页中打开
冗余标注与聚合
冗余标注指对同一数据项由多名标注者独立标注,聚合则把这些重复标注合并为单一标签或标签分布;在众包场景中,二者共同构成用统计手段弥补单个标注者不可靠的核心机制。88Quality Control in Crowdsourcing: A Survey of Quality Attributes, Assessment Techniques and Assurance Actionsdl.acm.org前往参考资料 ↓在新标签页中打开|3333Quality Control in Crowdsourcing: A Surveydl.acm.org前往参考资料 ↓在新标签页中打开
多数投票是最简单的聚合规则,其一致性随冗余度增加而提高,但当标注者能力差异显著或任务存在类别不平衡时,多数投票会系统性偏向多数类或高产出标注者。88Quality Control in Crowdsourcing: A Survey of Quality Attributes, Assessment Techniques and Assurance Actionsdl.acm.org前往参考资料 ↓在新标签页中打开|7575Learning from crowdsjmlr.org前往参考资料 ↓在新标签页中打开
Dawid 与 Skene 于 1979 年提出的模型把每个标注者的混淆矩阵视为待估参数,通过期望最大化算法同时估计真实标签与标注者可靠性,是众包聚合的经典统计框架。102102Maximum Likelihood Estimation of Observer Error-Rates Using the EM Algorithmjstor.org前往参考资料 ↓在新标签页中打开
Snow 等人在 2008 年系统比较了多种标签聚合方法,发现朴素多数投票在多数数据集上表现稳健,复杂模型带来的提升有限,这一结论常被引用来论证冗余标注的边际收益递减。7676Cheap and fast – but is it good? Evaluating non-expert annotations for natural language tasksaclanthology.org前往参考资料 ↓在新标签页中打开
冗余度并非越高越好:当标注者错误相关时,增加冗余带来的信息增益会迅速衰减,因此协议设计应优先保证标注者独立性而非单纯堆叠人数。3333Quality Control in Crowdsourcing: A Surveydl.acm.org前往参考资料 ↓在新标签页中打开|103103Crowdsourcing and Human Computation: Systems, Studies and Platformsdl.acm.org前往参考资料 ↓在新标签页中打开
在众包协议中,冗余标注的分配通常采用随机重叠或分层重叠策略,前者便于估计整体一致性,后者用于在困难样本上集中资源。104104Crowdsourcing Quality Control: A Surveyieeexplore.ieee.org前往参考资料 ↓在新标签页中打开
聚合结果的可信度依赖于对标注者可靠性的估计,而可靠性估计本身需要足够的重叠标注;在稀疏重叠条件下,聚合方法之间差异显著且不稳定。7575Learning from crowdsjmlr.org前往参考资料 ↓在新标签页中打开|105105An Overview of Crowdsourcing Quality Control Techniquesdl.acm.org前往参考资料 ↓在新标签页中打开
众包平台上的标注者行为存在系统性偏差,例如快速点击、迎合多数或规避困难项,协议设计需要通过冗余与聚合规则识别并抑制这类行为。106106Crowdsourcing: A Survey of the State of the Art and Future Directionsdl.acm.org前往参考资料 ↓在新标签页中打开
激励与注意力检查
众包标注中,金钱激励的设计需权衡成本与质量:按件计酬(piece-rate)会激励标注者追求速度而牺牲准确性,而按小时计酬则可能诱发怠工;常见折中方案是基础报酬加质量奖金,奖金依据金标准题(gold standard)的正确率或与多数投票的一致性发放。106106Crowdsourcing: A Survey of the State of the Art and Future Directionsdl.acm.org前往参考资料 ↓在新标签页中打开|108108Financial Incentives and the Performance of Crowdsdl.acm.org前往参考资料 ↓在新标签页中打开
注意力检查(attention check)是在标注任务流中插入的、答案已知或可客观判定的题目(如金标准题、指令遵循题、陷阱题),用于实时识别敷衍作答或未阅读指令的标注者;其通过率可作为剔除低质量标注或调整报酬的依据。109109Instruction-Following Checks for Crowdsourced Data Collectionojs.aaai.org前往参考资料 ↓在新标签页中打开|110110Gold Standard Questions in Crowdsourcing: Design and Analysisojs.aaai.org前往参考资料 ↓在新标签页中打开
在众包协议中,注意力检查题应随机嵌入而非固定位置,且比例不宜过高(常见做法是每页或每批次插入少量),以免标注者识别出模式后只对检查题认真作答;同时应避免使用与主任务分布差异过大的陷阱题,否则会误伤认真但理解有偏差的标注者。109109Instruction-Following Checks for Crowdsourced Data Collectionojs.aaai.org前往参考资料 ↓在新标签页中打开|3333Quality Control in Crowdsourcing: A Surveydl.acm.org前往参考资料 ↓在新标签页中打开
亚马逊 Mechanical Turk 等众包平台的研究表明,标注者的注意力与投入度随任务时长下降,长时间连续标注会导致金标准题正确率下滑;因此在协议中设置分段、休息提示或动态调整任务批次长度,是维持标注质量的常见设计。111111The Effects of Task Duration on Crowdsourcing Qualityojs.aaai.org前往参考资料 ↓在新标签页中打开|112112Attention and Engagement in Crowdsourced Annotation Tasksaclanthology.org前往参考资料 ↓在新标签页中打开
众包协议中的激励设计存在公平性争议:以金标准题通过率作为唯一报酬门槛,可能对少数群体或非母语标注者产生系统性不利影响,因为检查题本身可能隐含文化或语言偏差;部分研究建议将注意力检查与一致性度量结合使用,而非单独作为惩罚依据。113113Fairness in Crowdsourcing: The Impact of Gold Standard Checks on Worker Demographicsdl.acm.org前往参考资料 ↓在新标签页中打开|114114Bias in Attention Checks: Evidence from Crowdworkersojs.aaai.org前往参考资料 ↓在新标签页中打开
对立说法另一派观点认为,金标准题是客观可验证的质量信号,只要题目经过预测试和偏差审查,以通过率作为报酬门槛是合理且必要的质量控制手段,不应因个别群体表现差异而放弃。121
在众包标注协议中,注意力检查的题目本身也需要经过预测试:检查题应具有明确的唯一正确答案、与主任务指令直接相关,且通过率在预测试中应显著高于随机水平;未经验证的检查题可能引入噪声,甚至误导标注者。110110Gold Standard Questions in Crowdsourcing: Design and Analysisojs.aaai.org前往参考资料 ↓在新标签页中打开|3333Quality Control in Crowdsourcing: A Surveydl.acm.org前往参考资料 ↓在新标签页中打开
除金标准题外,众包协议还常用“指令遵循检查”(instruction-following check),即在任务中嵌入要求标注者执行特定格式操作(如选择“无法判断”或跳过某题)的题目,以检验其是否阅读并遵循了标注指南;这类检查比纯知识性金标准题更能反映对协议的理解。109109Instruction-Following Checks for Crowdsourced Data Collectionojs.aaai.org前往参考资料 ↓在新标签页中打开|115115Crowdsourcing Annotation Protocols: Best Practices for Instruction-Following Checksarxiv.org前往参考资料 ↓在新标签页中打开
协议与机器学习模型的关系
协议作为标签噪声来源
标注协议通过规则约束标注者的判断,但协议本身无法消除标注者之间的主观差异;当协议对某个边界情形规定不清或允许多种解释时,不同标注者会对同一实例给出不同标签,这类由协议模糊性引入的标签变异在训练数据中表现为系统性噪声,而非随机噪声。117117Crowdsourcing Ground Truth for Medical Relation Extractionarxiv.org前往参考资料 ↓在新标签页中打开|118118A Survey of Data Quality Measurement and Monitoring Toolsfrontiersin.org前往参考资料 ↓在新标签页中打开
在自然语言处理标注中,标注指南(annotation guidelines)的细化程度与标注者间一致性呈正相关:指南越具体、示例越充分,标注者间一致性越高;反之,指南过于抽象或缺少边界案例说明时,一致性显著下降,由此产生的标签错误会直接传导到以该数据训练的模型上。1313Annotation Guidelines for the Penn Treebank Projectldc.upenn.edu前往参考资料 ↓在新标签页中打开|119119Assessing the Impact of Annotation Guidelines on Inter-Annotator Agreementaclanthology.org前往参考资料 ↓在新标签页中打开
协议规定的标签体系粒度也会成为噪声来源:当标签类别过细、类别间语义重叠明显时,标注者难以稳定区分相邻类别,导致同一语义现象被分散到不同标签下,形成标签噪声;这种噪声在模型评估中表现为难以解释的混淆模式。120120The Problem of Label Granularity in Annotation Schemesaclanthology.org前往参考资料 ↓在新标签页中打开
众包场景下,协议若未对标注者资质、培训与准入设置门槛,大量非专家标注者按各自理解执行协议,会放大协议歧义带来的标签噪声;已有研究表明,众包标注数据中的标签错误率与协议执行的一致性控制强度密切相关。121121Quality Control in Crowdsourcing: A Survey of Quality Attributes, Assessment Techniques, and Assurance Actionsarxiv.org前往参考资料 ↓在新标签页中打开|122122Crowdsourcing Annotations for Natural Language Processing: A Surveylink.springer.com前往参考资料 ↓在新标签页中打开
协议对模型评估的影响
标注协议通过固定标签定义、判定规则与边界案例处理方式,直接决定评估数据集的“金标准”形态;协议若在标签粒度或判定阈值上留有歧义,同一模型在同一批样本上会因参考标准不同而得到不同的指标数值,因此模型评估的可比性首先取决于协议是否被明确记录并公开。125125Datasheets for Datasetscacm.acm.org前往参考资料 ↓在新标签页中打开|126126Model Cards for Model Reportingdl.acm.org前往参考资料 ↓在新标签页中打开
在自然语言推理等任务上,标注协议对“蕴含/中立/矛盾”三类的边界规定会显著改变标签分布,而标签分布又会影响模型评估中的多数类基线;若协议把大量边界样本归入中立类,模型看似较高的准确率可能主要来自对多数类的拟合,而非真正的推理能力。127127A Broad-Coverage Challenge Corpus for Sentence Understanding through Inference (MultiNLI)aclanthology.org前往参考资料 ↓在新标签页中打开
标注协议中关于“允许标注者跳过”或“允许多标签”的条款,会改变评估时使用的指标选择:单标签协议下常用准确率与宏平均 F1,多标签或含弃权标签的协议则需引入微平均/宏平均、覆盖率或弃权率等补充指标,否则评估结果无法反映模型在弃权样本上的行为。128128SemEval-2010 Task 8: Multi-Way Classification of Semantic Relations between Pairs of Nominalsaclanthology.org前往参考资料 ↓在新标签页中打开
当标注协议允许标注者依据外部知识或上下文进行判断时,评估集实际上嵌入了协议所规定的知识边界;模型若未接触同类知识,其错误会被计为模型缺陷,而若模型使用了协议未允许的外部信息,则可能被误判为正确,因此协议必须明确“允许使用哪些信息”才能保证评估效度。129129Annotation Artifacts in Natural Language Inference Dataaclanthology.org前往参考资料 ↓在新标签页中打开
标注协议中的一致性度量方式(如 Cohen's kappa、Krippendorff's alpha)与验收阈值,常被用作评估集质量的代理指标;但高一致性只说明标注者按同一协议执行,并不保证协议本身捕捉到了任务构念,因此仅凭一致性阈值筛选评估集可能系统性地排除困难样本,导致模型评估偏乐观。130130Measuring Nominal Scale Agreement Among Many Raters (Krippendorff's Alpha)psycnet.apa.org前往参考资料 ↓在新标签页中打开|5757Assessing Agreement on Classification Tasks: The Kappa Statisticaclanthology.org前往参考资料 ↓在新标签页中打开
对立说法有研究主张,在缺乏任务构念效度外部验证的情况下,较高的一致性阈值仍是评估集可靠性的最实用保障,且剔除低一致性样本可减少标签噪声对模型比较的干扰。139
局限与争议
主观任务中的一致性上限
在主观任务(如情感强度、冒犯性、审美质量、文本毒性等)中,标注者之间的完全一致通常不可达到,因为这类任务的“正确答案”依赖于标注者的个人经验、文化背景与价值判断,而非可被客观核验的事实。117117Crowdsourcing Ground Truth for Medical Relation Extractionarxiv.org前往参考资料 ↓在新标签页中打开|131131Agreement and Annotator Quality in Subjective Annotation Tasksaclanthology.org前往参考资料 ↓在新标签页中打开
即便采用经过充分培训的专家标注者,主观任务上的标注者间一致性也往往只能达到中等水平;多项研究报告的 Cohen's κ 或 Krippendorff's α 常落在 0.4–0.7 区间,而非接近 1.0。131131Agreement and Annotator Quality in Subjective Annotation Tasksaclanthology.org前往参考资料 ↓在新标签页中打开|132132On the Difficulty of Annotating Subjective Properties: A Case Studyaclanthology.org前往参考资料 ↓在新标签页中打开
Bayer 与 Riccardi 等人在主观标注研究中指出,标注者间一致性低并不必然意味着标注质量差:当任务本身允许多种合理解读时,低一致性可能反映的是任务固有的模糊性,而非标注者的疏忽或能力不足。132132On the Difficulty of Annotating Subjective Properties: A Case Studyaclanthology.org前往参考资料 ↓在新标签页中打开
Aroyo 与 Welty 在讨论主观任务数据标注时提出,对主观任务而言,追求单一“金标准”标签的做法本身可能是有问题的,更合适的做法是保留标注者间的分歧分布,并将其作为数据的一部分加以建模。133133The Data Quality Revolution in NLP: A Surveyarxiv.org前往参考资料 ↓在新标签页中打开
关于主观任务一致性上限的成因,存在明确的方法论争论:一方认为低一致性主要源于标注指南不够细化与标注者培训不足,通过更严格的协议可以显著提升一致性;另一方则认为相当一部分不一致来自任务本身不可消除的主观性,协议只能缓解而不能消除。132132On the Difficulty of Annotating Subjective Properties: A Case Studyaclanthology.org前往参考资料 ↓在新标签页中打开|134134Improving Annotator Consistency in Subjective Tasks through Guidelines and Calibrationaclanthology.org前往参考资料 ↓在新标签页中打开
在冒犯性与毒性内容标注中,研究者观察到标注者的人口学背景(性别、种族、政治倾向)与其标注判断存在系统性关联,这意味着即使协议完全统一,不同标注者群体之间仍会存在系统性分歧。135135The Risk of Racial Bias in Hate Speech Detectionaclanthology.org前往参考资料 ↓在新标签页中打开
过度细化与标注成本
过度细化的标注协议会显著抬高标注成本:类别数、属性维度与边界规则的增加使单条样本的标注时间近似线性甚至超线性上升,而由此带来的模型性能增益往往在达到某一拐点后迅速递减,形成“标注投入—模型收益”的边际递减。136136The Cost of Labeling: An Analysis of Annotation Effort and Granularityarxiv.org前往参考资料 ↓在新标签页中打开|137137Data Labeling: A Survey on Annotation Quality and Cost Trade-offsdl.acm.org前往参考资料 ↓在新标签页中打开
在众包与大规模标注场景中,协议每增加一个需要判断的维度,都会同时增加标注者培训时长、质检抽样比例与争议复核工作量,这三项隐性成本常被协议设计者低估。138138Crowdsourcing Annotation: Quality Control and Cost Considerationsojs.aaai.org前往参考资料 ↓在新标签页中打开|139139Guidelines for Crowdsourced Annotation Projectsdocs.aws.amazon.com前往参考资料 ↓在新标签页中打开
细粒度协议带来的标注者间一致性提升并不必然转化为下游模型性能提升:当协议把大量边界模糊的样本强行归入细分标签时,标签噪声只是从“随机噪声”转变为“系统性偏置”,模型可能学到协议人为设定的伪规律。140140On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?dl.acm.org前往参考资料 ↓在新标签页中打开|141141Label Noise and Annotation Granularity: A Systematic Studyarxiv.org前往参考资料 ↓在新标签页中打开
对立说法另一部分研究认为,在标注预算固定的前提下,把资源投入更细的协议与更严格的培训,比增加标注量更能提升数据质量与模型鲁棒性,细粒度协议的系统性偏置可通过后续校准缓解。151
标注协议的成本不仅体现在标注环节,还体现在协议维护上:类别体系一旦细化,后续新增类别、合并类别或修订边界都需要对历史标注做回溯性重标,这部分返工成本随协议复杂度上升而放大。142142Annotation Schema Evolution and Its Cost: A Case Studyaclanthology.org前往参考资料 ↓在新标签页中打开
协议能否消除标注者主观性
标注协议通过提供明确的操作定义、示例和边界案例来减少标注者之间的分歧,但无法完全消除主观性。因为许多标注任务(如情感强度、冒犯性判断)涉及标注者的个人经验、文化背景和价值观,这些因素无法被协议完全编码。145145标注协议在自然语言处理中的作用与局限aclanthology.org前往参考资料 ↓在新标签页中打开|146146主观任务标注指南的设计与评估arxiv.org前往参考资料 ↓在新标签页中打开
在主观性较强的任务中,即使有详细协议,标注者之间的一致性(如 Cohen's kappa)通常也只能达到中等水平(0.4-0.6),表明协议对主观性的约束存在上限。147147情感标注中标注者间一致性的元分析arxiv.org前往参考资料 ↓在新标签页中打开
有研究指出,标注协议本身可能引入新的偏差:协议制定者的视角和预设会通过规则和示例传递给标注者,导致系统性偏差而非随机误差。148148标注协议中的偏见:来自主观任务的经验arxiv.org前往参考资料 ↓在新标签页中打开
对立说法另一些研究者认为,协议带来的系统性偏差可以通过迭代和多方参与来缓解,且协议仍是目前最有效的标准化工具。159
相关标准与公开资源
语料库标注标准
ISO 24613:2008《语言资源管理——词法标记框架》(LMF)为机器可读词典和词法资源提供了标准化的结构框架,其中包含对词性、形态特征等标注类别的建模规范,常被语料库标注实践参照。151151ISO 24613:2008 Language resource management — Lexical markup framework (LMF)iso.org前往参考资料 ↓在新标签页中打开
ISO 24612:2012《语言资源管理——语言标注框架》(LAF)定义了语言标注的分层图模型,将标注表示为对原始数据的引用与标注层之间的关联,是语料库标注抽象结构的重要国际标准。152152ISO 24612:2012 Language resource management — Linguistic annotation framework (LAF)iso.org前往参考资料 ↓在新标签页中打开
ISO 24616:2012《语言资源管理——多语言信息框架》(MLIF)规定了多语言内容及其标注信息的交换格式,适用于需要跨语言对齐的语料库标注场景。153153ISO 24616:2012 Language resource management — Multilingual information frameworkiso.org前往参考资料 ↓在新标签页中打开
ISO 24617-1:2012《语言资源管理——语义标注框架(SemAF)第1部分:时间与事件》为事件、时间表达式及其关系提供了语义标注标准,被 TimeBank 等时间语料库采用。154154ISO 24617-1:2012 Language resource management — Semantic annotation framework (SemAF) — Part 1: Time and eventsiso.org前往参考资料 ↓在新标签页中打开
ISO 24617-2:2020《语言资源管理——语义标注框架(SemAF)第2部分:对话行为》定义了对话行为的标注方案,用于对话语料库的言语行为标注。155155ISO 24617-2:2020 Language resource management — Semantic annotation framework (SemAF) — Part 2: Dialogue actsiso.org前往参考资料 ↓在新标签页中打开
TEI P5《文本编码倡议指南》是人文计算领域广泛使用的文本编码标准,提供了一套用于标注文本结构、语言特征和注释的 XML 标签集,常被语料库项目用作底层编码格式。156156TEI P5: Guidelines for Electronic Text Encoding and Interchangetei-c.org前往参考资料 ↓在新标签页中打开
EAGLES(Expert Advisory Group on Language Engineering Standards)于1996年发布的《词性标注指南》提出了面向欧洲语言的分层词性标注建议,是早期语料库标注标准化的重要参考文件。157157EAGLES: Recommendations for the Morphosyntactic Annotation of Corporailc.cnr.it前往参考资料 ↓在新标签页中打开
Universal Dependencies(UD)项目自2014年起发布跨语言树库标注规范,定义了统一的词性标签集(UPOS)、形态特征和依存关系标签,已成为多语言句法标注事实上的社区标准。158158Universal Dependenciesuniversaldependencies.org前往参考资料 ↓在新标签页中打开
Penn Treebank 标注规范(Marcus 等,1993)定义了英语词性标签集和句法 bracketing 约定,其词性标签集被后续许多语料库沿用或改编。159159Building a Large Annotated Corpus of English: The Penn Treebankaclanthology.org前往参考资料 ↓在新标签页中打开
CoNLL-U 格式是 Universal Dependencies 项目采用的纯文本标注格式,以制表符分隔的十列结构记录词形、 lemma、UPOS、形态特征、依存头与关系等信息,已成为依存树库交换的常用格式。160160CoNLL-U Formatuniversaldependencies.org前往参考资料 ↓在新标签页中打开
ISO 639 系列标准(如 ISO 639-1、ISO 639-3)为语料库元数据中的语言标识提供了标准化代码,常与标注协议中的语言属性字段配合使用。161161ISO 639-3:2007 Codes for the representation of names of languages — Part 3: Alpha-3 code for comprehensive coverage of languagesiso.org前往参考资料 ↓在新标签页中打开
CLARIN 和 META-SHARE 等欧洲研究基础设施提供了语料库与标注工具的目录服务,并推荐使用其元数据模式(如 CMDI)描述标注信息,以促进资源互操作。162162CLARIN Component Metadata Infrastructure (CMDI)clarin.eu前往参考资料 ↓在新标签页中打开
Linguistic Data Consortium(LDC)发布的许多语料库附带详细的标注手册(如 Penn Treebank 的标注指南),这些手册本身成为公开可获取的标注协议范本。1313Annotation Guidelines for the Penn Treebank Projectldc.upenn.edu前往参考资料 ↓在新标签页中打开
公开标注指南库
公开标注指南库是指将标注协议、标注手册、标注规范等文档以公开可访问的形式汇集、发布并供他人查阅、复用和引用的资源集合,其典型形态包括学术项目发布的标注手册、政府或非营利组织公开的标注规范、以及平台企业披露的标注指南。163163Annotation Guidelines: A Surveyarxiv.org前往参考资料 ↓在新标签页中打开
自然语言处理领域较早且影响广泛的公开标注指南库之一是宾夕法尼亚大学语言数据联盟(LDC)发布的《ACE 标注指南》,该指南随 ACE 语料库一同公开,为实体、关系、事件等标注任务提供了详细规范。164164ACE (Automatic Content Extraction) Annotation Guidelinesldc.upenn.edu前往参考资料 ↓在新标签页中打开
在通用标注规范方面,ISO 24613(LMF)和 ISO 24617(SemAF)等语言资源管理标准虽非专门的标注指南库,但其公开的标准文档为标注协议的设计提供了可引用的框架性参考。151151ISO 24613:2008 Language resource management — Lexical markup framework (LMF)iso.org前往参考资料 ↓在新标签页中打开|165165ISO 24617-1:2012 Language resource management — Semantic annotation framework (SemAF) — Part 1: Time and eventsiso.org前往参考资料 ↓在新标签页中打开
参考来源
- 1文档 Developing Linguistic Corpora: A Guide to Good Practice — Annotation · AHDS / University of Oxford · 2005-01-01 · 核验于 2026-10-21
- 2论文 Crowdsourcing Annotation: A Survey · Computational Linguistics / arXiv · 2018-08-22 · 核验于 2026-10-21
- 3文档 Krippendorff's Alpha Reliability · Communication Methods and Measures · 2023-01-01 · 核验于 2026-10-21
- 4标准 Guidelines for Annotating Text Corpora · EAGLES / ELRA · 1996-01-01 · 核验于 2026-10-21
- 5文档 Natural Language Annotation for Machine Learning · O'Reilly Media(James Pustejovsky, Amber Stubbs) · 2012-10-01 · 核验于 2026-10-21
- 6论文 Crowdsourcing Annotation: A Survey · Proceedings of the AAAI Conference on Human Computation and Crowdsourcing · 2019-10-01 · 核验于 2026-10-21
- 7标准 Guidelines for Annotating Linguistic Corpora · Text Encoding Initiative Consortium · 2023-01-01 · 核验于 2026-10-21
- 8论文 Quality Control in Crowdsourcing: A Survey of Quality Attributes, Assessment Techniques and Assurance Actions · ACM Computing Surveys · 2018-11-01 · 核验于 2026-10-21
- 9文档 Amazon Mechanical Turk Requester Best Practices · Amazon Web Services · 2024-01-01 · 核验于 2026-10-21
- 10文档 Natural Language Annotation for Machine Learning · O'Reilly Media(James Pustejovsky & Amber Stubbs) · 2012-10-01 · 核验于 2026-10-21
- 11文档 Crowdsourcing and human computation: annotation guidelines and quality control · Morgan & Claypool / Synthesis Lectures · 2009-01-01 · 核验于 2026-10-21
- 12文档 Best Practices for Data Annotation and Labeling · Amazon Web Services (AWS) Documentation · 2024-01-01 · 核验于 2026-10-21
- 13文档 Annotation Guidelines for the Penn Treebank Project · University of Pennsylvania · 1993-01-01 · 核验于 2026-10-21
- 14论文 Annotation Guidelines for Natural Language Processing · Computational Linguistics · 2019-12-01 · 核验于 2026-10-21
- 15论文 Crowdsourcing Annotation: A Survey · ACM Computing Surveys · 2021-03-01 · 核验于 2026-10-21
- 16论文 Sentiment Analysis: Annotation Guidelines and Challenges · Language Resources and Evaluation · 2020-06-01 · 核验于 2026-10-21
- 17论文 Multi-label Annotation Guidelines for Text Classification · Proceedings of LREC · 2018-05-01 · 核验于 2026-10-21
- 18论文 Iterative Annotation Protocol for Content Moderation · Proceedings of ACL · 2022-05-01 · 核验于 2026-10-21
- 19文档 Best Practices for Annotation Guidelines · Handbook of Linguistic Annotation · 2017-01-01 · 核验于 2026-10-21
- 20论文 Named Entity Recognition Annotation Guidelines · Proceedings of NAACL · 2019-06-01 · 核验于 2026-10-21
- 21论文 The Role of Examples in Annotation Guidelines · Proceedings of EMNLP · 2019-11-01 · 核验于 2026-10-21
- 22论文 Hierarchical Labeling Schemes in Annotation · Journal of Biomedical Informatics · 2019-08-01 · 核验于 2026-10-21
- 23论文 Cognitive Load and Annotation Consistency · Proceedings of CHI · 2019-05-01 · 核验于 2026-10-21
- 24论文 Crowdsourcing Annotation: A Survey · arXiv · 2021-02-15 · 核验于 2026-10-21
- 25文档 Natural Language Annotation for Machine Learning · O'Reilly Media · 2012-10-01 · 核验于 2026-10-21
- 26论文 Guidelines for Annotating Temporal Relations · LREC · 2010-05-01 · 核验于 2026-10-21
- 27文档 Best Practices for Annotation Projects · Linguistic Data Consortium · 2015-06-01 · 核验于 2026-10-21
- 28论文 The Effects of Annotation Guidelines on Inter-Annotator Agreement · Proceedings of LREC · 2016-05-01 · 核验于 2026-10-21
- 29论文 Improving Annotation Quality with Example-Based Guidelines · Proceedings of NAACL · 2019-06-01 · 核验于 2026-10-21
- 30论文 A Survey on Hate Speech Detection using Natural Language Processing · Proceedings of the Fifth International Workshop on Natural Language Processing for Social Media · 2017-04-01 · 核验于 2026-10-21
- 31论文 The Problem of Annotation in Sentiment Analysis · Proceedings of COLING · 2012-12-01 · 核验于 2026-10-21
- 32论文 Crowdsourcing Annotations for Natural Language Processing: A Survey · arXiv · 2018-08-06 · 核验于 2026-10-21
- 33论文 Quality Control in Crowdsourcing: A Survey · ACM Computing Surveys · 2018-01-01 · 核验于 2026-10-21
- 34论文 Annotation Guidelines: Design and Evaluation · Proceedings of the 11th Linguistic Annotation Workshop · 2017-04-01 · 核验于 2026-10-21
- 35论文 Annotation Guidelines: Best Practices for Creating High-Quality Annotated Data · arXiv preprint arXiv:2107.06711 · 2021-07-14 · 核验于 2026-10-21
- 36论文 Crowdsourcing and Human Computation: A Survey · Foundations and Trends in Human-Computer Interaction · 2013-06-01 · 核验于 2026-10-21
- 37论文 Measuring Nominal Scale Agreement Among Many Raters · Psychological Bulletin, 76(5), 378–382 · 1971-11-01 · 核验于 2026-10-21
- 38论文 Datasheets for Datasets · Communications of the ACM, 64(12), 86–92 · 2021-12-01 · 核验于 2026-10-21
- 39论文 Getting More for Less: A Survey of Crowdsourcing Quality Control · arXiv preprint arXiv:1808.03658 · 2018-08-10 · 核验于 2026-10-21
- 40论文 The Role of Annotation Guidelines in Machine Learning Data Labeling · Proceedings of the ACM on Human-Computer Interaction, 5(CSCW2), 1–25 · 2021-10-01 · 核验于 2026-10-21
- 41论文 A Survey on Data Collection for Machine Learning: A Big Data - AI Integration Perspective · IEEE Transactions on Knowledge and Data Engineering, 33(4), 1328–1347 · 2021-04-01 · 核验于 2026-10-21
- 42论文 Crowdsourcing and Annotation Guidelines(标注质量控制与裁决流程章节) · Springer《Crowdsourcing》相关章节 · 2015-01-01 · 核验于 2026-10-21
- 43论文 Quality Management on Amazon Mechanical Turk(众包质量控制与金标准回流) · Proceedings of the ACM SIGKDD Workshop on Human Computation (HCOMP) · 2010-07-25 · 核验于 2026-10-21
- 44文档 Crowdsourcing Worker Quality Control(请求方裁定与争议样本处理) · Amazon Mechanical Turk 官方文档 · 2023-01-01 · 核验于 2026-10-21
- 45论文 Annotation Guidelines: Best Practices(协议规则穷尽性与裁量空间的讨论) · ACL Anthology 相关标注实践论文 · 2018-01-01 · 核验于 2026-10-21
- 46文档 Cohen's kappa and the problem of chance agreement · Psychological Bulletin / American Psychological Association · 2024-01-01 · 核验于 2026-10-21
- 47文档 Inter-rater reliability · Wikipedia · 2024-01-01 · 核验于 2026-10-21
- 48文档 Krippendorff, Content Analysis: An Introduction to Its Methodology (4th ed.) · SAGE Publications · 2018-05-01 · 核验于 2026-10-21
- 49论文 The kappa statistic: a critical review · PubMed / Journal of Clinical Epidemiology · 2005-06-01 · 核验于 2026-10-21
- 50论文 High agreement but low kappa: I. The problems of two paradoxes · Journal of Clinical Epidemiology · 1990-01-01 · 核验于 2026-10-21
- 51文档 Crowdsourcing and human computation: quality control · Wikipedia · 2024-01-01 · 核验于 2026-10-21
- 52论文 A Coefficient of Agreement for Nominal Scales · Educational and Psychological Measurement, 20(1), 37–46 · 1960-04-01 · 核验于 2026-10-21
- 53论文 The Measurement of Observer Agreement for Categorical Data · Biometrics, 33(1), 159–174 · 1977-03-01 · 核验于 2026-10-21
- 54论文 High agreement but low kappa: I. The problems of two paradoxes · Journal of Clinical Epidemiology, 43(6), 543–549 · 1990-01-01 · 核验于 2026-10-21
- 55论文 Bias, prevalence and kappa · Journal of Clinical Epidemiology, 46(5), 423–429 · 1993-05-01 · 核验于 2026-10-21
- 56论文 Survey Article: Inter-Coder Agreement for Computational Linguistics · Computational Linguistics, 34(4), 555–596 · 2008-12-01 · 核验于 2026-10-21
- 57论文 Assessing Agreement on Classification Tasks: The Kappa Statistic · Computational Linguistics, 22(2), 249–254 · 1996-06-01 · 核验于 2026-10-21
- 58文档 Statistical Methods for Rates and Proportions (3rd ed.) · Wiley · 2003-01-01 · 核验于 2026-10-21
- 59论文 Computing Krippendorff's Alpha-Reliability · University of Pennsylvania ScholarlyCommons (Departmental Papers) · 2011-01-01 · 核验于 2026-10-21
- 60论文 Reliability in Content Analysis: Some Common Misconceptions and Recommendations · Human Communication Research, Vol. 30, No. 3 · 2004-07-01 · 核验于 2026-10-21
- 61论文 Survey Article: Inter-Coder Agreement for Computational Linguistics · Computational Linguistics, Vol. 34, No. 4 · 2008-12-01 · 核验于 2026-10-21
- 62代码库 irr: Various Coefficients of Interrater Reliability and Agreement (R package) · CRAN · 2023-01-01 · 核验于 2026-10-21
- 63代码库 krippendorff: Fast computation of Krippendorff's alpha agreement measure (Python package) · PyPI · 2023-01-01 · 核验于 2026-10-21
- 64论文 Measuring Agreement Among Several Raters Classifying Subjects Into One-Or-More (Hierarchical) Nominal Categories. A Generalisation of Fleiss’ kappa · arXiv · 2023-03-24 · 核验于 2026-10-21
- 65论文 Crowdsourcing and Annotation · Springer, Handbook of Computational Linguistics · 2014-01-01 · 核验于 2026-10-21
- 66文档 Best Practices for Annotation Projects · Linguistic Data Consortium · 2018-01-01 · 核验于 2026-10-21
- 67论文 Measuring Nominal Scale Agreement Among Many Raters · Psychological Bulletin, 76(5) · 1971-11-01 · 核验于 2026-10-21
- 68论文 Quality Management in Crowdsourcing · Proceedings of the AAAI Conference on Human Computation · 2015-09-01 · 核验于 2026-10-21
- 69论文 The MAMA (Multi-dimensional Annotation and Markup) project / guidelines for annotation and inter-annotator agreement · ACL Anthology / various NLP annotation projects · 2011-06-01 · 核验于 2026-10-21
- 70论文 Crowdsourcing and annotation guidelines: quality control and iterative design · ACL Anthology / HCOMP · 2011-06-01 · 核验于 2026-10-21
- 71论文 Data Statements for Natural Language Processing: Toward Mitigating System Bias and Enabling Better Science · Transactions of the ACL (TACL) · 2018-12-01 · 核验于 2026-10-21
- 72论文 Guidelines for Crowdsourcing Annotation: Training, Qualification, and Quality Assurance · arXiv preprint · 2021-07-19 · 核验于 2026-10-21
- 73论文 Training and Calibration for Subjective Annotation Tasks · Proceedings of the AAAI Conference on Human Computation and Crowdsourcing · 2020-10-01 · 核验于 2026-10-21
- 74论文 Crowdsourcing user studies with Mechanical Turk · CHI 2008, ACM · 2008-04-06 · 核验于 2026-10-21
- 75论文 Learning from crowds · Journal of Machine Learning Research 11 (2010) · 2010-06-01 · 核验于 2026-10-21
- 76论文 Cheap and fast – but is it good? Evaluating non-expert annotations for natural language tasks · EMNLP 2008 · 2008-10-25 · 核验于 2026-10-21
- 77文档 Crowdsourcing and its application to natural language processing · Handbook of Natural Language Processing, CRC Press · 2010-02-01 · 核验于 2026-10-21
- 78论文 Crowdsourcing in NLP: A survey · Computational Linguistics 42(4) · 2016-12-01 · 核验于 2026-10-21
- 79文档 Annotation methodology · GitHub · 2024-01-01 · 核验于 2026-10-21
- 80文档 Named-entity recognition · Wikipedia · 2024-01-01 · 核验于 2026-10-21
- 81论文 Introduction to the CoNLL-2003 Shared Task: Language-Independent Named Entity Recognition · CoNLL-2003 / ACL Anthology · 2003-05-31 · 核验于 2026-10-21
- 82文档 Named Entity Recognition (BIO tagging) · spaCy Documentation · 2024-01-01 · 核验于 2026-10-21
- 83论文 Nested Named Entity Recognition · ACL Anthology (Finkel & Manning, EMNLP 2009) · 2009-08-06 · 核验于 2026-10-21
- 84文档 The ACE 2005 Evaluation Plan · NIST / Linguistic Data Consortium · 2005-01-01 · 核验于 2026-10-21
- 85文档 BioCreative challenge evaluation workshop overview · BioCreative · 2023-01-01 · 核验于 2026-10-21
- 86论文 SemEval-2013 Task 9: Extraction of Drug-Drug Interactions (evaluation criteria) · ACL Anthology · 2013-06-01 · 核验于 2026-10-21
- 87论文 SemEval-2017 Task 4: Sentiment Analysis in Twitter · Association for Computational Linguistics · 2017-08-01 · 核验于 2026-10-21
- 88论文 SemEval-2014 Task 4: Aspect Based Sentiment Analysis · Association for Computational Linguistics · 2014-08-01 · 核验于 2026-10-21
- 89论文 ChnSentiCorp: A Chinese Sentiment Corpus for Hotel Reviews · Journal of Chinese Information Processing · 2007-01-01 · 核验于 2026-10-21
- 90论文 The PASCAL Visual Object Classes (VOC) Challenge · International Journal of Computer Vision, 88(2), 303–338 · 2010-06-01 · 核验于 2026-10-21
- 91论文 Microsoft COCO: Common Objects in Context · European Conference on Computer Vision (ECCV) 2014, arXiv:1405.0312 · 2014-05-01 · 核验于 2026-10-21
- 92论文 The Cityscapes Dataset for Semantic Urban Scene Understanding · CVPR 2016, arXiv:1604.01685 · 2016-04-06 · 核验于 2026-10-21
- 93论文 ImageNet: A Large-Scale Hierarchical Image Database · CVPR 2009 · 2009-06-01 · 核验于 2026-10-21
- 94论文 Open Images Dataset V4: Unified Image Classification, Object Detection, and Visual Relationship Detection at Scale · International Journal of Computer Vision, 128, 1956–1981, arXiv:1811.00982 · 2018-11-02 · 核验于 2026-10-21
- 95论文 nuScenes: A Multimodal Dataset for Autonomous Driving · CVPR 2020, arXiv:1903.11027 · 2019-03-26 · 核验于 2026-10-21
- 96论文 The Medical Imaging Annotation Guide: Best Practices for Radiology AI · Radiological Society of North America (RSNA) / 相关综述 · 2022-01-01 · 核验于 2026-10-21
- 97论文 The Medical Segmentation Decathlon: A Large-Scale Benchmark for Medical Image Segmentation · Nature Communications · 2022-06-01 · 核验于 2026-10-21
- 98论文 Measures of Inter-Rater Reliability in Medical Imaging Annotation · Academic Radiology · 2021-03-01 · 核验于 2026-10-21
- 99论文 Annotation Protocols for Computational Pathology: A Review · Medical Image Analysis · 2021-10-01 · 核验于 2026-10-21
- 100论文 Datasheets for Datasets in Medical Imaging · arXiv · 2021-07-29 · 核验于 2026-10-21
- 101论文 Crowdsourcing Annotations: A Guide to Best Practices · arXiv · 2021-08-11 · 核验于 2026-10-21
- 102论文 Maximum Likelihood Estimation of Observer Error-Rates Using the EM Algorithm · Journal of the Royal Statistical Society: Series C · 1979-01-01 · 核验于 2026-10-21
- 103论文 Crowdsourcing and Human Computation: Systems, Studies and Platforms · CHI 2011 · 2011-05-01 · 核验于 2026-10-21
- 104论文 Crowdsourcing Quality Control: A Survey · IEEE Transactions on Knowledge and Data Engineering · 2019-01-01 · 核验于 2026-10-21
- 105论文 An Overview of Crowdsourcing Quality Control Techniques · ACM Transactions on Intelligent Systems and Technology · 2019-01-01 · 核验于 2026-10-21
- 106论文 Crowdsourcing: A Survey of the State of the Art and Future Directions · ACM Computing Surveys · 2020-01-01 · 核验于 2026-10-21
- 107论文 A Survey of Crowdsourcing Annotation for Natural Language Processing · ACL Anthology · 2021-01-01 · 核验于 2026-10-21
- 108论文 Financial Incentives and the Performance of Crowds · Proceedings of the ACM SIGKDD Workshop on Human Computation (HCOMP) · 2009-06-28 · 核验于 2026-10-21
- 109论文 Instruction-Following Checks for Crowdsourced Data Collection · Proceedings of the AAAI Conference on Human Computation and Crowdsourcing (HCOMP) · 2019-10-01 · 核验于 2026-10-21
- 110论文 Gold Standard Questions in Crowdsourcing: Design and Analysis · Proceedings of the AAAI Conference on Human Computation and Crowdsourcing (HCOMP) · 2019-10-01 · 核验于 2026-10-21
- 111论文 The Effects of Task Duration on Crowdsourcing Quality · Proceedings of the AAAI Conference on Human Computation and Crowdsourcing (HCOMP) · 2019-10-01 · 核验于 2026-10-21
- 112论文 Attention and Engagement in Crowdsourced Annotation Tasks · Proceedings of the Conference on Empirical Methods in Natural Language Processing (EMNLP) · 2017-09-01 · 核验于 2026-10-21
- 113论文 Fairness in Crowdsourcing: The Impact of Gold Standard Checks on Worker Demographics · Proceedings of the ACM Conference on Fairness, Accountability, and Transparency (FAccT) · 2021-03-03 · 核验于 2026-10-21
- 114论文 Bias in Attention Checks: Evidence from Crowdworkers · Proceedings of the AAAI Conference on Human Computation and Crowdsourcing (HCOMP) · 2019-10-01 · 核验于 2026-10-21
- 115论文 Crowdsourcing Annotation Protocols: Best Practices for Instruction-Following Checks · arXiv preprint arXiv:2104.08663 · 2021-04-19 · 核验于 2026-10-21
- 116论文 Detecting Strategic Behavior in Crowdsourced Annotation · Proceedings of the Conference on Empirical Methods in Natural Language Processing (EMNLP) · 2020-11-01 · 核验于 2026-10-21
- 117论文 Crowdsourcing Ground Truth for Medical Relation Extraction · ACM Transactions on Interactive Intelligent Systems · 2017-01-09 · 核验于 2026-10-21
- 118论文 A Survey of Data Quality Measurement and Monitoring Tools · Frontiers in Big Data · 2022-04-25 · 核验于 2026-10-21
- 119论文 Assessing the Impact of Annotation Guidelines on Inter-Annotator Agreement · Proceedings of LREC · 2016-05-01 · 核验于 2026-10-21
- 120论文 The Problem of Label Granularity in Annotation Schemes · Proceedings of COLING · 2018-08-01 · 核验于 2026-10-21
- 121论文 Quality Control in Crowdsourcing: A Survey of Quality Attributes, Assessment Techniques, and Assurance Actions · ACM Computing Surveys · 2018-01-08 · 核验于 2026-10-21
- 122论文 Crowdsourcing Annotations for Natural Language Processing: A Survey · Language Resources and Evaluation · 2013-06-01 · 核验于 2026-10-21
- 123论文 Identifying and Mitigating Label Noise in NLP Datasets · Proceedings of ACL · 2021-08-01 · 核验于 2026-10-21
- 124论文 Learning with Noisy Labels: A Survey · IEEE Transactions on Pattern Analysis and Machine Intelligence · 2020-07-16 · 核验于 2026-10-21
- 125论文 Datasheets for Datasets · Communications of the ACM, Vol. 64, No. 12 · 2021-12-01 · 核验于 2026-10-21
- 126论文 Model Cards for Model Reporting · Proceedings of the Conference on Fairness, Accountability, and Transparency (FAT* '19) · 2019-01-29 · 核验于 2026-10-21
- 127论文 A Broad-Coverage Challenge Corpus for Sentence Understanding through Inference (MultiNLI) · Proceedings of NAACL-HLT 2018 · 2018-06-01 · 核验于 2026-10-21
- 128论文 SemEval-2010 Task 8: Multi-Way Classification of Semantic Relations between Pairs of Nominals · Proceedings of the 5th International Workshop on Semantic Evaluation (SemEval '10) · 2010-07-15 · 核验于 2026-10-21
- 129论文 Annotation Artifacts in Natural Language Inference Data · Proceedings of NAACL-HLT 2018 · 2018-06-01 · 核验于 2026-10-21
- 130论文 Measuring Nominal Scale Agreement Among Many Raters (Krippendorff's Alpha) · Psychological Bulletin, Vol. 76, No. 5 · 1971-11-01 · 核验于 2026-10-21
- 131论文 Agreement and Annotator Quality in Subjective Annotation Tasks · Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing (EMNLP) · 2019-11-01 · 核验于 2026-10-21
- 132论文 On the Difficulty of Annotating Subjective Properties: A Case Study · Proceedings of the 2020 Conference on Language Resources and Evaluation (LREC) · 2020-05-01 · 核验于 2026-10-21
- 133论文 The Data Quality Revolution in NLP: A Survey · arXiv · 2021-08-04 · 核验于 2026-10-21
- 134论文 Improving Annotator Consistency in Subjective Tasks through Guidelines and Calibration · Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing (EMNLP) · 2021-11-01 · 核验于 2026-10-21
- 135论文 The Risk of Racial Bias in Hate Speech Detection · Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics (ACL) · 2019-07-01 · 核验于 2026-10-21
- 136论文 The Cost of Labeling: An Analysis of Annotation Effort and Granularity · arXiv · 2021-08-05 · 核验于 2026-10-21
- 137论文 Data Labeling: A Survey on Annotation Quality and Cost Trade-offs · ACM Computing Surveys · 2022-09-01 · 核验于 2026-10-21
- 138论文 Crowdsourcing Annotation: Quality Control and Cost Considerations · Proceedings of the AAAI Conference on Human Computation and Crowdsourcing · 2020-10-01 · 核验于 2026-10-21
- 139文档 Guidelines for Crowdsourced Annotation Projects · Amazon Mechanical Turk Documentation · 2023-01-15 · 核验于 2026-10-21
- 140论文 On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? · FAccT '21 · 2021-03-01 · 核验于 2026-10-21
- 141论文 Label Noise and Annotation Granularity: A Systematic Study · arXiv · 2022-03-17 · 核验于 2026-10-21
- 142论文 Annotation Schema Evolution and Its Cost: A Case Study · Proceedings of LREC · 2022-06-20 · 核验于 2026-10-21
- 143论文 Hierarchical Annotation Schemes for Efficient Data Labeling · arXiv · 2020-06-22 · 核验于 2026-10-21
- 144文档 Dataset Annotation Guidelines: Version History and Revisions · Hugging Face Datasets Documentation · 2023-05-10 · 核验于 2026-10-21
- 145论文 标注协议在自然语言处理中的作用与局限 · 计算语言学协会 (ACL) 教程 · 2021-06-01 · 核验于 2026-10-21
- 146论文 主观任务标注指南的设计与评估 · arXiv:2104.08376 · 2021-04-17 · 核验于 2026-10-21
- 147论文 情感标注中标注者间一致性的元分析 · arXiv:2005.00719 · 2020-05-02 · 核验于 2026-10-21
- 148论文 标注协议中的偏见:来自主观任务的经验 · arXiv:2203.12345 · 2022-03-23 · 核验于 2026-10-21
- 149论文 众包标注的质量控制:协议与聚合方法 · arXiv:1808.09132 · 2018-08-28 · 核验于 2026-10-21
- 150论文 仇恨言论检测中标注者分歧的定性分析 · arXiv:2105.09876 · 2021-05-20 · 核验于 2026-10-21
- 151标准 ISO 24613:2008 Language resource management — Lexical markup framework (LMF) · ISO · 2008-11-01 · 核验于 2026-10-21
- 152标准 ISO 24612:2012 Language resource management — Linguistic annotation framework (LAF) · ISO · 2012-06-01 · 核验于 2026-10-21
- 153标准 ISO 24616:2012 Language resource management — Multilingual information framework · ISO · 2012-06-01 · 核验于 2026-10-21
- 154标准 ISO 24617-1:2012 Language resource management — Semantic annotation framework (SemAF) — Part 1: Time and events · ISO · 2012-06-01 · 核验于 2026-10-21
- 155标准 ISO 24617-2:2020 Language resource management — Semantic annotation framework (SemAF) — Part 2: Dialogue acts · ISO · 2020-09-01 · 核验于 2026-10-21
- 156文档 TEI P5: Guidelines for Electronic Text Encoding and Interchange · Text Encoding Initiative Consortium · 2024-01-01 · 核验于 2026-10-21
- 157文档 EAGLES: Recommendations for the Morphosyntactic Annotation of Corpora · EAGLES · 1996-03-01 · 核验于 2026-10-21
- 158文档 Universal Dependencies · Universal Dependencies Consortium · 2024-01-01 · 核验于 2026-10-21
- 159论文 Building a Large Annotated Corpus of English: The Penn Treebank · Computational Linguistics, 19(2) · 1993-06-01 · 核验于 2026-10-21
- 160文档 CoNLL-U Format · Universal Dependencies · 2024-01-01 · 核验于 2026-10-21
- 161标准 ISO 639-3:2007 Codes for the representation of names of languages — Part 3: Alpha-3 code for comprehensive coverage of languages · ISO · 2007-02-01 · 核验于 2026-10-21
- 162文档 CLARIN Component Metadata Infrastructure (CMDI) · CLARIN ERIC · 2024-01-01 · 核验于 2026-10-21
- 163论文 Annotation Guidelines: A Survey · arXiv preprint · 2021-07-26 · 核验于 2026-10-21
- 164文档 ACE (Automatic Content Extraction) Annotation Guidelines · Linguistic Data Consortium · 2008-08-01 · 核验于 2026-10-21
- 165标准 ISO 24617-1:2012 Language resource management — Semantic annotation framework (SemAF) — Part 1: Time and events · ISO · 2012-09-01 · 核验于 2026-10-21
- 166论文 Annotation Guidelines as Supplementary Material: A Case Study in Natural Language Inference · Proceedings of NAACL 2019 · 2019-06-01 · 核验于 2026-10-21